
結論先說
- 投餵線上日誌前先過一道本地脫敏篩子:用一行
sed或 Python 管道把手機號、電郵、JWT 令牌替換成<REDACTED>再通過管道傳給claude,既保住調用結構又不碰數據合規紅線。 - 查慢 SQL 光貼代碼沒用,必須連着
EXPLAIN ANALYZE執行計劃和表索引定義一起喂:讓模型親眼看到哪一步走了全表順序掃描(Seq Scan)或隱式類型轉換導致索引失效。 - 查內存泄漏嚴禁讓 AI「憑感覺猜哪裏漏了」:要求它鎖定未解綁的事件監聽、無上限增長的全局
Map或未關閉的流句柄,並寫出本地循環復現腳本看內存曲線是否拉平。 - 深度性能排障需要跨多層調用棧長鏈路推理:搭配高倍率額度池可在本站查看 Claude Max 充值說明 或支持自助兌換的 Claude Max 5x iOS 充值商品頁。
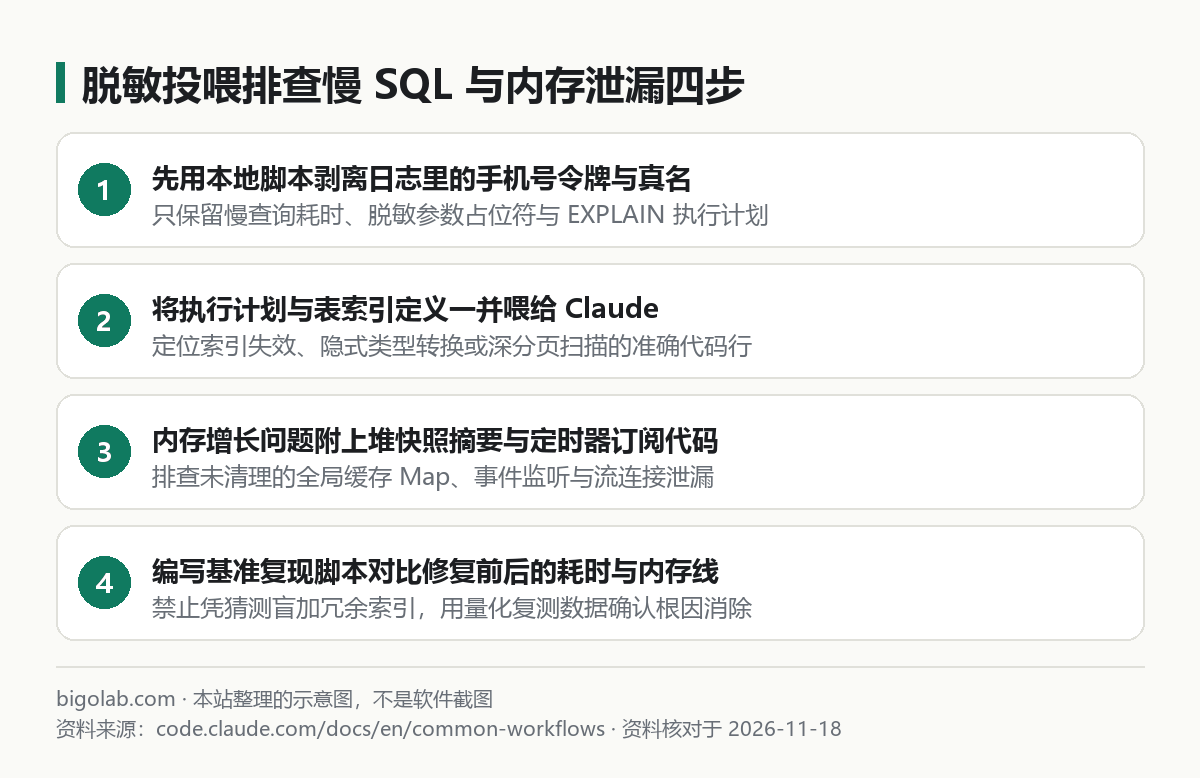
圖:本站結合 Claude Code 官方工作流文檔 整理的四步排障示意圖
本文根據 Anthropic Claude Code 官方文檔《Common workflows》《Security》(code.claude.com/docs/en/common-workflows)整理,資料核對於 2026-11-19。配圖為本站整理的示意圖,不是軟件截圖。本站(bigolab.com)不是 Anthropic 官方網站。
適用於誰
- 線上數據庫 CPU 突然飆滿、慢查詢日誌刷屏,面對幾百行嵌套 JOIN 和 ORM 代碼眼花繚亂的後端開發者;
- Node.js 或 Python 服務跑滿十幾個小時內存就一路漲到觸發容器 OOM Killed 重啟,找不到哪個全局對象沒釋放的工程師;
- 想利用管道把生產報錯餵給 Claude Code,又怕不小心把客戶手機號、Bearer Token 或數據庫密碼粘出去的團隊。
一、先脫敏再投餵:一行管道命令與證據材料表
Claude Code 原生支持標準輸入管道(例如 cat slow.log | claude -p "...")。在把線上摘出來的慢日誌或異常棧喂進去前(密鑰防讀取底線設定見 Claude Code 安全與密鑰保護配置),先在終端跑一遍脫敏過濾:
bash
# 剝離 Bearer 令牌、電郵與 11 位手機號後再通過管道交給 Claude 分析
sed -E \
  -e 's/Bearer [A-Za-z0-9._-]+/Bearer <REDACTED>/g' \
  -e 's/[A-Za-z0-9._%+-]+@[A-Za-z0-9.-]+\.[A-Za-z]{2,}/<EMAIL>/g' \
  -e 's/1[3-9][0-9]{9}/<PHONE>/g' \
  prod-slow-query.log | claude "分析這份脫敏慢查詢日誌中最耗時的前 3 類 SQL 並定位對應倉庫源碼位置"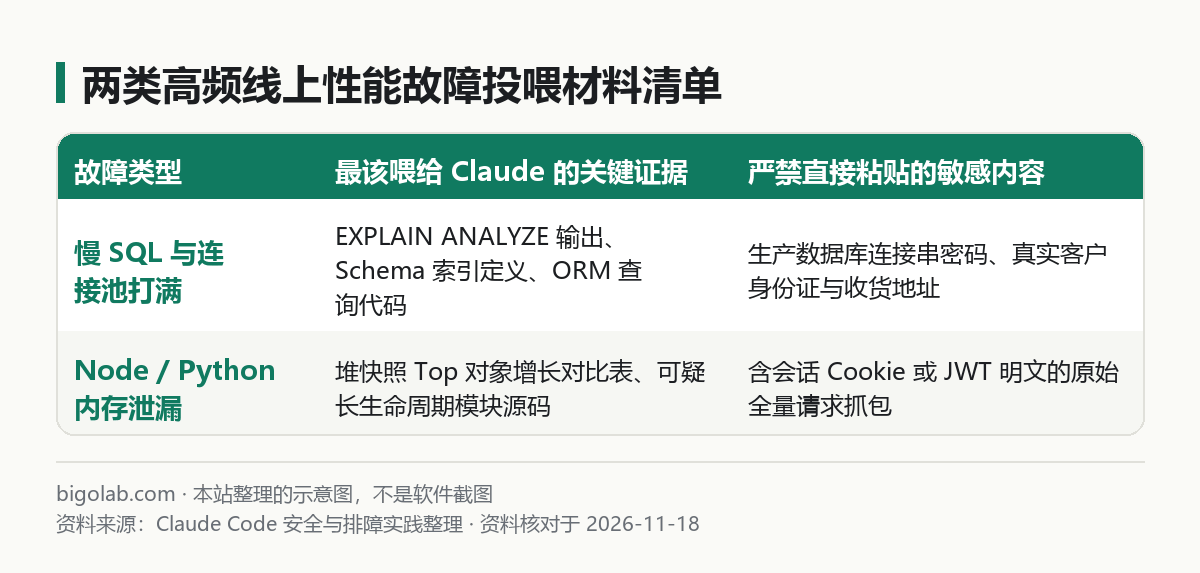
圖:本站整理的慢查詢與內存泄漏高價值投餵證據對照表
Claude Code 免上號訂閱與高配額省心方案:在大倉庫跑百萬上下文、多子包重構或複雜慢查詢排障時,固定月費訂閱比純按量 API 更容易鎖死成本上限。本站支持支付寶、微信支付與 AlipayHK 卡密自助兌換 iOS 鏈路的 Claude Pro 自助充值、5 倍額度的 Claude Max 5x 與頂配 Claude Max 20x,無需交出帳號密碼。
二、三段可直接複製的線上性能排障提示詞模板
1. 對照 EXPLAIN ANALYZE 根治慢 SQL 與 N+1 查詢
text
訂單列表接口在篩選近三個月數據時耗時超過 6 秒。我附上脫敏後的 EXPLAIN (ANALYZE, BUFFERS) 輸出結果以及 schema.prisma 表定義:
1. 請指出執行計劃中實際掃描行數最多的瓶頸節點,檢查是否存在函數包裹列、隱式字符集/類型轉換或最左前綴斷裂導致索引未命中;
2. 同步檢查 src/services/order.ts 中循環體裏是否混入了隱蔽的 N+1 關聯查詢;
3. 給出精確的複合索引字段順序建議與改寫後的查詢代碼,並說明新索引對寫入吞吐的潛在影響。
2. 排查 Node.js / Python 常駐進程內存緩慢泄漏(OOM)
text
我們的導出工作進程每運行約 8 小時內存就從 300MB 線性漲到 2GB 觸發容器 OOM,堆快照對比顯示 Buffer、Closure 與數組對象持續駐留未回收。
請重點掃描 src/workers/ 與 src/lib/cache/ 目錄:
1. 逐一核查是否存在未設淘汰上限(LRU/TTL)的模組級全局 Map/Dict、每次請求重複掛載但未 removeListener 的事件監聽器、未銷燬的定時器,或異常分支下未關閉的文件/響應流;
2. 按嫌疑高低列出具體文件行號與引用保持鏈;
3. 寫一個本地循環調用 500 次並打印 process.memoryUsage().heapUsed(或 Python tracemalloc)的最小壓測腳本,驗證修復前後內存能否穩定回落。
3. 排查高並發下數據庫連接池耗盡與死鎖等待
text
高峰期頻繁拋出連接池獲取超時(Timed out fetching a new connection from the connection pool)。
請全局審計所有開啟了顯式數據庫事務的代碼塊:查找是否存在在數據庫事務內部串行調用慢速第三方 HTTP 接口、長耗時文件上載,或 try/catch 分支遺漏釋放連接導致長事務佔滿連接池的代碼位置,並給出拆分事務邊界的重構方案。人工必查清單:AI 給出的索引建議上生產前,務必自己核對三件事——新複合索引是不是跟表上已有索引高度重疊浪費磁盤、字段區分度(Cardinality)低的布爾狀態列有沒有被錯放在最左第一列、以及本地複測壓測腳本在開啟垃圾回收後堆內存基線是否真正止住了爬升(搭配線上錯誤監控聯動另見 接入 Sentry MCP 排查報錯實戰 與 只讀數據庫 MCP 查詢指南)。
常見問題
問:線上崩潰日誌文件有 200MB 那麼大,能直接整份管道塞給 Claude Code 嗎?
答:千萬不要整份硬灌,不僅會瞬間撐爆上下文窗口,還會把配額燒光。先用 tail -n 500 或 grep -C 20 "ERROR" 把故障發生前後幾分鐘的關鍵窗口切出來脫敏投餵,大窗口使用邊界見 Claude Code 100 萬長上下文使用指南。
問:能不能直接把 Claude Code 連上生產主庫讓它自己跑 EXPLAIN?
答:絕對禁止連生產寫庫。就算要用 MCP 查表結構或執行計劃,也只准連備庫或脫敏只讀副本,並且嚴禁帶 ANALYZE 跑包含 UPDATE / DELETE 的寫語句(因為 EXPLAIN ANALYZE 會真實執行語句內容)。
問:智能體一口氣提議給表加五個新索引,該全盤照收嗎?
答:不要全收。每多建一個二級索引都會拖慢每一次 INSERT / UPDATE 的寫入速度並吃掉緩衝池內存,只保留經過執行計劃驗證能一針見血幹掉全表掃描的那一兩個核心索引即可,改庫安全規範見 安全執行數據庫遷移指南。
問:本地電腦就幾百條測試假數據,怎麼復現線上百萬行規模才暴露的慢查詢?
答:錶行數太少時數據庫優化器往往直接選全表掃描,看不出索引效果。你可以讓 Claude Code 在本地 Docker 測試庫裏用批量生成函數(如 PostgreSQL 的 generate_series)快速造出五十萬行符合真實偏斜分佈的脫敏仿真數據,跑完 ANALYZE 更新統計資訊後再對比優化前後的執行計劃耗時。
問:國內沒有海外銀行卡,怎麼給 Claude Code 開通 Pro 或 Max 訂閱最穩妥?
答:可在 Claude Code 訂閱說明頁 或 Claude Max 充值頁 選擇走蘋果 iOS 官方內購鏈路的自助卡密,自己複製登入憑證提交即可到賬,全程無需把密碼交給他人;若帳號偶發彈出身份核驗,也可查看 Claude KYC 人工協助(失敗不收費,封號不在質保範圍)。
相關教學
- Claude Code 安全配置:防止讀取 .env 密鑰與敏感文件
- 用 Claude Code 安全執行數據庫遷移(Prisma / Alembic)
- 用 Claude Code 接入 Sentry MCP 自動定位線上異常棧
- 用 Claude Code 接入數據庫 MCP 安全查詢數據與報表
- [Claude Code 100 萬長上下文(opus[1m] / sonnet[1m])適用場景](/guides/claude-code-1m-context-window-opus-sonnet)
0 條評論
還沒有評論,來搶沙發~