
結論先說
- 傳大體積音影片或長 PDF 必走
Files API(client.files.upload):單次內聯請求塞不下大媒體文件;通過 Files API 上載的文件會在谷歌服務端免費暫存最長 48 小時,拿到文件句柄即可反覆引用。 - 影片上載完不能馬上提問,必須先輪詢等待
PROCESSING結束:長影片需要幾秒到幾十秒提取幀與音軌,等state.name變為就緒狀態再往下走才不會報錯。 - 只問一兩次別開緩存;圍繞同一大文件連問五次以上必開
Context Caching:把幾十萬 Token 的影片和系統指令鎖進client.caches.create,後續追問只傳幾十字問題並附帶cached_content=cache.name,首字延遲和輸入 Token 單價雙雙大降。 - 用完隨手刪緩存或設短
ttl:顯式緩存預設存活 1 小時(3600s) 並按存活時長收存儲費,批處理跑完立即調client.caches.delete釋放最划算。 - 谷歌帳號與多工具訂閱直達入口:體驗 Jules 異步提 PR、Stitch 生 UI 與 AI Studio 需登入合規個人谷歌帳號,缺號可前往本站 谷歌帳號購買頁 選購 2FA 谷歌電郵成品號;跨平台開發與設計訂閱對比見 AI 會員充值中心。
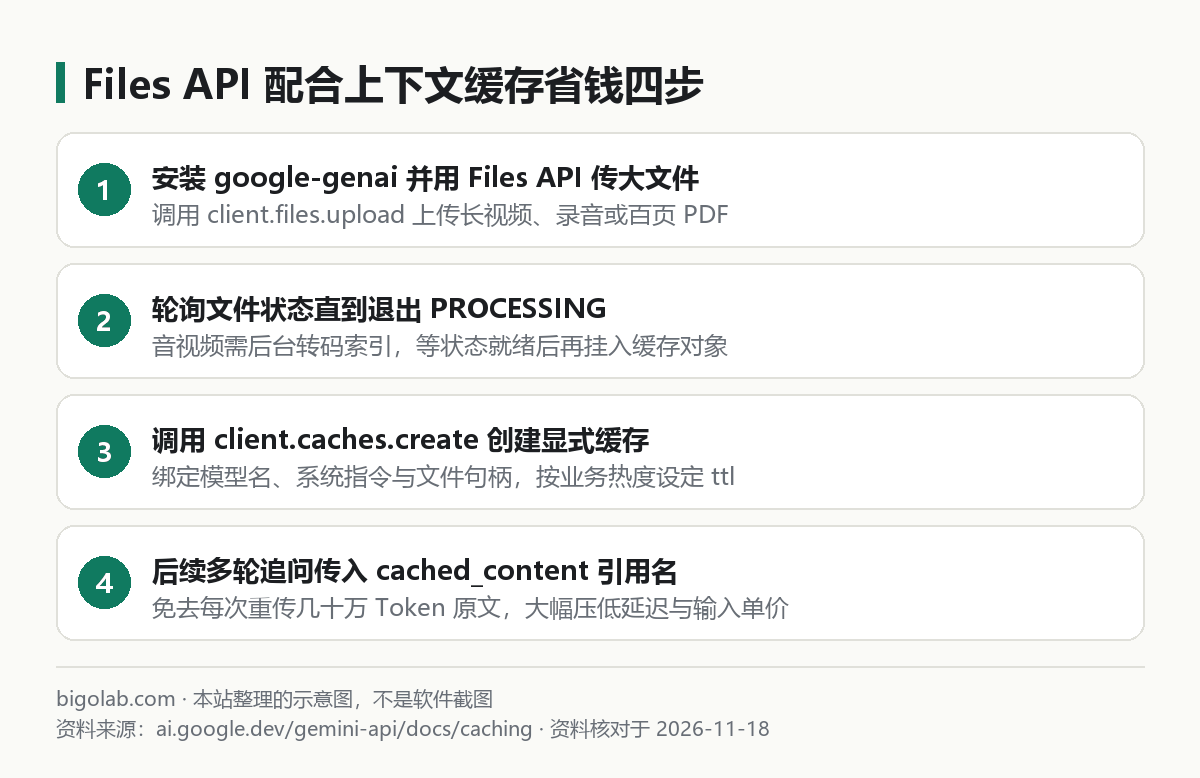
圖:本站根據 Gemini API 官方緩存文檔 整理的四步流程示意圖
本文根據 Google Gemini API 官方文檔(ai.google.dev/gemini-api/docs/caching、docs/files)整理,資料核對於 2026-11-18。配圖為本站整理的示意圖,不是介面截圖。本站(bigolab.com)不是 Google 官方網站。
適用於誰
- 要用代碼解析幾十分鐘的課程錄像、播客錄音或整本英文技術手冊,並圍繞這份材料連續追問十幾個問題的開發者;
- 剛上載完影片立刻調生成接口卻報錯失敗,不知道影片在後台有
PROCESSING轉碼狀態的工程師; - 想搞懂什麼時候該開顯式緩存(Context Caching)、怎麼設
ttl才不會被閒置存儲費反擼的人。
一、完整 Python 實戰代碼(上載輪詢 → 建緩存 → 多輪追問 → 釋放)
請認準官方現行維護的新版 google-genai SDK(安裝命令 pip install google-genai,基礎環境準備見 Gemini API Python 快速入門 與 Gemini API Key 獲取教學):
python
import pathlib
import time
from google import genai
from google.genai import types

# 初始化客戶端(預設自動讀取環境變量 GEMINI_API_KEY)
client = genai.Client(http_options={"api_version": "v1beta"})

# 1. 通過 Files API 上載長影片或大體積 PDF
video_path = pathlib.Path("tech_keynote_60min.mp4")
uploaded_file = client.files.upload(file=video_path)

# 2. 輪詢等待音影片後台轉碼完成(關鍵防報錯步驟)
while uploaded_file.state.name == "PROCESSING":
    time.sleep(3)
    uploaded_file = client.files.get(name=uploaded_file.name)

if uploaded_file.state.name != "ACTIVE":
    raise RuntimeError(f"文件處理未就緒,當前狀態: {uploaded_file.state.name}")

# 3. 創建顯式上下文緩存(存活期設為 10 分鐘 = 600s)
model_id = "models/gemini-2.5-flash"
cache = client.caches.create(
    model=model_id,
    config=types.CreateCachedContentConfig(
        display_name="keynote_video_cache",
        system_instruction="你是嚴謹的會議紀要分析助手,給出結論時請一併標註影片中的時間戳(MM:SS)。",
        contents=[uploaded_file],
        ttl="600s",
    ),
)

# 4. 多輪追問直接複用 cache.name,無需重傳整部影片
for question in [
    "按章節列出整場演講的核心發佈要點與對應時間戳。",
    "演講者在演示數據庫架構階段提到了哪些性能瓶頸數據?",
]:
    resp = client.models.generate_content(
        model=model_id,
        contents=question,
        config=types.GenerateContentConfig(cached_content=cache.name),
    )
    print(resp.text)

# 5. 任務全部跑完後主動刪除緩存,立即停止計算存儲時長費
client.caches.delete(name=cache.name)
如果你需要準備用於登入 Google AI Studio 開通 API 項目的個人谷歌帳號,或對比多廠商開發會員方案,可分別查看本站 谷歌帳號購買說明 與 AI 會員充值總覽頁。
二、什麼時候開顯式緩存最省錢(成本帳本對比)
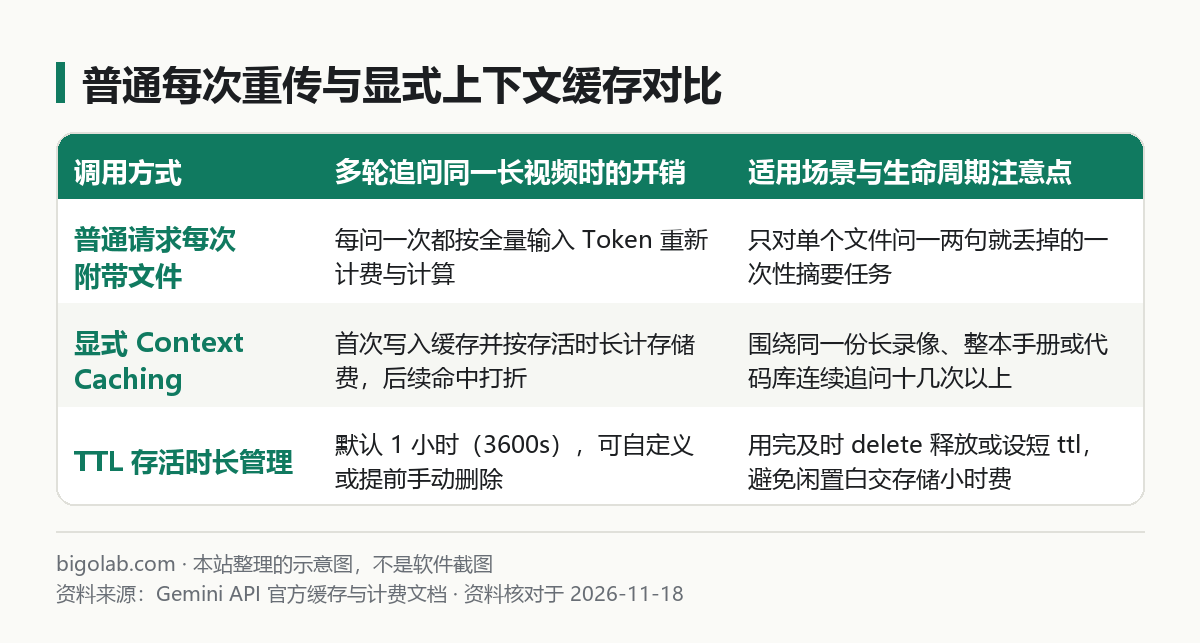
圖:本站根據 Gemini API 官方定價與緩存說明 整理的對比示意圖
為什麼不是所有請求都無腦套一層 caches.create?算清下面三條規則你就不會花冤枉錢:
- 有最低 Token 起步門檻:官方文檔規定,待緩存的內容總長度必須達到對應模型的最低 Token 下限(通常幾千到幾萬 Token 不等,短文本兩三百字調
caches.create會直接報參數不滿足門檻錯誤)。 - 存儲時長費 vs 命中折扣費的平衡點:顯式緩存由兩部分計費——「緩存命中時的折扣輸入單價」加上「按每小時每百萬 Token 計算的駐留存儲費」(最新費率口徑見 Gemini API 官方價格詳解)。如果一段長影片你只打算讓它總結一次就再也不問了,直接把
uploaded_file傳給generate_content就行,建緩存反而多付一小時存儲費;反之如果做成交互式問答機器人讓用戶連續問十幾個細節,開緩存能立省大半帳單。 - 動態續期與按需清理:如果用戶還在持續追問、眼看
ttl快到期了,可以通過client.caches.update延長過期時間;一旦會話關閉,立刻調delete銷燬。若在免費層測試時遇到緩存配額受限報錯,可對照 Gemini API 免費層速率與計費升級說明 檢查項目檔位。你也可以對比另一家主流接口的緩存設計思路,見 Claude API 提示詞緩存教學。
常見問題
問:Files API 上載的文件過了 48 小時會自動消失嗎?
答:會的。官方明確說明 Files API 是為模型推理設計的臨時文件中轉區,不是永久雲盤,上載滿 48 小時後服務端會自動清理,長期業務原件請儲存在你自己的對象存儲桶裏。
問:調用 generate_content 引用緩存時,還能在 GenerateContentConfig 裏再改一次 system_instruction 嗎?
答:不能重複覆蓋。系統指令(system_instruction)和固定工具聲明應當在創建緩存(CreateCachedContentConfig)那一刻一併封進去,後續每次生成請求只傳新增的用戶提問文本。
問:為什麼創建緩存時提示當前免費層不支持或報 429?
答:部分模型的顯式上下文緩存能力或高並發緩存總容量僅對已開啟付費結算(Pay-as-you-go)的項目開放,先去 AI Studio Dashboard 檢查項目是否已綁定有效計費層級。
問:註冊谷歌帳號卡在手機號驗證,或者國內沒有外幣卡怎麼配齊 AI 開發工具?
答:本站提供支持支付寶、微信支付與 AlipayHK 自動發卡的 谷歌電郵成品號(登入加固步驟見 谷歌帳號說明頁),同時支持自助獲取兌換碼開通 ChatGPT Plus 與 Claude Code 訂閱,支持開具增值稅發票。
0 條評論
還沒有評論,來搶沙發~