
結論先說
- 官方預訓練模式,客戶端本地執行:聲明
text_editor_20250728和bash_20250124時不需要自己寫冗長的input_schema,Claude 原生熟悉這套參數與行號修改規範,但真正的讀寫文件和跑 Shell 命令由你的後端程序執行並通過tool_result回傳。 - 兩者固定名稱一個字都不能改:文本編輯工具的
name固定為str_replace_based_edit_tool,命令行工具的name固定為bash。 - Bash 工具預期保持持久會話狀態:同一個任務循環內,上一輪執行的
cd切換目錄、export環境變量應當在下一輪繼續生效,直到模型主動傳入restart: true重置終端。 - 文本修改靠精確字符串替換防改崩:
str_replace要求待替換片段old_str在目標文件中恰好只匹配一處;匹配不到或匹配多處時,客戶端必須返回報錯讓模型補上下文重試,絕不能全量替換。 - 國內免卡開通與帳號服務入口:自有帳號免上號自助開通可見本站 Claude Pro 充值頁 與 Claude Max 充值頁;缺可用帳號或遇身份核驗可查看 Claude 註冊說明 與 Claude KYC 認證協助。
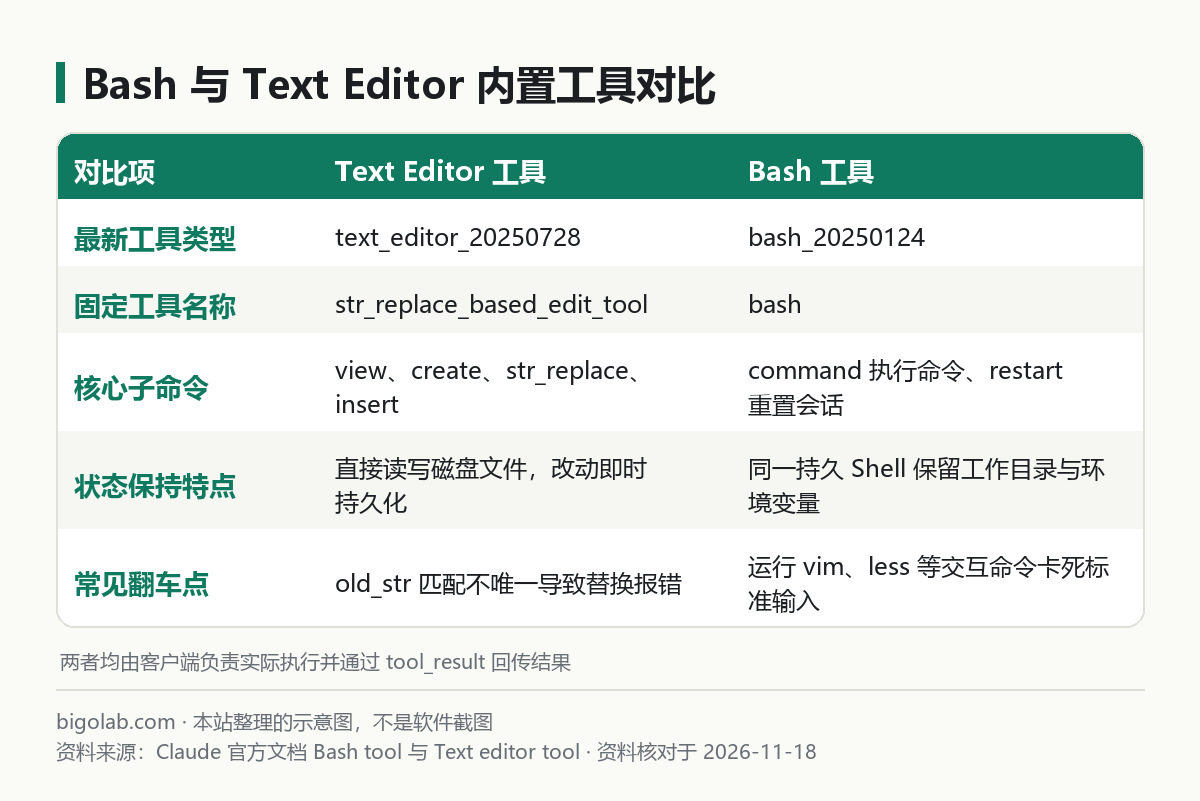
圖:本站根據 Claude 官方文檔:Text editor tool 與 Bash tool 整理的示意圖
本文根據 Claude 開發者平台官方文檔《Bash tool》《Text editor tool》整理,資料核對於 2026-11-18。配圖為本站整理的示意圖,不是介面截圖。本站(bigolab.com)不是 Anthropic 官方網站。
適用於誰
- 搜「claude api text editor tool」「claude bash tool 怎麼用」,正在自研編程智能體或自動化運維助手的開發者;
- 自己寫了文件讀寫函數,卻老遇到模型改錯行號、漏大括號或把長文件截斷重寫的人;
- 想分清客戶端內置工具(Bash + Text Editor)與服務端沙盒代碼執行工具區別的人。
如果你希望代碼直接跑在 Anthropic 託管的雲端容器裏而不在本地執行,請改看 /guides/claude-api-code-execution-tool。
一、標準請求寫法:把看改代碼與跑測試配成閉環
在軟件工程智能體裏,官方最推薦的組合是把 Text Editor(負責精確查看和改代碼)與 Bash(負責跑編譯、單測和 Git)同時放進 tools 數組。當前主流模型直接調用即可,無需再加額外的 anthropic-beta 請求頭:
python
import anthropic

client = anthropic.Anthropic()

response = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=4096,
    tools=[
        {
            "type": "text_editor_20250728",
            "name": "str_replace_based_edit_tool",
            "max_characters": 10000,
        },
        {
            "type": "bash_20250124",
            "name": "bash",
        },
    ],
    messages=[
        {"role": "user", "content": "查看 src/utils.py 裏的除零報錯,修復後運行 pytest 驗證。"}
    ],
)
其中 max_characters 是 text_editor_20250728 支持的可選參數,用於提示和控制查看大文件時的單次字符截斷上限,防止模型一上來讀進幾萬行構建產物撐爆上下文(基礎工具回傳循環見 /guides/claude-tool-use-basics)。
二、Text Editor 四大子命令與客戶端實現要點
當模型調用 str_replace_based_edit_tool 時,輸出的 input 會攜帶 command 字段。在 text_editor_20250728 版本中,你需要實現以下四個子命令分支(早期版本里的 undo_edit 已被移除):
view(查看文件或列出目錄):傳入path和可選的view_range(如[1, 80],從第 1 行起算,末位填-1代表讀到文件末尾)。如果path是目錄,返回目錄下的非隱藏文件列表;如果是文件,務必在每行前面拼上行號返回(例如1: import os),模型後續調用insert全靠這套行號定位;create(新建文件):傳入path與完整內容file_text。為防模型無意覆蓋已有業務源碼,若目標文件已存在,建議在客戶端攔截或先提示先讀再改;str_replace(精確字符串替換):傳入path、old_str和new_str。客戶端讀取文件後統計old_str出現次數:等於 0 次返回「未找到匹配文本,請檢查縮進與空格」;大於 1 次返回「匹配到多處,請在old_str中多帶幾行前後上下文確保唯一」;恰好 1 次才執行替換並落盤,同時把is_error: True留給前兩種異常情況;insert(按行號插入):傳入path、insert_line與new_str,在指定行號之後插入新文本(傳0代表插在文件最開頭)。
Claude 會員充值與成品號提示:國內銀行卡在結帳頁被拒時,可通過本站支付寶、微信支付或 AlipayHK 獲取 iOS 訂閱卡密自助開通 Claude Pro 或高配額 Claude Max(全程無需上號交密碼);需要現成帳號可了解 Claude Pro 成品號 與 Claude Max 5x 成品號(注:Anthropic 消費者條款禁止共享轉讓帳號且違規可終止無退款,成品號均明確標註不質保封號)。
三、Bash 狀態保持機制與防卡死設計
模型調用 bash 工具時,輸入只有兩種形態:傳 {"command": "pytest -q"} 執行命令,或傳 {"restart": true} 要求重啟一個乾淨的 Shell 進程。客戶端落地時要注意三個工程細節:
- 怎麼保持狀態:不要每收到一次請求就調無狀態的
subprocess.run()完事,否則模型上一輪執行了cd backend && source .venv/bin/activate,下一輪又回到根目錄,虛擬環境也沒了。標準做法是維護一個綁定當前會話的常駐/bin/bash子進程或容器連接,收到restart: true時再銷燬重建; - 嚴防交互式命令掛死標準輸入:模型偶爾會寫出
vim、less、top、不帶-y的安裝命令或一直監聽端口的npm run dev。客戶端必須給單次命令加上硬超時(如 30 到 120 秒),超時後終止進程組並把已捕獲的stdout/stderr連同超時提示返回給模型; - 截斷超長標準輸出:一次
cat大日誌或打印巨型堆棧可能吐出幾兆文本,回傳tool_result前應在客戶端做頭尾保留截斷。
四、客戶端安全邊界與現成替代方案
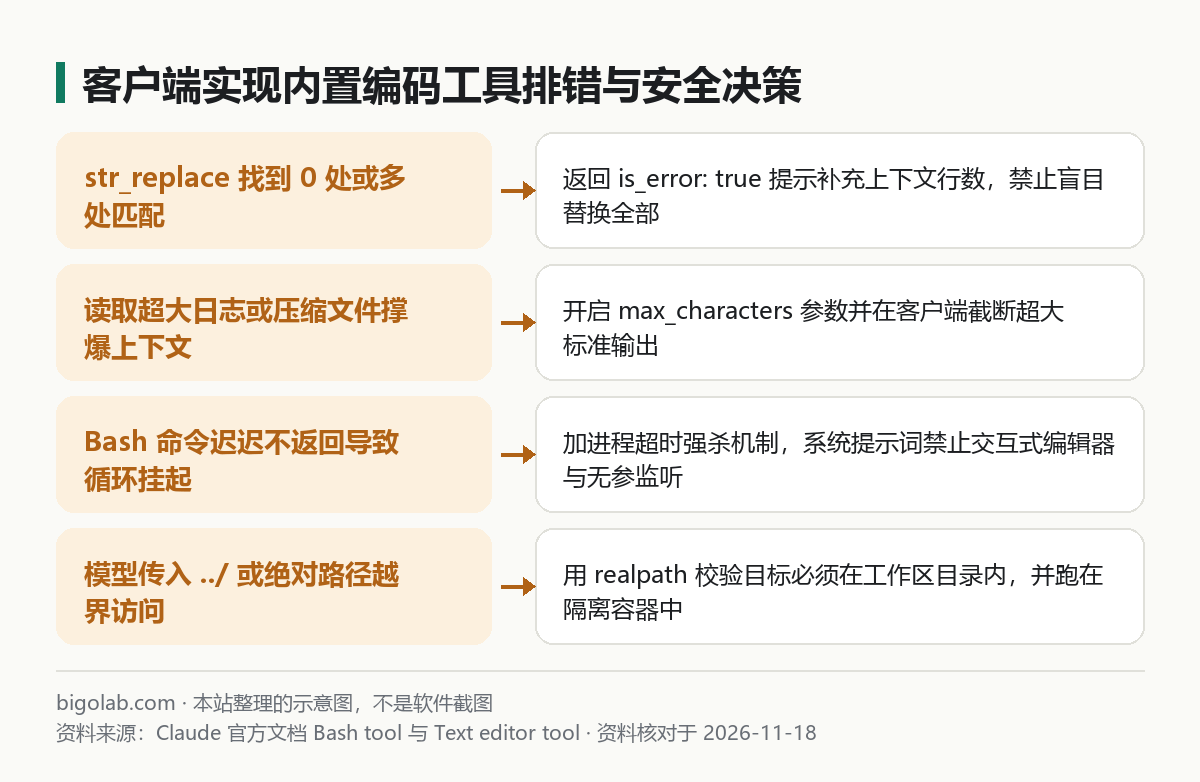
圖:本站根據 Claude 官方文檔:Bash tool 與 Text editor tool 整理的示意圖
因為這兩個工具直接碰觸文件系統與操作系統命令,上線前必須守住三條安全邊界:
- 路徑規範化防目錄穿越:對模型傳入的所有
path先做Path.resolve()規範化解析,嚴格校驗最終真實路徑落在允許的項目根目錄之內,並且顯式拉黑.env、私鑰目錄與憑證文件; - 容器沙箱與高危命令攔截:多租戶或無人值守場景必須在受限 Docker 容器、微虛擬機或 OS 級沙箱中執行 Bash,對
rm -rf、修改權限、訪問內網元數據地址等高危命令加前置審批; - 寫文件前留好回退快照:既然新版編輯工具去掉了內置撤銷動作,建議客戶端在每次
str_replace前做內存備份或基於 Git 工作樹留存檢查點。
如果你不想從零手寫持久 Shell、行號拼接與權限攔截代碼,直接用官方封裝好整套工具鏈的 /guides/claude-agent-sdk-quickstart 或終端編程工具會省下大量底座開發工作;需要開通官方終端訂閱額度時,也可以參考本站 Claude Code 充值頁 的套餐說明。
常見問題
問:為什麼我把 name 改成了 my_file_editor 後,請求直接報 400 錯誤?
答:官方內置模式工具的名稱與內部訓練詞綁定,不允許自定義改名。text_editor_20250728 必須配 "name": "str_replace_based_edit_tool",bash_20250124 必須配 "name": "bash"。
問:Windows 伺服器上沒有 /bin/bash,能用 bash_20250124 工具嗎?
答:模型針對該工具生成的語法預設是標準 Linux / POSIX Bash 命令(如 grep、sed、正斜槓路徑)。在 Windows 環境下建議把執行器放進 WSL2 或 Linux Docker 容器中運行,直接丟給 PowerShell 會頻繁出現語法報錯。
問:模型頻繁報 str_replace 找不到 old_str 怎麼緩解?
答:常見原因是換行符(CRLF 與 LF 混用)或製表符縮進不一致,以及模型沒先調用 view 就憑記憶盲改。客戶端讀取文件時可統一將換行符標準化為 \n,並在報錯文本里提醒模型先用 view 查看目標行附近最新內容。
問:人在國內沒有外幣信用卡,怎麼訂閱或升級 Claude 付費套餐?
答:可在本站 AI 會員充值總覽頁 選擇 Claude Pro 自助充值 或 Claude Max 充值,付款後即時發卡密、24 小時自助兌換且可開具增值稅發票;實時價格與售後邊界(含封號不質保)以商品頁當天展示為準。
相關教學
- Claude Tool Use(工具調用 / Function Calling)入門:定義工具與返回 tool_result
- Claude API 代碼執行工具(code execution)怎麼用
- Claude Agent SDK 入門:是什麼、怎麼裝、第一個智能體
- Claude Code 沙箱(sandbox)是什麼:限制命令讀寫與網絡訪問
參考資料
- Claude 開發者平台文檔:Bash tool — https://platform.claude.com/docs/en/agents-and-tools/tool-use/bash-tool
- Claude 開發者平台文檔:Text editor tool — https://platform.claude.com/docs/en/agents-and-tools/tool-use/text-editor-tool
0 條評論
還沒有評論,來搶沙發~