
結論先說
- LangGraph 不需要改任何節點內部業務代碼就能接上 Langfuse:只需在調用
graph.invoke或astream時,通過config={"callbacks": [langfuse_handler]}傳入回調處理器。 - 注意新版導入路徑變化:Langfuse Python SDK 新版統一從
from langfuse.langchain import CallbackHandler導入,自動把整張狀態圖的節點跳轉、條件分支與工具調用串成一棵完整的嵌套調用樹(Trace)。 - 一次性命令行腳本退出前務必調用刷新(Flush):Langfuse 預設在後台異步批量上報日誌,腳本跑完立刻退出進程會導致隊列裏的數據還沒發出去就被掐斷。
- 企業內網合規零改造切換:代碼完全不變,只需把環境變量
LANGFUSE_HOST從官方雲地址改成你們內網自建的 Langfuse 地址,敏感提示詞就絕不出內網。
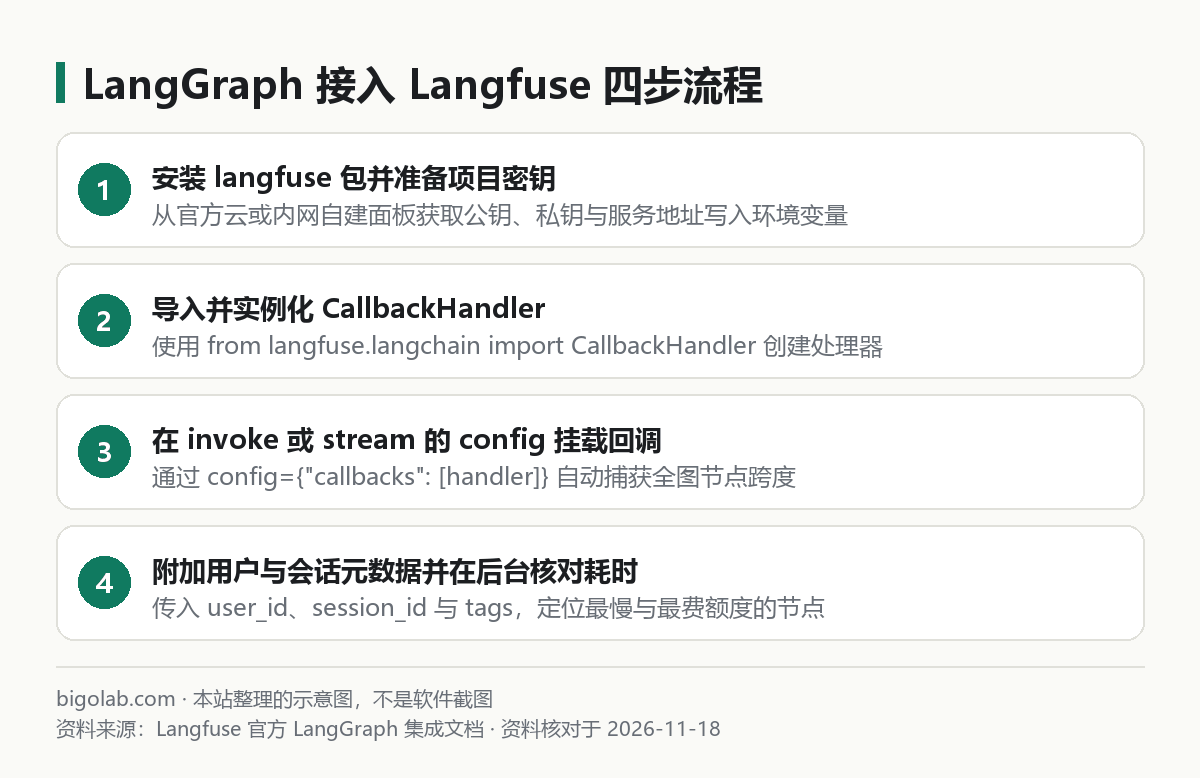
圖:本站根據 Langfuse 官方 LangGraph 集成文檔 整理的示意圖
本文根據 Langfuse 官方 LangChain / LangGraph 集成文檔與開源倉庫說明整理,核對日期 2026-11-18。配圖為本站整理的示意圖,不是介面截圖。本站(bigolab.com)不是 Langfuse 或 LangChain 官方網站。
適用於誰
- 搜「langgraph 使用 langfuse」「langgraph 接入開源鏈路追蹤」的人;
- 選擇了免費開源庫自建部署(計費對比見 /guides/langgraph-pricing-open-source-vs-platform),需要一套能私有化部署在內網、看清每個節點耗時和 Token 帳單的可觀測面板的後端團隊;
- 配完回調運行腳本後,發現 Langfuse 後台空空如也、一條記錄都沒收到的開發者。
如果你還在開發期做單步改狀態調試,優先用本地 Studio(見 /guides/langgraph-debug-visualize-studio-guide);上了測試和生產環境監控真實用戶請求,就輪到 Langfuse 上場了。
一、第一步:安裝依賴與配置三項環境變量
在已經裝好 langgraph(基礎環境見 /guides/langgraph-quickstart-install-first-graph)的虛擬環境裏安裝 langfuse:
bash
pip install -U langfuse langgraph langchain-openai
登入 Langfuse 後台(官方雲或你們自己的私有實例)創建一個項目,拿到公鑰和私鑰後寫入系統環境變量或 .env 文件:
bash
export LANGFUSE_PUBLIC_KEY="pk-lf-你的公鑰"
export LANGFUSE_SECRET_KEY="sk-lf-你的私鑰"
# 歐區預設雲、美區雲或內網自建地址按實際項目填寫:
export LANGFUSE_HOST="https://cloud.langfuse.com"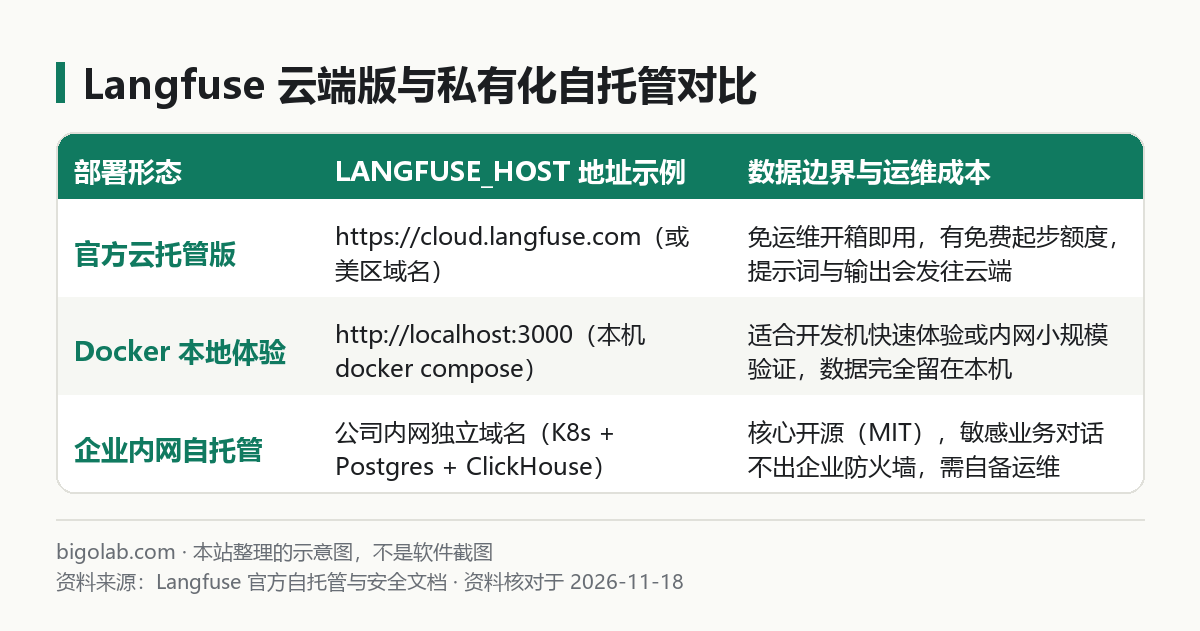
圖:本站根據 Langfuse 官方自託管與安全文檔 整理的示意圖
二、第二步:掛載 CallbackHandler 追蹤完整狀態圖
無需給每個 Python 節點函數挨個加裝飾器,LangGraph 在運行期會自動把頂層 config 裏的 callbacks 向下透傳給圖裏的所有大模型調用、ToolNode 工具執行以及嵌套子圖。
python
from langchain_core.tools import tool
from langchain_openai import ChatOpenAI
from langgraph.graph import StateGraph, MessagesState, START, END
from langgraph.prebuilt import ToolNode, tools_condition
from langfuse import get_client
from langfuse.langchain import CallbackHandler

@tool
def check_order_status(order_id: str) -> str:
    """查詢指定訂單號的物流狀態。"""
    return f"訂單 {order_id} 已發出,預計明日送達"

tools = [check_order_status]
llm = ChatOpenAI(model="gpt-4o-mini", temperature=0).bind_tools(tools)

def agent_node(state: MessagesState):
    return {"messages": [llm.invoke(state["messages"])]}

builder = StateGraph(MessagesState)
builder.add_node("agent", agent_node)
builder.add_node("tools", ToolNode(tools))
builder.add_edge(START, "agent")
builder.add_conditional_edges("agent", tools_condition)
builder.add_edge("tools", "agent")
graph = builder.compile()

if __name__ == "__main__":
    # 1. 初始化回調處理器(自動讀取環境變量中的密鑰)
    langfuse_handler = CallbackHandler()

    # 2. 在調用圖時通過 config 注入 callbacks 與業務元數據
    res = graph.invoke(
        {"messages": [("user", "幫我查一下訂單 ORD-8899 到哪了")]},
        config={
            "callbacks": [langfuse_handler],
            "metadata": {
                "langfuse_user_id": "user_42",
                "langfuse_session_id": "chat_thread_001",
                "langfuse_tags": ["order-bot", "prod"],
            },
        },
    )
    print(res["messages"][-1].content)

    # 3. 短生命週期腳本退出前強制把緩衝區日誌發完
    get_client().flush()
跑完打開 Langfuse 後台的 Traces 列表,點開最新一條記錄,你就能清晰看到頂層 LangGraph 下面依次掛着 agent 首次推理、tools 調用 check_order_status 的入參返回值、以及 agent 第二次彙總回覆的耗時與 Token 明細。
三、多輪對話歸組與成本審計技巧
在真實多 Agent 生產系統裏,光抓單次請求還不夠,建議把下面兩項配置一起用上:
- 把 LangGraph 的
thread_id同步傳給langfuse_session_id:當你的圖開啟了檢查點多輪對話記憶時,把同一個對話線程 ID 同時賦給configurable.thread_id和metadata.langfuse_session_id,後台就能在 Sessions 視圖裏把用戶連續十輪追問按時間線串在一起回看; - 用模型單價表定位高消耗節點:多智能體循環最怕某個子代理暗中跑了十幾次重試燒光預算(原因拆解見 /guides/multi-agent-token-cost-why-high-how-to-control)。在 Langfuse 後台按節點名稱篩選平均耗時與累計 Token,一眼就能揪出最該降級為輕量模型或加緩存的瓶頸節點。
日常在個人工作站調試多節點提示詞並對照官方雲端模型輸出質素時,如需了解個人 Claude 或 ChatGPT 訂閱方案,也可參考 /chongzhi/claude-pro 的整理說明。
常見問題
Q:運行沒有報錯,但 Langfuse 面板裏一直看不到任何 Trace 數據?
按三步排查:第一,檢查是不是跑完腳本直接退出了進程但漏寫了 get_client().flush()(常駐 FastAPI 服務不需要每次手動 flush,但單次測試腳本必須加);第二,核對 LANGFUSE_HOST 區服是否填錯(官方歐洲預設區和美國區地址不同,填反會鑑權失敗);第三,確認虛擬環境裏沒有同時開啟衝突的 OpenTelemetry 導出器攔截。
Q:從舊版 Langfuse v2 升級到 v3 後報 ModuleNotFoundError: No module named 'langfuse.callback' 怎麼辦?
v3 重構了底層採集架構,把導入語句改成 from langfuse.langchain import CallbackHandler,並將原本傳在 CallbackHandler(...) 構造函數里的 user_id、session_id 移到 graph.invoke 的 config["metadata"] 裏即可平滑遷移。
Q:生產環境裏可以把測試集評測(Prompt Management 與 Datasets)也和狀態圖連起來嗎?
可以。你可以在 Langfuse 面板裏把線上真實出錯的某條用戶消息一鍵加入測試數據集(Dataset),修改節點提示詞或切換底層模型後批量重跑整張狀態圖,客觀對比新舊版本在耗時、費用和回答準確率上的變化,不用靠人工憑感覺盲調。
相關教學
- /guides/langgraph-quickstart-install-first-graph:LangGraph Python 安裝與第一個狀態圖
- /guides/langgraph-debug-visualize-studio-guide:LangGraph Studio 可視化調試指南
- /guides/langgraph-pricing-open-source-vs-platform:LangGraph 開源庫與商業平台收費邊界
- /guides/multi-agent-token-cost-why-high-how-to-control:多 Agent 系統 Token 膨脹根源與控費
參考資料
- Langfuse 官方文檔:LangChain & LangGraph Integration — https://langfuse.com/integrations/frameworks/langchain
langfuse/langfuse官方開源倉庫 — https://github.com/langfuse/langfuse
0 條評論
還沒有評論,來搶沙發~