
结论先说
- 投喂线上日志前先过一道本地脱敏筛子:用一行
sed或 Python 管道把手机号、邮箱、JWT 令牌替换成<REDACTED>再通过管道传给claude,既保住调用结构又不碰数据合规红线。 - 查慢 SQL 光贴代码没用,必须连着
EXPLAIN ANALYZE执行计划和表索引定义一起喂:让模型亲眼看到哪一步走了全表顺序扫描(Seq Scan)或隐式类型转换导致索引失效。 - 查内存泄漏严禁让 AI「凭感觉猜哪里漏了」:要求它锁定未解绑的事件监听、无上限增长的全局
Map或未关闭的流句柄,并写出本地循环复现脚本看内存曲线是否拉平。 - 深度性能排障需要跨多层调用栈长链路推理:搭配高倍率额度池可在本站查看 Claude Max 充值说明 或支持自助兑换的 Claude Max 5x iOS 充值商品页。
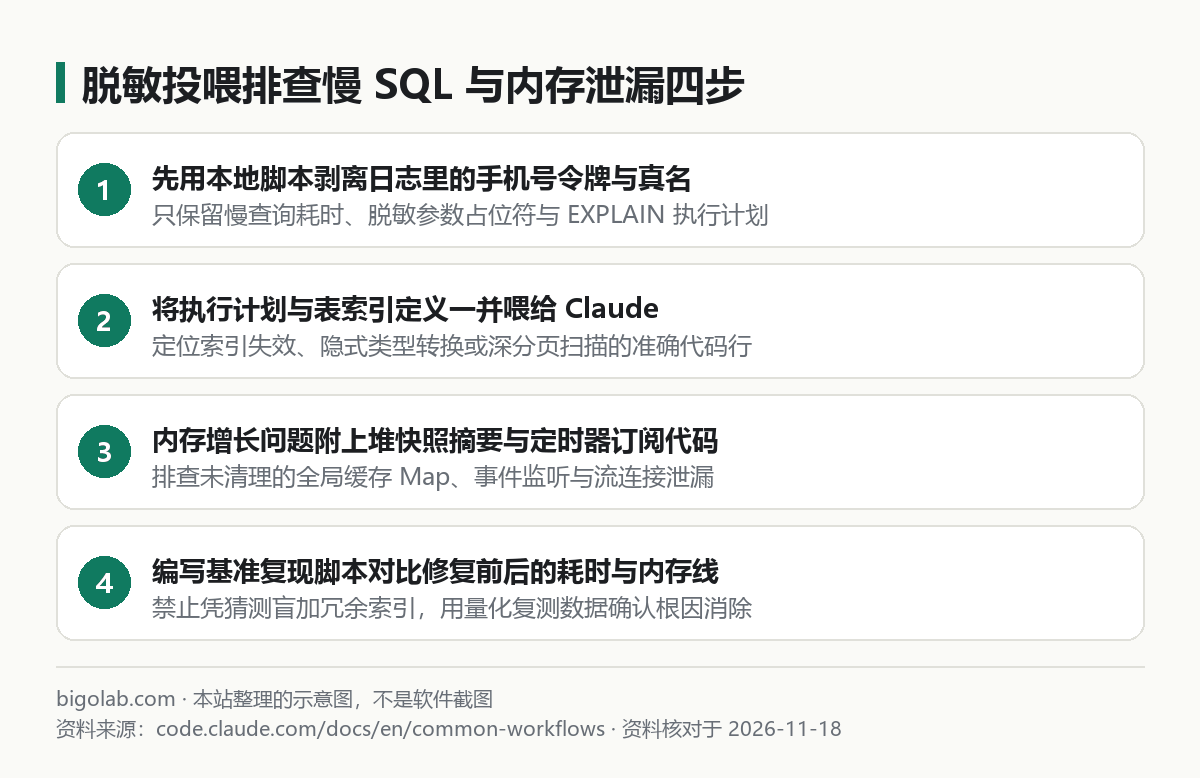
图:本站结合 Claude Code 官方工作流文档 整理的四步排障示意图
本文根据 Anthropic Claude Code 官方文档《Common workflows》《Security》(code.claude.com/docs/en/common-workflows)整理,资料核对于 2026-11-19。配图为本站整理的示意图,不是软件截图。本站(bigolab.com)不是 Anthropic 官方网站。
适用于谁
- 线上数据库 CPU 突然飙满、慢查询日志刷屏,面对几百行嵌套 JOIN 和 ORM 代码眼花缭乱的后端开发者;
- Node.js 或 Python 服务跑满十几个小时内存就一路涨到触发容器 OOM Killed 重启,找不到哪个全局对象没释放的工程师;
- 想利用管道把生产报错喂给 Claude Code,又怕不小心把客户手机号、Bearer Token 或数据库密码粘出去的团队。
一、先脱敏再投喂:一行管道命令与证据材料表
Claude Code 原生支持标准输入管道(例如 cat slow.log | claude -p "...")。在把线上摘出来的慢日志或异常栈喂进去前(密钥防读取底线设置见 Claude Code 安全与密钥保护配置),先在终端跑一遍脱敏过滤:
bash
# 剥离 Bearer 令牌、邮箱与 11 位手机号后再通过管道交给 Claude 分析
sed -E \
  -e 's/Bearer [A-Za-z0-9._-]+/Bearer <REDACTED>/g' \
  -e 's/[A-Za-z0-9._%+-]+@[A-Za-z0-9.-]+\.[A-Za-z]{2,}/<EMAIL>/g' \
  -e 's/1[3-9][0-9]{9}/<PHONE>/g' \
  prod-slow-query.log | claude "分析这份脱敏慢查询日志中最耗时的前 3 类 SQL 并定位对应仓库源码位置"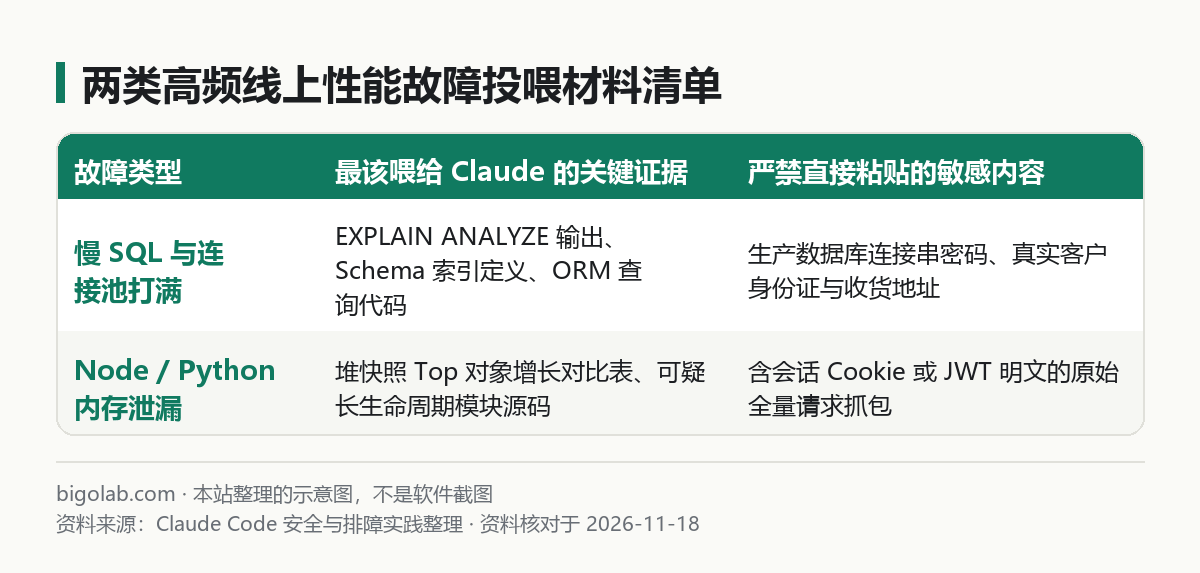
图:本站整理的慢查询与内存泄漏高价值投喂证据对照表
Claude Code 免上号订阅与高配额省心方案:在大仓库跑百万上下文、多子包重构或复杂慢查询排障时,固定月费订阅比纯按量 API 更容易锁死成本上限。本站支持支付宝、微信支付与 AlipayHK 卡密自助兑换 iOS 链路的 Claude Pro 自助充值、5 倍额度的 Claude Max 5x 与顶配 Claude Max 20x,无需交出账号密码。
二、三段可直接复制的线上性能排障提示词模板
1. 对照 EXPLAIN ANALYZE 根治慢 SQL 与 N+1 查询
text
订单列表接口在筛选近三个月数据时耗时超过 6 秒。我附上脱敏后的 EXPLAIN (ANALYZE, BUFFERS) 输出结果以及 schema.prisma 表定义:
1. 请指出执行计划中实际扫描行数最多的瓶颈节点,检查是否存在函数包裹列、隐式字符集/类型转换或最左前缀断裂导致索引未命中;
2. 同步检查 src/services/order.ts 中循环体里是否混入了隐蔽的 N+1 关联查询;
3. 给出精确的复合索引字段顺序建议与改写后的查询代码,并说明新索引对写入吞吐的潜在影响。
2. 排查 Node.js / Python 常驻进程内存缓慢泄漏(OOM)
text
我们的导出工作进程每运行约 8 小时内存就从 300MB 线性涨到 2GB 触发容器 OOM,堆快照对比显示 Buffer、Closure 与数组对象持续驻留未回收。
请重点扫描 src/workers/ 与 src/lib/cache/ 目录:
1. 逐一核查是否存在未设淘汰上限(LRU/TTL)的模块级全局 Map/Dict、每次请求重复挂载但未 removeListener 的事件监听器、未销毁的定时器,或异常分支下未关闭的文件/响应流;
2. 按嫌疑高低列出具体文件行号与引用保持链;
3. 写一个本地循环调用 500 次并打印 process.memoryUsage().heapUsed(或 Python tracemalloc)的最小压测脚本,验证修复前后内存能否稳定回落。
3. 排查高并发下数据库连接池耗尽与死锁等待
text
高峰期频繁抛出连接池获取超时(Timed out fetching a new connection from the connection pool)。
请全局审计所有开启了显式数据库事务的代码块:查找是否存在在数据库事务内部串行调用慢速第三方 HTTP 接口、长耗时文件上传,或 try/catch 分支遗漏释放连接导致长事务占满连接池的代码位置,并给出拆分事务边界的重构方案。人工必查清单:AI 给出的索引建议上生产前,务必自己核对三件事——新复合索引是不是跟表上已有索引高度重叠浪费磁盘、字段区分度(Cardinality)低的布尔状态列有没有被错放在最左第一列、以及本地复测压测脚本在开启垃圾回收后堆内存基线是否真正止住了爬升(搭配线上错误监控联动另见 接入 Sentry MCP 排查报错实战 与 只读数据库 MCP 查询指南)。
常见问题
问:线上崩溃日志文件有 200MB 那么大,能直接整份管道塞给 Claude Code 吗?
答:千万不要整份硬灌,不仅会瞬间撑爆上下文窗口,还会把配额烧光。先用 tail -n 500 或 grep -C 20 "ERROR" 把故障发生前后几分钟的关键窗口切出来脱敏投喂,大窗口使用边界见 Claude Code 100 万长上下文使用指南。
问:能不能直接把 Claude Code 连上生产主库让它自己跑 EXPLAIN?
答:绝对禁止连生产写库。就算要用 MCP 查表结构或执行计划,也只准连备库或脱敏只读副本,并且严禁带 ANALYZE 跑包含 UPDATE / DELETE 的写语句(因为 EXPLAIN ANALYZE 会真实执行语句内容)。
问:智能体一口气提议给表加五个新索引,该全盘照收吗?
答:不要全收。每多建一个二级索引都会拖慢每一次 INSERT / UPDATE 的写入速度并吃掉缓冲池内存,只保留经过执行计划验证能一针见血干掉全表扫描的那一两个核心索引即可,改库安全规范见 安全执行数据库迁移指南。
问:本地电脑就几百条测试假数据,怎么复现线上百万行规模才暴露的慢查询?
答:表行数太少时数据库优化器往往直接选全表扫描,看不出索引效果。你可以让 Claude Code 在本地 Docker 测试库里用批量生成函数(如 PostgreSQL 的 generate_series)快速造出五十万行符合真实偏斜分布的脱敏仿真数据,跑完 ANALYZE 更新统计信息后再对比优化前后的执行计划耗时。
问:国内没有海外银行卡,怎么给 Claude Code 开通 Pro 或 Max 订阅最稳妥?
答:可在 Claude Code 订阅说明页 或 Claude Max 充值页 选择走苹果 iOS 官方内购链路的自助卡密,自己复制登录凭证提交即可到账,全程无需把密码交给他人;若账号偶发弹出身份核验,也可查看 Claude KYC 人工协助(失败不收费,封号不在质保范围)。
相关教程
- Claude Code 安全配置:防止读取 .env 密钥与敏感文件
- 用 Claude Code 安全执行数据库迁移(Prisma / Alembic)
- 用 Claude Code 接入 Sentry MCP 自动定位线上异常栈
- 用 Claude Code 接入数据库 MCP 安全查询数据与报表
- [Claude Code 100 万长上下文(opus[1m] / sonnet[1m])适用场景](/guides/claude-code-1m-context-window-opus-sonnet)
0 条评论
还没有评论,来抢沙发~