
結論先說
- 隱式緩存在 Gemini 2.5 及更新模型上預設自動開啟,零代碼配置、無額外存儲費:只要重複前綴達到模型最低 token 門檻且命中服務端緩存,就會自動按緩存摺扣價結算,但不承諾每次必中。
- 顯式緩存需要手動創建緩存對象並設定
ttl,保證命中折扣但按時長收存儲費:注意 Interactions API 與 Gemini 4 系列不支持顯式緩存,只能在 Gemini 3 與 Gemini 2.5 模型上通過generateContent(v1beta)使用。 - 最低輸入門檻按代際劃分:Gemini 2.5 Flash / Pro 隱式緩存門檻為
2,048tokens,Gemini 3 系列與 Gemini 4(Hydrogen / Argon / Carbon)門檻為4,096tokens。 - 提高隱式命中率最有效的做法是「固定內容放最前、動態提問放最後」,並通過響應裏的
total_cached_tokens或usage_metadata核對實際命中量。 - 谷歌帳號準備與多工具訂閱入口:使用 Gemini、Google AI Studio 與 Antigravity 需具備符合地區與年齡要求的個人谷歌帳號,缺號可查看本站 谷歌帳號購買說明(含帶 2FA 的 谷歌電郵成品號),跨平台付費訂閱總覽見 AI 會員充值中心。
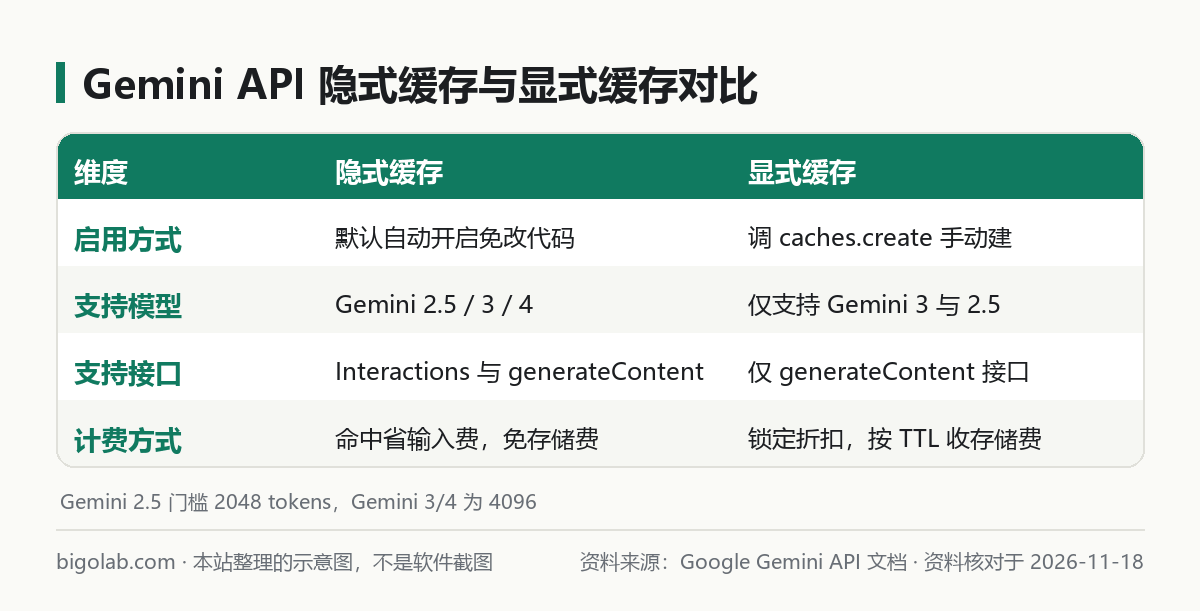
圖:本站根據 Google Gemini API 文檔:Context caching 整理的示意圖
本文根據 Google Gemini API 官方文檔《Context caching》《Gemini Developer API Pricing》整理,資料核對於 2026-11-18。配圖為本站整理的示意圖,不是介面截圖。本站(bigolab.com)不是 Google 官方網站。
適用於誰
- 每次請求都要重複傳入長系統指令、整本 PDF、大型代碼庫或長影片,想降低 Gemini API 輸入 token 成本的開發者;
- 分不清隱式緩存(Implicit caching)與顯式緩存(Explicit caching)在 Gemini 2.5、Gemini 3 與 Gemini 4 上的支持差異的人;
- 想查清緩存命中字段在哪看、顯式緩存存儲費怎麼算以及
ttl怎麼設定的工程師。
一、隱式緩存與顯式緩存有什麼區別
按 Google 官方文檔定義,兩套機制在接口範圍、模型支持和計費邏輯上有明確邊界:
| 對比維度 | 隱式緩存(Implicit caching) | 顯式緩存(Explicit caching) |
|---|---|---|
| 開啟方式 | 預設自動開啟,無需改代碼 | 需調用 caches.create 手動創建並傳引用名 |
| 支持接口 | Interactions API 與 generateContent 均支持 | 僅支持 generateContent(v1beta),Interactions API 不支持 |
| 支持模型 | Gemini 2.5、Gemini 3 與 Gemini 4 全系 | 僅受支持的 Gemini 3 與 Gemini 2.5 模型(Gemini 4 不支持) |
| 命中與費用 | 命中即省輸入費,不收存儲費,無必中承諾 | 存活期內保證享受緩存讀取價,另按時長收緩存存儲費 |
| 命中查看字段 | usage.total_cached_tokens 或 usage_metadata | usage_metadata.cached_content_token_count |
如果你同時也在對比 Anthropic 的緩存計費規則,可參考站內的 Claude 提示詞緩存(Prompt Caching)入門。
二、隱式緩存門檻與提高命中率寫法
隱式緩存不需要額外 API 調用,但必須跨過官方規定的最低輸入 token 門檻才可能觸發:
- Gemini 2.5 Flash / Gemini 2.5 Pro:最低
2,048tokens; - Gemini 3.1 Pro Preview / 3.6 Flash / 3.8 Flash:最低
4,096tokens; - Gemini 4 Hydrogen / Argon / Carbon:最低
4,096tokens。
多輪與智能體循環細節:官方文檔特別註明,在 Gemini 4 的多輪對話或 Agent 工具循環中,只有當新一輪請求相比上一輪至少新增 2,050 tokens(模型輸出、思考過程和函數調用返回結果均計入)時,系統才會把上一輪完整請求緩存下來;若單輪增量不足 2,050 tokens,末尾部分會按標準輸入單價重算。
寫法建議:
- 把固定不變的系統設定、背景知識庫、少樣本示例(Few-shot)統一放在提示詞最開頭;
- 把每次變化的用戶提問、當前時間戳放在最末尾,避免動到前半段導致前綴失效;
- 同批次任務盡量在短時間內連續發送。
初次獲取密鑰與安裝 SDK 的步驟見 Gemini API Key 怎麼獲取 與 Gemini API Python 調用教學。若你還沒有用於登入 Google AI Studio 開通 API 的帳號,可在本站查看 谷歌帳號說明。
谷歌開發帳號與主力編程訂閱提示:若當前帳號卡在地區不支持、手機核驗或工作空間限制,可在本站選購已配置兩步驗證的 谷歌帳號成品號(即時發貨,質保首登,到手請按指引先登後改密);日常搭配主力模型開發,也可同步了解免境外卡自助兌換的 ChatGPT Plus 與 Claude Pro。
三、顯式緩存創建、TTL 設定與省費測算
在 Gemini 2.5 或 Gemini 3 模型上反覆追問同一份超大影片或長文檔,且希望鎖死命中率時,可通過 google-genai SDK 手動創建顯式緩存並指定 ttl(預設通常為 3600s 即 1 小時):
python
from google import genai
from google.genai import types

client = genai.Client()

# 1. 上載大文件並創建顯式緩存,設定 TTL 為 600 秒(10 分鐘)
doc_file = client.files.upload(file="manual.pdf")
cache = client.caches.create(
    model="gemini-2.5-flash",
    config=types.CreateCachedContentConfig(
        display_name="product_manual_cache",
        system_instruction="請嚴格依據手冊原文回答問題。",
        contents=[doc_file],
        ttl="600s",
    ),
)

# 2. 發起請求時直接引用緩存名稱
response = client.models.generate_content(
    model="gemini-2.5-flash",
    contents="列出第三章提到的所有故障代碼",
    config=types.GenerateContentConfig(cached_content=cache.name),
)
print(response.text)
print(response.usage_metadata)
TTL 與省費控制要點:
- 按實際業務窗口設
ttl:顯式緩存按「緩存 token 數 × 存活時長」計收存儲費。如果一批批處理任務 15 分鐘就能跑完,就把ttl設為"900s",或在任務結束時主動調用client.caches.delete(name=cache.name)立即停止計費; - 中途續期:若用戶還在持續提問,可調用
client.caches.update傳入新的ttl或expire_time延長有效期,無需重新上載文本; - 核對免費層與付費層:Google AI Studio 免費層不支持付費緩存特性,具體每百萬 token 基準價與預充值方式見 Gemini API 價格 與 Gemini API 怎麼收費。
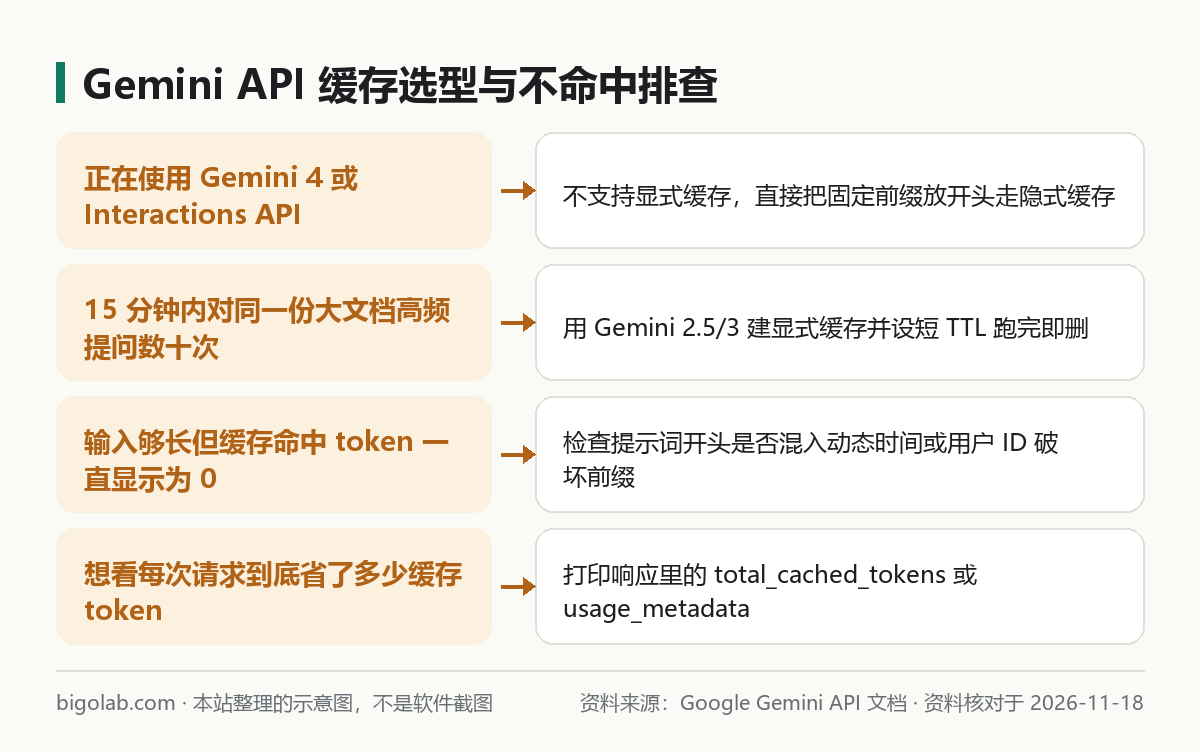
圖:本站根據 Google Gemini API 文檔:Context caching 整理的示意圖
常見問題
問:為什麼我在 Gemini 4 或 Interactions API 裏調 caches.create 報錯?
答:官方文檔明確說明,Interactions API 與 Gemini 4 全系模型均不支持顯式緩存,它們統一走自動生效的隱式緩存。只有切換到 generateContent 接口並選用受支持的 Gemini 3 或 2.5 模型才能建顯式緩存。
問:輸入已經超過 4,096 tokens,為什麼 total_cached_tokens 還是 0?
答:第一次發送某段新前綴時需要先寫入緩存,第二條及後續共享相同前綴的請求才可能命中;另外如果在提示詞開頭塞入了動態時間戳或隨機 ID,會導致前綴從第一個變動位置起全部失效。
問:顯式緩存一定比隱式緩存更省錢嗎?
答:不一定。如果一份大文檔建了 2 小時顯式緩存,期間只查了 1 次,省下的輸入差價可能還抵不上 2 小時的存儲費。低頻稀疏請求直接依賴免費的隱式緩存更划算,高頻密集查詢才適合開顯式緩存。
問:沒有可用的個人谷歌帳號,或者同時想開其他主流 AI 會員怎麼辦?
答:本站提供即買即發的 谷歌電郵成品號(登入方法見 谷歌帳號購買頁),同時支持支付寶、微信支付與 AlipayHK 自助充值 ChatGPT Plus、Claude Code 等主流服務,實時價格與質保細則以各商品頁說明為準。
相關教學
- Gemini API 價格:各模型每百萬 tokens 多少錢、免費層和付費層差在哪
- Gemini API 怎麼收費:按 token 計費、預付費充值(Prepay)與支出上限設定
- Gemini API Python 調用教學:安裝 google-genai SDK、流式輸出、多輪對話
- Claude 提示詞緩存(Prompt Caching)入門:緩存時間、價格倍率與命中率
參考資料
- Google Gemini API 官方文檔:Context caching(Interactions API) — https://ai.google.dev/gemini-api/docs/caching
- Google Gemini API 官方文檔:Context caching(generateContent) — https://ai.google.dev/gemini-api/docs/generate-content/caching
- Google Gemini API 官方文檔:Gemini Developer API Pricing — https://ai.google.dev/gemini-api/docs/pricing
0 條評論
還沒有評論,來搶沙發~