
结论先说
- 上下文爆窗的头号元凶往往不是业务源码,而是锁文件、产物目录和整屏终端输出。一个几兆的
package-lock.json、一份打包后的dist/*.js或一次打印数万行的单测日志,只要被工具原样读进上下文,一两步就能吃掉大半窗口并显著拖慢推理。 - 用
.gitignore管未入库大目录,用.ignore挡已入库锁文件。Codex 底层检索依赖ripgrep等工具时默认尊重.gitignore,确保node_modules/、dist/、.next/、target/已正确写入.gitignore;而必须提交到 Git 的package-lock.json、yarn.lock等文件,可在项目根放一个.ignore文件让搜索工具自动跳过(本站建议)。 - 在
config.toml里设好tool_output_token_limit与model_auto_compact_token_limit硬闸门。即使模型偶尔执行了输出很长的命令,限制单次工具返回 Token 上限也能防止一次失误直接把整场会话撑爆。 - 在
AGENTS.md明文写死「禁止全量读取锁文件与编译产物」。规则说明加硬性权限/截断限制双管齐下,能把日常任务消耗的上下文压低一大截。 - 在大型仓库持续做多轮重构与测试,合理优化上下文之余也需备好充足订阅档位。国内若无外币卡,可在本站自助开通 ChatGPT Plus 或高配额 ChatGPT Pro,团队多人部署也可了解 ChatGPT Business 团队定制。
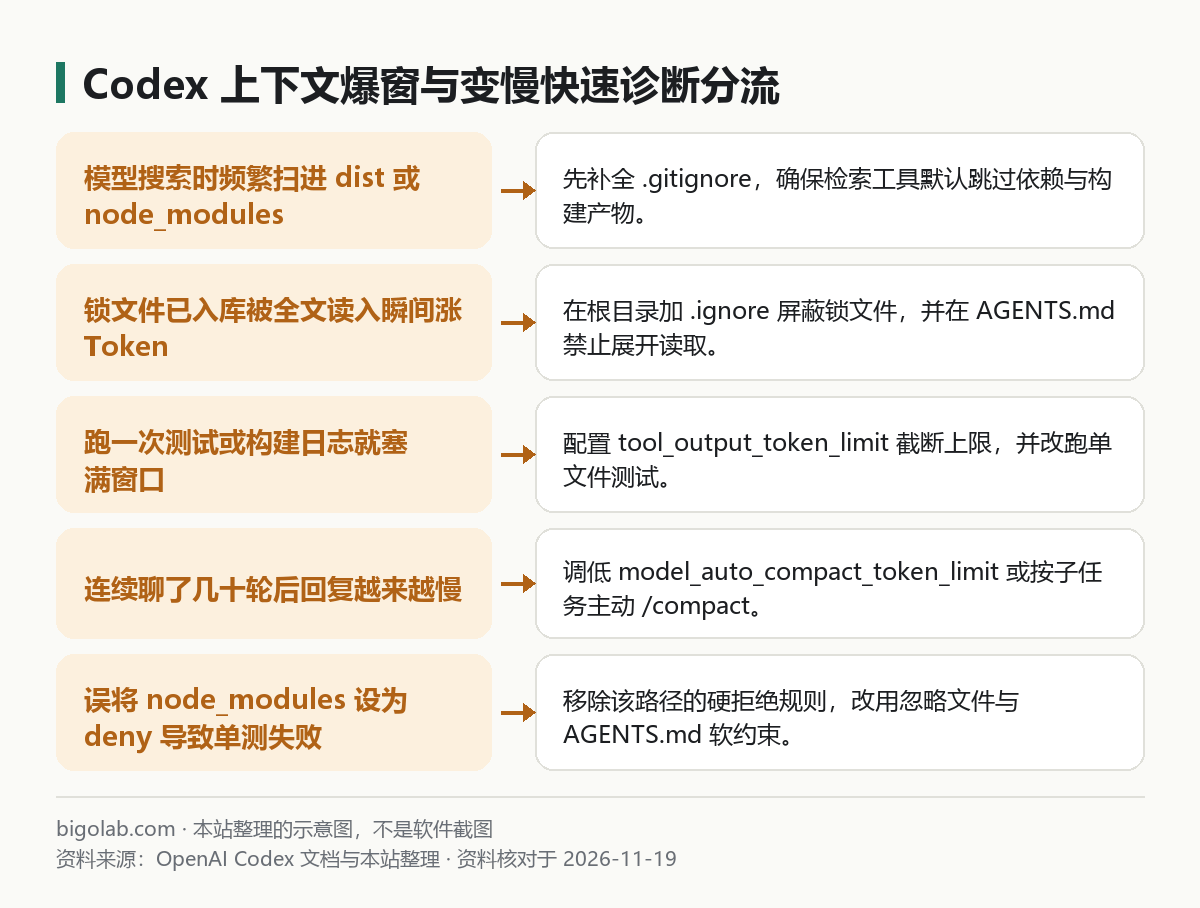
图:本站根据 OpenAI Codex 官方文档:Configuration Reference 整理的示意图
本文根据 OpenAI Codex 官方文档《Configuration Reference》《Custom instructions with AGENTS.md》整理,资料核对于 2026-11-19。配图为本站整理的示意图,不是界面截图。本站(bigolab.com)不是 OpenAI 官方网站。
适用于谁
- 在前端、Node.js、Rust 或大型 Monorepo 项目里跑 Codex,经常几轮对话就遇到上下文爆窗、频繁自动压缩或明显变慢的开发者;
- 发现模型检索或阅读文件时把
package-lock.json、pnpm-lock.yaml、dist/、coverage/或海量测试日志灌进对话,导致额度消耗飞快的用户; - 希望系统化落地「忽略规则 +
config.toml硬上限 + 提示词收口」三层瘦身策略的研发团队。
一、三层防爆窗实战配置:从根源挡住垃圾 Token
想把大型仓库里的 Codex 响应速度和额度利用率拉满(综合省额策略可同步参考 /guides/codex-save-usage-quota-model-reasoning-context-tips),推荐按下面三层顺序落地。
第 1 层:仓库忽略文件(.gitignore + .ignore)
首先确认 .gitignore 完整覆盖了所有依赖和构建缓存目录(如 node_modules/、dist/、build/、.next/、.nuxt/、coverage/、target/、__pycache__/)。
真正的难点在于 锁文件与静态资源:package-lock.json、pnpm-lock.yaml、yarn.lock、Cargo.lock、.min.js、.map 往往因为工程需要已经提交进了 Git,不能写进 .gitignore。这时可以在仓库根目录新建一个轻量 .ignore 文件(ripgrep 默认会自动识别 .ignore 并跳过其中的路径,且不影响 Git 追踪,属于本站建议):
gitignore
# 让检索工具跳过已入库的巨型锁文件与压缩产物
package-lock.json
pnpm-lock.yaml
yarn.lock
Cargo.lock
poetry.lock
**/*.min.js
**/*.min.css
**/*.map
**/__snapshots__/**
第 2 层:config.toml 配置 Token 截断闸门与目录隔离
打开 ~/.codex/config.toml(或受信任项目的 .codex/config.toml),配置单次工具输出上限与自动压缩阈值;如果希望从沙箱文件系统层面硬隔离某些不需要模型触碰的超大数据或产物目录,还可以结合新版 Permission Profiles(详见 /guides/codex-permission-profiles-block-env-config):
toml
#:schema https://developers.openai.com/codex/config-schema.json

# 限制单次命令或工具输出写入上下文的 Token 上限,防巨型日志瞬间撑爆窗口
tool_output_token_limit = 12000

# 适当提前自动压缩触发阈值,避免上下文滚雪球拖慢每轮推理(需小于模型总窗口)
model_auto_compact_token_limit = 64000

# 保持项目说明文件总读取上限精简(默认 32768 字节)
project_doc_max_bytes = 32768
若某些极大数据目录(例如 datasets/、logs/、本地导出 dumps/)完全不需要 Codex 查看,也可在具名权限配置中将其设为 "deny":
toml
[permissions.slim-dev]
extends = ":workspace"

[permissions.slim-dev.filesystem.":workspace_roots"]
"**/node_modules/**" = "deny"
"**/dist/**" = "deny"
"**/logs/**" = "deny"
注意:如果你希望沙箱内执行的 npm test 正常读取 node_modules,请不要在文件系统层把 node_modules 设为 "deny",否则测试进程自己也会找不到依赖;这种情况下请用 .gitignore + AGENTS.md 软约束代替硬拒绝。
第 3 层:在 AGENTS.md 写清搜索与日志节流规范
把下面几条精简规则放进项目根目录 AGENTS.md(读取机制见 /guides/codex-agents-md-how-it-reads),模型就会主动避开高开销操作:
markdown
## 上下文与检索约束
- 禁止读取或全文打印 `node_modules/`、`dist/`、`coverage/` 及 `package-lock.json`、`pnpm-lock.yaml`、`yarn.lock` 等锁文件。
- 排查依赖版本时仅读取 `package.json` 或用精准关键字过滤,不要整文件展开。
- 运行测试或构建时优先只跑当前变更对应的单个测试文件,并使用精简输出参数(如 `--silent` 或只截取末尾失败堆栈)。订阅与账号准备提示:即使做好了大目录忽略,超大规模 Monorepo 与开启超大上下文窗口(参考 /guides/codex-app-context-window-1m-setting)依然对账户配额提出更高要求(额度说明见 /guides/codex-usage-limits)。如果高频触顶,可在本站升级 ChatGPT Pro 充值 或 ChatGPT Pro 5x iOS 可覆盖档;新注册账号卡在手机号验证步骤时,可查看 Codex 注册手机验证服务。
二、日常提速省额的六项自查清单(本站建议)
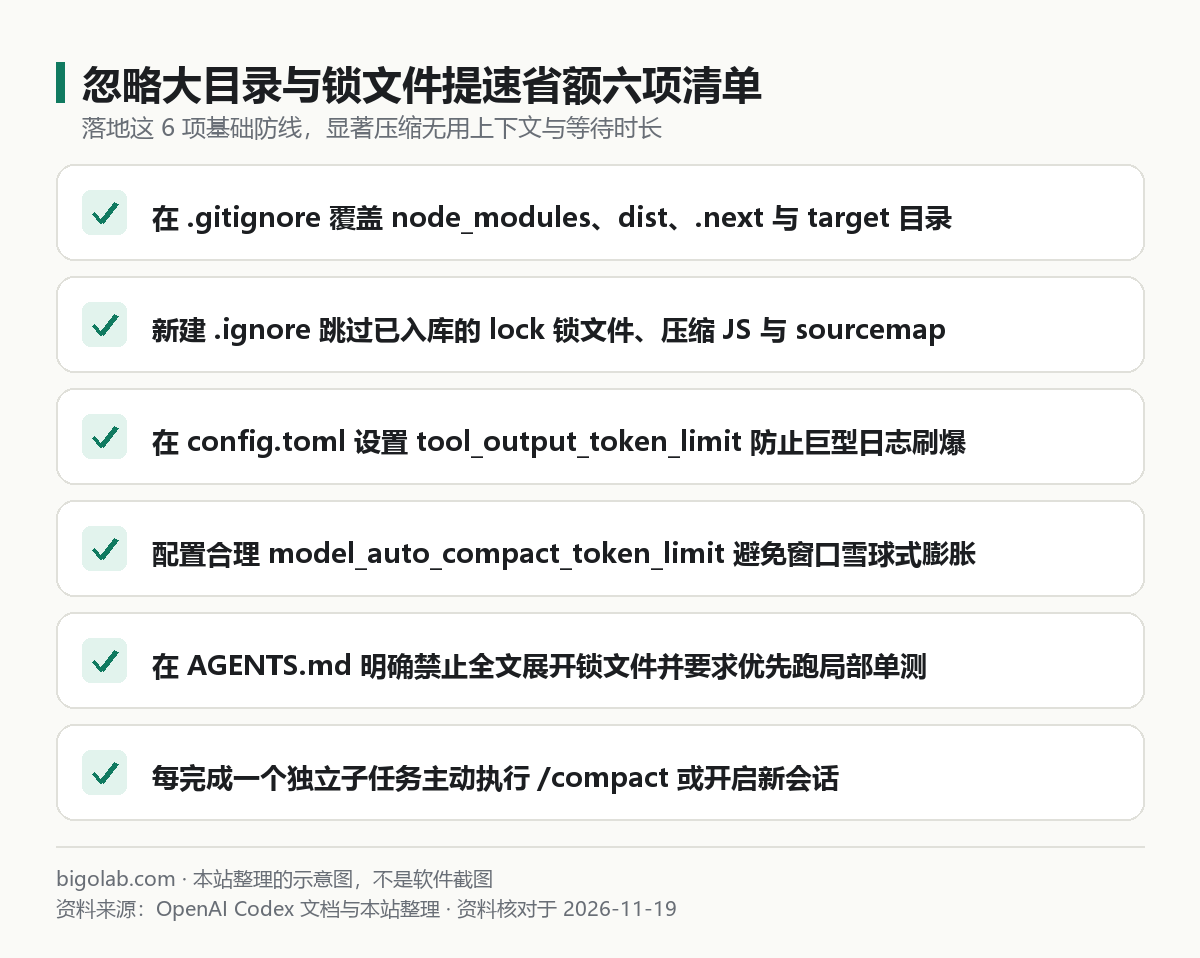
图:本站根据 OpenAI Codex 官方文档:AGENTS.md 整理的示意图
日常提问时,把以下四个操作养成习惯,体验提升最立竿见影:
- 提问先缩小目录范围:与其说「搜一下整个仓库哪里用了订单状态」,不如直接指明「仅在
src/modules/order/下排查订单状态枚举」。 - 改完一个子任务主动
/compact或新开会话:不要把毫无关联的三个需求塞进同一条几百轮的老会话里(压缩与回滚技巧见 /guides/codex-cli-diff-compact-rewind-rollback-guide)。 - 测试失败只喂关键堆栈:让 Codex 跑全套 E2E 测试往往吐出几千行日志,在提示词里约定「只运行变更相关的单个 spec 并聚焦失败断言」能省下大量输入 Token。
- 切勿直接把整份数据库导出或线上原始日志文件塞进仓库根:大体积文本文件即使不改代码,也极易被模糊搜索意外扫中。
常见问题
问:为什么把 node_modules 写进权限配置文件的 "deny" 后,npm test 反而报错找不到模块了?
答:Permission Profiles 的文件系统 "deny" 作用于整个沙箱进程树,Node.js 运行测试时同样无法读取被拒绝的 node_modules。需要运行前端依赖的仓库,应通过 .gitignore、.ignore 和 AGENTS.md 防止模型主动去读,仅对真正不需要代码进程访问的离线大目录(如 archives/、raw-dumps/)使用 "deny"。
问:把 tool_output_token_limit 调小之后,报错堆栈被截断看不全怎么办?
答:不要把它压得过低(例如几百 Token);本站建议设置在 8000 到 16000 左右,既能容下常规报错堆栈和单测结果,又能有效挡住几万行的巨型输出把整场上下文瞬间撑爆。
问:国内没有外币信用卡,或者公司研发团队需要开增值税发票报销,怎么开通能跑 Codex 的订阅?
答:可在本站 AI 会员充值总览 按需选购 ChatGPT Plus、ChatGPT Plus 官网直充 或高配额的 ChatGPT Pro,团队多人统一部署可直接查看 ChatGPT Business 团队定制。支持支付宝、微信支付与 AlipayHK,自助兑换无需交出账号密码,并可开具增值税发票;实时价格以商品页展示为准,售后执行掉订阅按剩余天数折退、封号不在质保范围的政策。
相关教程
- Codex 节省额度的模型、推理档位与上下文实用技巧
- Codex CLI /diff、/compact 与回滚操作完全指南
- Codex App 1M 超大上下文窗口配置说明
- Codex Permission Profiles 权限配置文件:屏蔽 .env 与最小权限实战
参考资料
- OpenAI Developers 文档:Codex Configuration Reference — https://developers.openai.com/codex/config-reference
- OpenAI Developers 文档:Custom instructions with AGENTS.md — https://developers.openai.com/codex/guides/agents-md
- OpenAI Codex 官方文档:Configuration Reference — https://learn.chatgpt.com/docs/config-file/config-reference
- OpenAI Codex GitHub 仓库 — https://github.com/openai/codex
0 条评论
还没有评论,来抢沙发~