
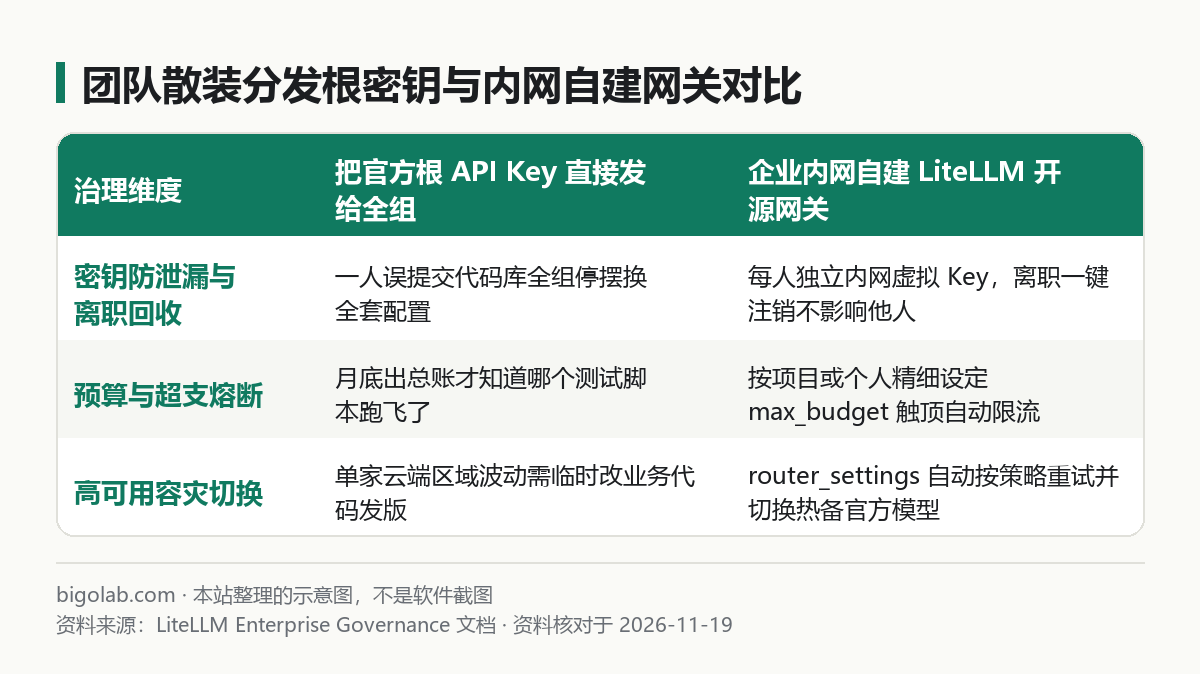
当一家公司的研发团队从两三个人试水 AI 扩展到二三十人日常在后端服务、Continue 插件 或 OpenCode 终端 里调用大模型时,工程主管往往会陷入两难:如果直接把公司财务绑卡申请的 Anthropic、OpenAI、Google 官方根密钥(Root API Key)群发给全员,一旦有人手滑把 .env 提交到外部代码仓,全公司所有线上服务都得跟着停机换钥;而且月底拿到一张混在一起的总账单,根本查不清到底是哪个自动化脚本死循环烧超了预算。
GitHub 高星开源网关 LiteLLM(Proxy Server) 正是解决企业内网多模型治理的工业级标准组件:你把它私有化部署在公司自己的内网服务器上,向上对接企业合规持有的各家官方 API 与内网自建的 vLLM 开源推理集群,向下用统一的兼容格式给每位员工签发带独立配额上限的内部虚拟密钥(Virtual Keys)。
AI 全栈开发订阅配套入口:在本地部署与联调开源 AI 框架时,搭配固定月费的终端编程智能体与旗舰推理订阅能大幅缩短排错时间。国内无境外信用卡可在本站通过支付宝、微信支付或 AlipayHK 免密自助开通 Claude Code 订阅、ChatGPT Plus / Pro 或查看 AI 会员充值总览。
一、编写 litellm_config.yaml:统一模型别名与自动故障切换
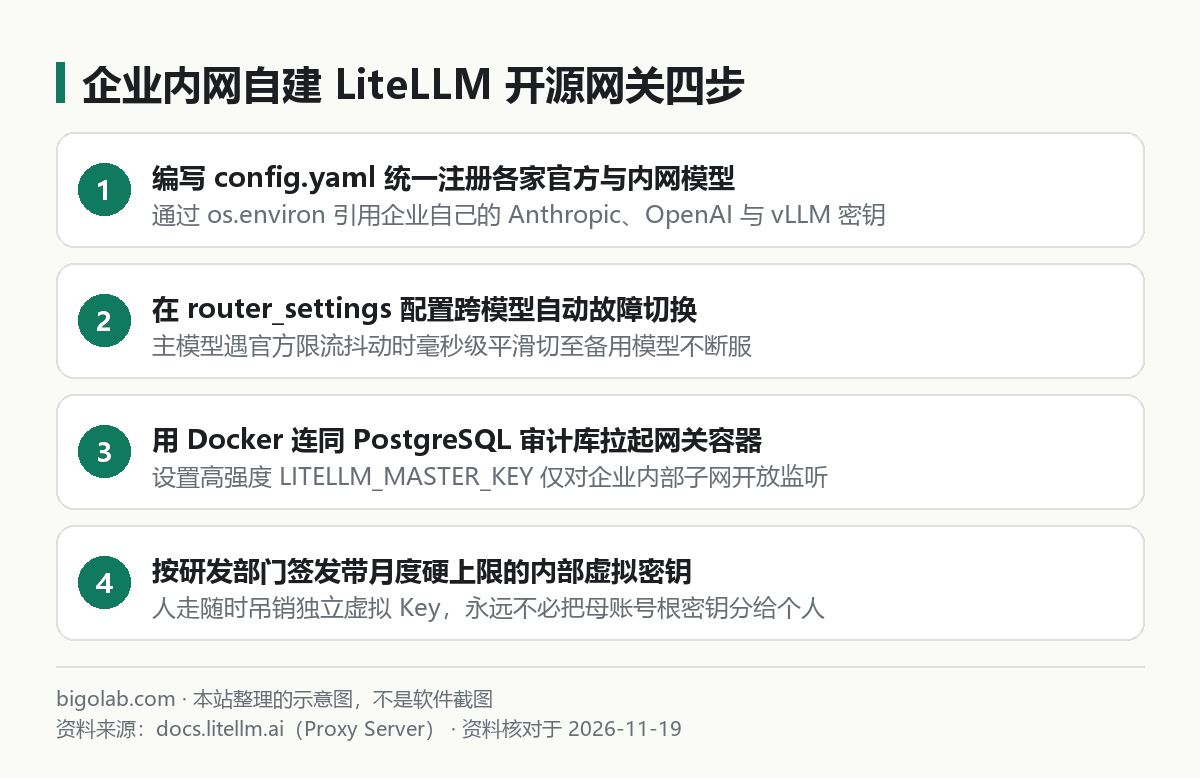
在企业内网服务器上新建一个部署目录,创建核心路由配置文件 litellm_config.yaml。所有真实的官方母账号密钥一律通过 os.environ/变量名 从服务端受保护的环境变量读取,绝不落明文:
yaml
model_list:
  # 1. 主力云端代码与推理通道:连接企业官方 Anthropic 账号
  - model_name: team-coder-main
    litellm_params:
      model: anthropic/claude-sonnet-4-5
      api_key: os.environ/ANTHROPIC_API_KEY

  # 2. 跨厂商热备通道:连接企业官方 OpenAI / Azure 账号
  - model_name: team-coder-backup
    litellm_params:
      model: openai/gpt-4o
      api_key: os.environ/OPENAI_API_KEY

  # 3. 内网零外发敏感数据通道:连接公司机房自建的 vLLM 服务
  - model_name: internal-local-qwen
    litellm_params:
      model: openai/Qwen/Qwen2.5-Coder-32B-Instruct
      api_base: http://10.0.12.88:8000/v1
      api_key: os.environ/INTERNAL_VLLM_TOKEN

router_settings:
  num_retries: 2
  timeout: 60
  # 当主通道偶发 429 速率触顶或网络超时,自动无感切换至热备官方模型
  fallbacks:
    - {"team-coder-main": ["team-coder-backup"]}

general_settings:
master_key: os.environ/LITELLM_MASTER_KEY这套配置最受运维欢迎的设计在于逻辑模型名解耦:全公司业务代码和编辑器配置里写的模型名永远是固定的 team-coder-main。下个季度官方发布了新一代主力模型,管理员只需在网关后台改一行映射重启,全公司几十个微服务一行代码不用动就能平滑完成模型升级。
二、用 Docker Compose 连同审计数据库一键拉起
为了持久化保存每个部门的消耗明细与虚拟密钥表,生产内网部署必须挂载一个 PostgreSQL 数据库实例。在同目录创建 docker-compose.yml:
yaml
services:
  litellm-proxy:
    image: ghcr.io/berriai/litellm:main-stable
    ports:
      - "127.0.0.1:4000:4000" # 建议通过内网反向代理或仅绑定内部子网网卡暴露
    volumes:
      - ./litellm_config.yaml:/app/config.yaml:ro
    environment:
      DATABASE_URL: "postgresql://llmadmin:StrongDbPass@litellm-db:5432/litellm"
      LITELLM_MASTER_KEY: "sk-internal-master-请替换为高强度随机长串"
      ANTHROPIC_API_KEY: "${ANTHROPIC_API_KEY}"
      OPENAI_API_KEY: "${OPENAI_API_KEY}"
      INTERNAL_VLLM_TOKEN: "${INTERNAL_VLLM_TOKEN}"
    command: ["--config", "/app/config.yaml", "--port", "4000"]
    depends_on:
      - litellm-db

  litellm-db:
    image: postgres:16-alpine
    environment:
      POSTGRES_USER: llmadmin
      POSTGRES_PASSWORD: StrongDbPass
      POSTGRES_DB: litellm
    volumes:
      - pgdata:/var/lib/postgresql/data

volumes:
  pgdata:
运行 docker compose up -d 启动后,访问内网管理面板 http://内网地址:4000/ui 输入管理员主密钥即可看到可视化监控仪表盘。
研发团队订阅与高配额省心方案:调试复杂多步智能体循环、RAG 切片策略与 CI 评测流水线非常消耗单日 Token。个人主力开发推荐免上号兑换 Claude Pro iOS 自助卡密 或 5 倍额度的 Claude Max 5x,多人研发团队协同亦可联系客服定制 ChatGPT Business 团队版。
三、签发带月度预算硬顶的内部虚拟密钥(Virtual Keys)
管理员主密钥(LITELLM_MASTER_KEY)只留给运维后台自己用,绝对不发给任何开发者或业务容器。给前端组或实习生分配权限时,通过管理后台 UI 或调用 /key/generate 管理接口签发受控子密钥:
bash
curl -X POST "http://127.0.0.1:4000/key/generate" \
  -H "Authorization: Bearer $LITELLM_MASTER_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "key_alias": "frontend-team-ci",
    "models": ["team-coder-main", "internal-local-qwen"],
    "max_budget": 50.0,
    "budget_duration": "30d",
    "rpm_limit": 60
  }'
拿到返回的内网专属 sk-... 虚拟密钥后,该团队只能访问白名单里指定的两个模型,每分钟并发不得超过 60 次,且 30 天周期内一旦累计消耗触及设定的预算上限网关就会自动拦截熔断,彻底杜绝测试脚本写错死循环把公司母账号刷爆的惊魂时刻;人员调岗或离职时一键吊销该虚拟 Key 即可。
对于不想自己维护内网网关数据库、只想给核心工程师配备独立固定包月额度的中小研发团队,直接按人头开通官方原生开发订阅往往比管 API 池更省运维人力。需要正规开通海外开发者订阅的团队与个人,可前往查看贝果研究社 Claude Code 订阅与配置方案或全站 AI 订阅自助导航。
常见问题
LiteLLM 自建网关绝对不能踩的安全与合规红线是什么?
第一,严禁将网关端口裸露在无鉴权公网或把虚拟密钥对外违规转售分租——各家海外大模型厂商的服务条款均严格规定企业 API 仅供本组织内部业务系统与员工合规调用;第二,LITELLM_MASTER_KEY 必须使用密码生成器生成 32 位以上高熵随机字符串,切勿沿用文档示例里的默认弱口令(曾有多起公网裸奔网关因使用默认 sk-1234 主密钥在几分钟内被扫描盗刷的真实教训)。
开启代理层转发后,会给流式出字速度增加明显延迟吗?
在内网千兆局域网环境下,LiteLLM 本身的路由鉴权与协议转换开销通常只有几毫秒,相较于大模型首字推理动辄几百毫秒的耗时几乎无感;如果你在高并发生产场景追求极致吞吐,可在启动参数中调增 --num_workers 进程数并挂载内网 Redis 缓存鉴权状态。
搭好开源框架后,国内没有外币信用卡怎么开通主力编程与大模型订阅?
可在 本站 AI 会员充值中心 使用支付宝、微信支付或 AlipayHK 自助选购卡密,支持免交密码兑换 Claude Code(Pro / Max)、ChatGPT Plus 与 ChatGPT Pro,并支持开具增值税发票;实时价格与售后边界(封号不在质保范围)以对应商品页说明为准。
小结
- 企业多人协作切忌群发官方根 API Key,在内网自建 LiteLLM 开源网关可统一收拢官方云端接口与本地 vLLM 服务。
- 利用
router_settings.fallbacks与逻辑模型别名,实现单点限流自动切热备模型以及业务零改码平滑升级底座。 - 严守内网隔离与高强度主密钥安全红线,按项目组与个人签发限定
models、rpm_limit与max_budget的独立虚拟密钥。
0 条评论
还没有评论,来抢沙发~