
在 Java 后端扎堆的 IntelliJ IDEA 或前端常用的 VS Code 里,开源扩展 Continue 之所以一直是“自带密钥(BYOK)”开发者的心头好,核心在于它允许你像拼积木一样拆解模型分工:侧边栏深度重构调用最聪明的旗舰云端模型,而每秒都在触发的打字行内补全则交给零成本、毫秒级响应的轻量 FIM(Fill-in-the-Middle)专用模型。
之前在介绍如何把 DeepSeek API 接入 VS Code 时简单提到了 Continue,但新版 Continue 已经全面从早期的 config.json 升级到了结构更清晰的 config.yaml。这篇教程把它的角色拆分、密钥保护与跨 IDE 同步一次讲透。
本站开发者订阅直达入口:高频跑多文件重构与工具链调用时,搭配固定月费的主力订阅往往比纯烧按量 API 更省钱。国内无境外信用卡可通过支付宝、微信支付或 AlipayHK 在本站免密自助开通 Claude Code 订阅(Pro / Max)、ChatGPT Plus 或浏览 AI 会员充值总览。
一、搞懂 roles 角色分工:别拿旗舰推理模型硬跑自动补全
很多新手装上 Continue 后只填了一个旗舰大模型,结果打字时等两三秒才蹦出一行灰色续写,月底一看账单还被高频触发的补全请求吃掉一大截。在 config.yaml 里,每个模型条目都必须通过 roles 数组明确划定职责边界:
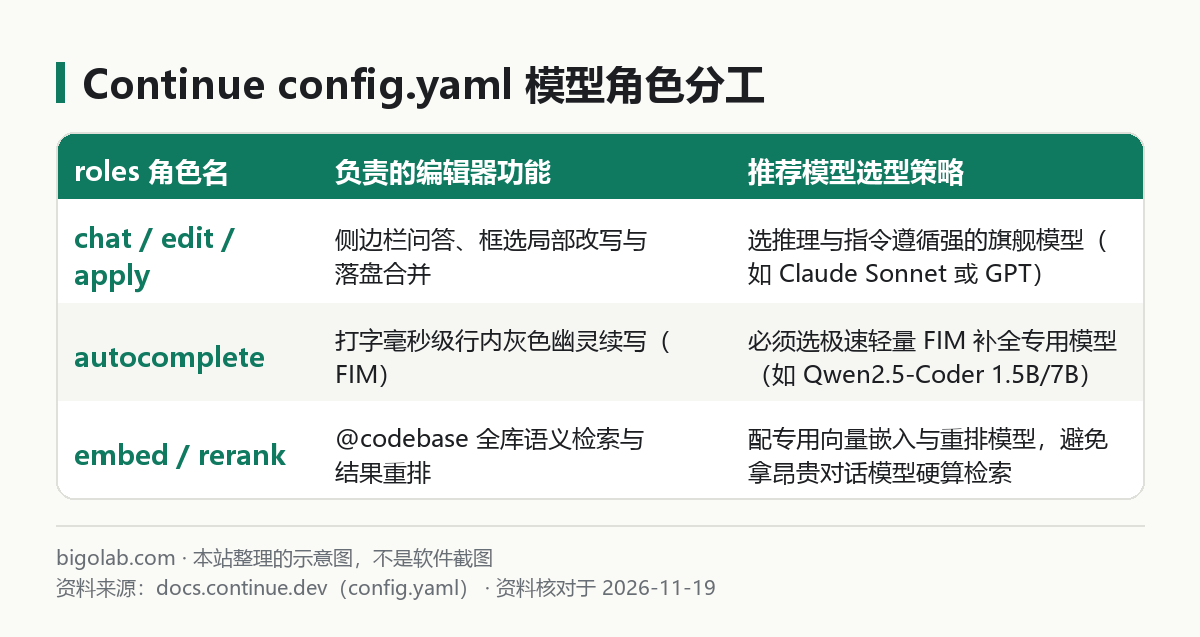
黄金搭配公式非常明确:
chat+edit+apply:交给指令遵循与跨文件逻辑最强的官方旗舰模型(例如 Anthropic Claude Sonnet 或 OpenAI 主力模型),只在你主动提问或按Ctrl+I(IDEA 为Ctrl+J)框选改代码时计费。autocomplete:单独配给专门训练过“中间填空(FIM)”能力的小尺寸代码模型(例如本机 Ollama 跑qwen2.5-coder:1.5b/7b,或云端极速 Codestral 模型)。如果省略不写roles,Continue 默认不会把模型用于autocomplete,这也是很多人配完发现打字没灰色提示的原因。embed:驱动@codebase与@docs本地向量检索,挂一个轻量本地嵌入模型(如nomic-embed-text)即可免去云端检索开销。
二、~/.continue/config.yaml 完整实战模板
无论你在 VS Code 还是 JetBrains 系列 IDE(IntelliJ IDEA、PyCharm、GoLand)里安装了 Continue 扩展,它们默认都读取用户主目录下的同一份全局配置文件:
- macOS / Linux:
~/.continue/config.yaml - Windows:
%USERPROFILE%\.continue\config.yaml
点击 Continue 侧边栏右上角的小齿轮图标即可直接打开该文件。下面是一份可以直接复用的“云端强脑对话 + 本地极速免费补全 + MCP 挂载”标准配置:
yaml
name: Fullstack Mix Config
version: 1.0.0
schema: v1

models:
  # 1. 主力对话与改写模型:使用官方云端旗舰 API
  - name: Claude Sonnet (Chat & Edit)
    provider: anthropic
    model: claude-sonnet-4-5
    apiKey: ${{ secrets.ANTHROPIC_API_KEY }}
    roles:
      - chat
      - edit
      - apply

  # 2. 毫秒级行内补全模型:调用本机 Ollama 跑轻量 FIM 模型
  - name: Local Qwen Coder Autocomplete
    provider: ollama
    model: qwen2.5-coder:1.5b
    apiBase: http://localhost:11434
    roles:
      - autocomplete

  # 3. 本地代码库语义检索向量模型
  - name: Local Nomic Embed
    provider: ollama
    model: nomic-embed-text:latest
    roles:
      - embed

rules:
  - 生成代码优先遵循当前文件已有的命名风格与错误处理约定,不要输出多余的寒暄解释。
  - 修改 TypeScript 文件时严禁引入显式 any 类型。

mcpServers:
  - name: filesystem-docs
    command: npx
    args:
      - -y
      - "@modelcontextprotocol/server-filesystem"
      - ./docs
配置里的 ${{ secrets.ANTHROPIC_API_KEY }} 会从同目录下的本地环境变量文件(~/.continue/.env)或系统密钥库读取真实键值,防止你截屏分享配置或备份仓库时泄露明文 Key。如果你还没在本机装好本地推理服务,可以先照着 Ollama 安装与常用命令指南跑一句 ollama pull qwen2.5-coder:1.5b 和 ollama pull nomic-embed-text。
重度编码配额与双引擎互补建议:在开源插件或终端智能体里处理大型单体仓库时,不少工程师会同时备好一套包月封顶的官方订阅兜底复杂架构攻坚。可按需前往查看 Claude Max 5x / 20x 充值说明、Claude Pro iOS 自助卡密 或 ChatGPT Pro 充值页。
三、在 VS Code 与 IDEA 之间无缝协同的四步要点
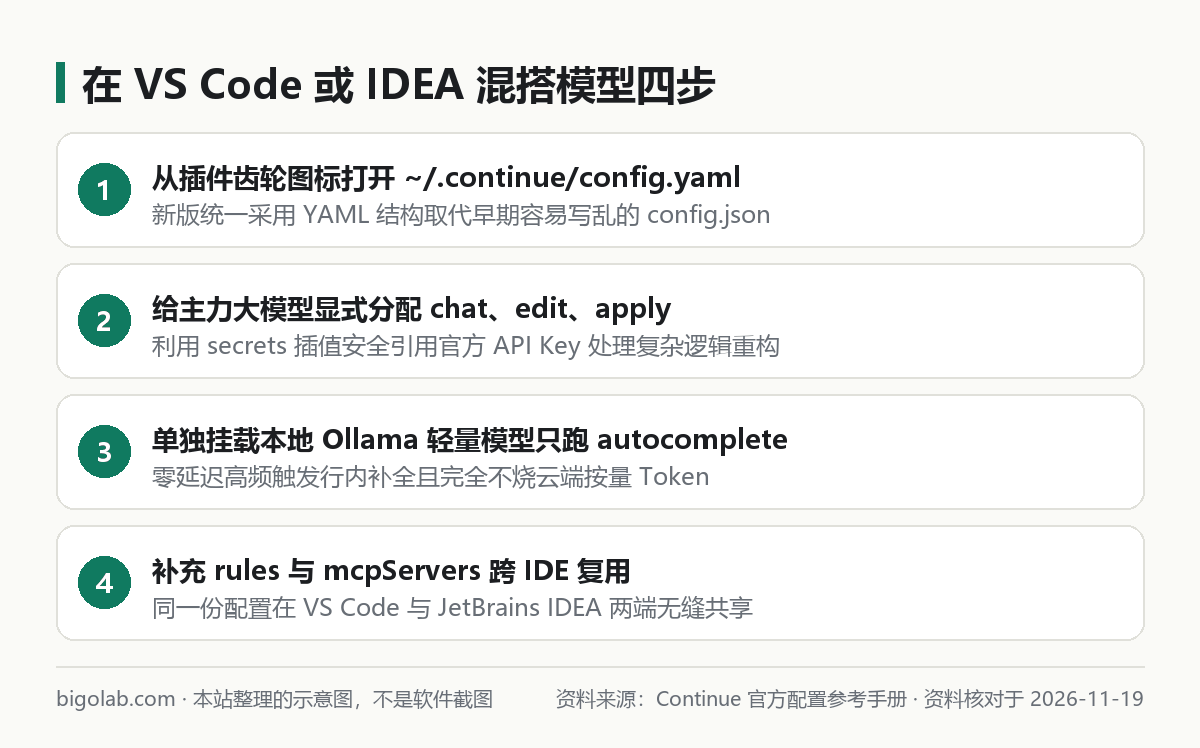
对于前后端双开的工程师(前端开 VS Code 写 React,后端开 IntelliJ IDEA 写 Spring Boot),Continue 最大的省心之处在于改一次全局 config.yaml,两个 IDE 同时生效。日常使用再留意三个细节:
- JetBrains IDEA 快捷键冲突微调:在 IDEA 里经常碰到插件行内改写快捷键与系统自带智能提示打架(正如配置 IDEA 版 GitHub Copilot 插件 时常见的键位冲突)。建议进入 IDEA 的
Settings -> Keymap,搜索Continue,把展开侧边栏与内联编辑绑到不冲突的组合键上。 - 项目级
.continue/rules/覆盖团队规范:全局config.yaml里的rules只管你个人习惯;对于具体业务仓库的框架约束,可以在项目根目录下创建.continue/rules/*.md提交到 Git,团队成员打开仓库自动叠加生效。 - 调优深度思考模型的补全延迟:如果你把带有长链思考(Thinking)的混合模型拿来做快速局部编辑,觉得等待前奏太久,可以在该模型的
requestOptions下通过额外请求体参数关闭非必要的冗长思考过程,专心用于复杂架构问答。
当然,自己折腾多套按量 API 密钥加本地显卡模型适合喜欢高度定制的极客;如果你希望在主力生产环境省掉维护本地服务和盯 Token 账单的精力,直接开通官方一站式固定订阅会省心很多。需要正规直连订阅服务的开发者,可前往查看贝果研究社 Claude Code 订阅与配置方案或 ChatGPT Plus 自助充值专页。
常见问题
我以前写的旧版 config.json 升级插件后还能用吗?
Continue 仍保留了对存量 config.json 的向后兼容读取,但官方所有新特性(如模块化 rules、mcpServers 与 Hub 配置块组合)均围绕 config.yaml 构建。当同一目录下同时存在 .yaml 与 .json 时,系统会优先以 config.yaml 为准,建议趁早迁移过去避免两边改乱。
为什么我的笔记本一开本地 Ollama 跑 7b 补全风扇就狂转且出字慢?
行内自动补全对首字延迟(TTFT,最好低于 300 毫秒)极其敏感。如果你的轻薄本没有独立显卡或统一内存小于 16GB,跑 7b 模型的实时补全确实会吃力。把 autocomplete 角色换成体量极小的 qwen2.5-coder:1.5b,内存占用仅 1GB 出头,敲代码时的流畅度反而远胜跑不动的大参数模型。
国内没有海外信用卡,怎么开通 Claude Code 或 ChatGPT 编程订阅?
可直接在 本站充值中心 使用支付宝、微信支付或 AlipayHK 下单获取自助卡密,支持免上号兑换 Claude Pro、Claude Max 与 ChatGPT Plus / Pro,可开具增值税发票;实时价格、兑换前提与售后边界(封号不在质保范围)以对应商品页说明为准。
小结
- 新版 Continue 统一在
~/.continue/config.yaml中管理配置,一份文件即可同时驱动 VS Code 与 JetBrains IDEA。 - 务必通过
roles把重度对话重构(chat/edit/apply)与高频行内填空(autocomplete)拆给不同量级的模型,兼顾代码质量与零延迟省钱。 - 善用
${{ secrets.变量名 }}隔离敏感 API Key,并把团队业务约束放进项目级.continue/rules/目录随仓库共享。
0 条评论
还没有评论,来抢沙发~