
在读完 Pydantic AI 快速入门与基础 output_type 用法 之后,把智能体真正接进企业 FastAPI 后端立刻会碰到三个实战深水区问题:
- 工具函数里要查 PostgreSQL 连接池和当前登录用户的
tenant_id,难道要靠丑陋且线程不安全的全局变量往里塞吗? - 模型虽然输出了合法的 JSON 字符串
{"order_id": "ORD-9999"},但去库里一查根本没这个单号,怎么把报错原因精准踢回给大模型让它自己重查,而不是直接抛 500 崩给前端? - 主力云端模型突遇高峰期
429限流时,怎么零改动业务代码平滑切到备用厂商?
把 RunContext[Deps]、ModelRetry 与 ModelFallback 三剑客组合起来,就能写出类型检查器百分百放心的生产级 Python 智能体。
AI 全栈开发订阅配套入口:在本地部署与联调开源 AI 框架时,搭配固定月费的终端编程智能体与旗舰推理订阅能大幅缩短排错时间。国内无境外信用卡可在本站通过支付宝、微信支付或 AlipayHK 免密自助开通 Claude Code 订阅、ChatGPT Plus / Pro 或查看 AI 会员充值总览。
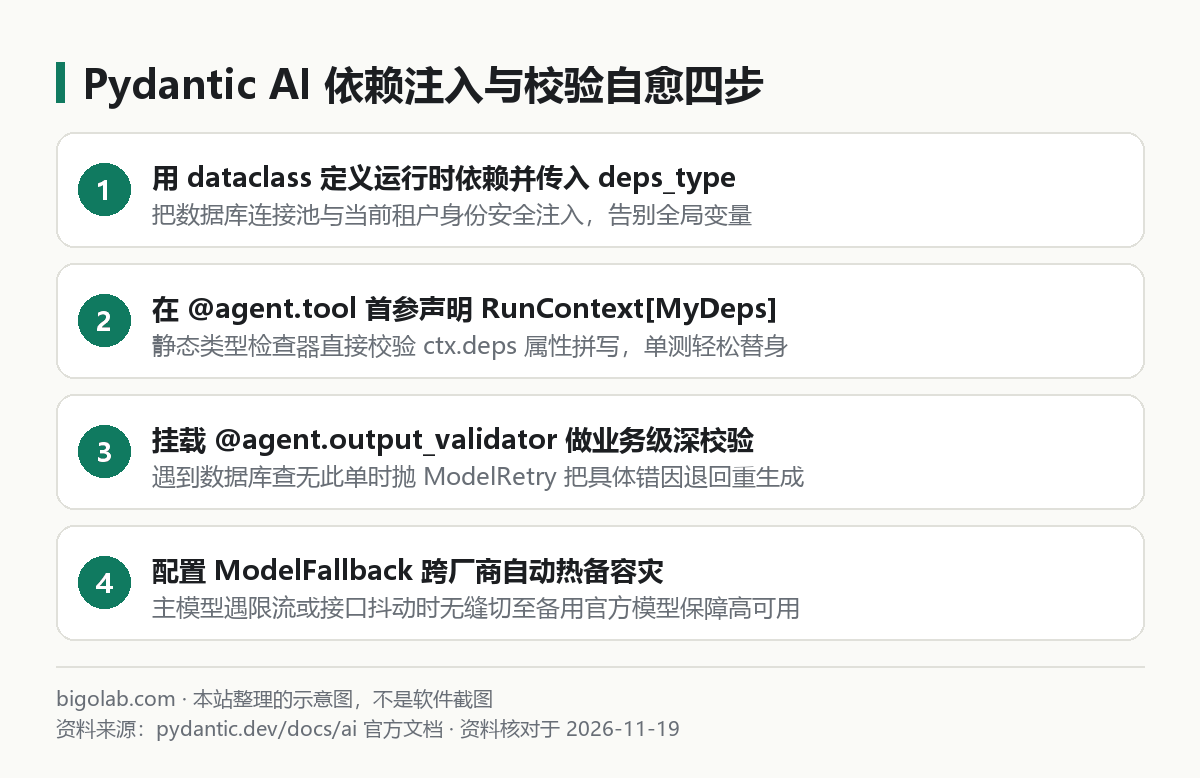
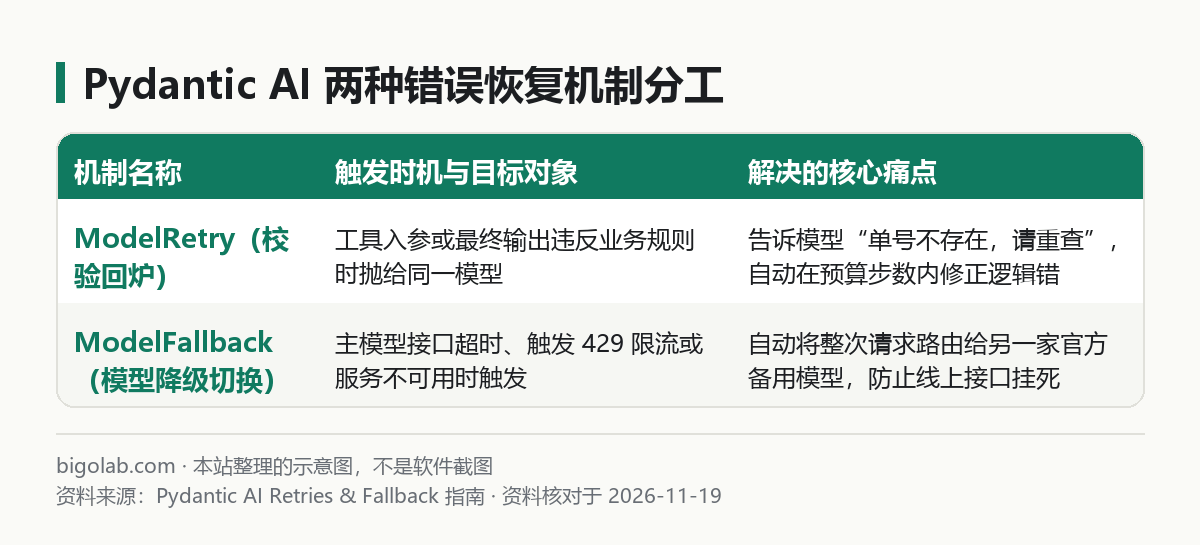
一、看清两种恢复机制的职责边界:ModelRetry 与 ModelFallback
很多刚进阶的开发者容易把“校验不通过让模型重改”和“接口挂了换备用模型”混为一谈。在 Pydantic AI 架构里,这两件事由完全不同的组件分工负责:
二、完整生产级代码:依赖注入 + 数据库深校验自愈 + 备用模型容灾
装好核心包(pip install pydantic-ai),下面这段结构紧凑的代码展示了如何像写 FastAPI Depends 一样,把异步数据库连接与当前用户身份强类型注入给动态指令、工具函数与输出校验器:
python
import asyncio
from dataclasses import dataclass
from pydantic import BaseModel, Field
from pydantic_ai import Agent, ModelRetry, RunContext
from pydantic_ai.capabilities import ModelFallback

# 1. 定义运行时依赖容器:测试时可轻松替换为内存替身对象,无需连真实数据库
@dataclass
class SupportDeps:
    current_user_id: str
    valid_orders: dict[str, str]  # 生产中替换为异步数据库连接池如 AsyncSession

# 2. 定义强类型最终输出结构
class RefundDecision(BaseModel):
    order_id: str = Field(description="核实存在且归属当前用户的订单号")
    approved: bool
    reason_cn: str = Field(description="给用户的简明中文处理说明")

# 3. 初始化智能体:绑定依赖类型、重试预算及跨厂商热备模型
refund_agent = Agent(
    "anthropic:claude-sonnet-4-5",
    deps_type=SupportDeps,
    output_type=RefundDecision,
    retries=2,  # 允许工具或输出校验触发最多 2 次回炉修正
    capabilities=[ModelFallback("openai:gpt-4o")],
)

# 4. 动态系统指令:通过 ctx.deps 安全读取当前请求上下文
@refund_agent.instructions
def dynamic_user_context(ctx: RunContext[SupportDeps]) -> str:
    return f"当前发起售后的登录用户 ID 为 {ctx.deps.current_user_id},严禁处理他人名下订单。"

# 5. 工具函数:首参声明 RunContext[SupportDeps],IDE 自动补全所有依赖属性
@refund_agent.tool
async def list_my_orders(ctx: RunContext[SupportDeps]) -> dict[str, str]:
    """查询当前用户名下所有真实历史订单号及状态。"""
    return ctx.deps.valid_orders

# 6. 业务级深层输出校验器:拦截“格式合法但业务查无此单”的幻觉输出
@refund_agent.output_validator
async def verify_order_exists(
    ctx: RunContext[SupportDeps], decision: RefundDecision
) -> RefundDecision:
    if decision.order_id not in ctx.deps.valid_orders:
        raise ModelRetry(
            f"订单号 '{decision.order_id}' 在当前用户名下不存在。"
            "请先调用 list_my_orders 工具核实真实单号后再重新输出结构化结果。"
        )
    return decision

async def main():
    deps = SupportDeps(
        current_user_id="U-801",
        valid_orders={"ORD-202611": "已签收三天"},
    )
    # 故意输入一个用户记错的模糊单号,触发校验拦截 -> 自动调工具核实 -> 自愈通过
    res = await refund_agent.run("帮我给尾号 2611 的那个订单申请退货", deps=deps)
    print(res.output)

if __name__ == "__main__":
asyncio.run(main())研发团队订阅与高配额省心方案:调试复杂多步智能体循环、RAG 切片策略与 CI 评测流水线非常消耗单日 Token。个人主力开发推荐免上号兑换 Claude Pro iOS 自助卡密 或 5 倍额度的 Claude Max 5x,多人研发团队协同亦可联系客服定制 ChatGPT Business 团队版。
三、这套设计给工程团队带来的三个真金白银收益
相比在普通工作流框架(例如对比 LlamaIndex Workflows 或 LangGraph 状态图)里手写一堆 try/except JSONDecodeError 循环,上面这段代码把最脏的胶水逻辑全部收归框架底层:
- 静态类型检查直接抓低级拼写 Bug:你在
Agent(..., deps_type=SupportDeps)里声明了依赖类型,如果在工具里不小心手滑把ctx.deps.current_user_id敲成了ctx.deps.user_id,不用等上线跑代码,编辑器里的 Pyright 或 Mypy 当场就会标红报错。 - 单元测试一秒跑完零外部耦合:写
pytest单元测试时,根本不需要拉起 Docker 数据库容器,只需构造一个塞了假字典的SupportDeps实例传进agent.run(..., deps=fake_deps),连模型本身都可以用内置的TestModel替身秒级跑通全链路校验逻辑。 ModelRetry把报错文案变成最精准的二次提示词:注意看第 47 行抛出的ModelRetry异常文本——务必用清晰直白的语言写明“哪里错了 + 下一步该调哪个工具纠正”,并通过ctx.retry观察当前是第几次重试,通常retries=2就能救回九成以上的字段疏漏。
日常编写 Python 类型安全后端与多模型容灾架构时,搭配高配额的官方编程订阅与推理账号能大幅提升联调效率。需要开通海外正规开发订阅的工程师,可前往查看贝果研究社 Claude Code 订阅与配置方案或全站 AI 订阅自助导航。
常见问题
在工具函数内部(@agent.tool)如果发现大模型传进来的查询参数不合法,也能抛 ModelRetry 吗?
完全可以,而且非常推荐这样做。比如大模型传了一个格式错误的日期字符串 "昨天" 给要求 YYYY-MM-DD 的统计工具,千万不要直接抛普通的 ValueError 让整个请求崩溃退出,而是直接 raise ModelRetry("日期参数必须为 YYYY-MM-DD 格式,请修正后重调本工具"),大模型看到反馈后下一秒就会自己改好参数重调一次。
运行时想临时给 VIP 用户升级成更强的模型,需要重新实例化一个新的 Agent 吗?
不需要。Agent 实例在设计上是无状态、全局可安全复用的单例(就像 FastAPI 的 APIRouter)。遇到高价值请求需要临时切换模型时,只需在单次执行时传入覆盖参数 await refund_agent.run(prompt, deps=deps, model="anthropic:claude-opus-4-6"),仅对当次请求生效且绝不污染其他并发用户。
如果连续触发了 2 次 ModelRetry 模型依然改不对,后端该怎么捕获降级?
当重试次数耗尽(超过 retries=2 设定的预算)仍未通过输出校验时,Pydantic AI 会抛出明确的 UnexpectedModelBehavior 异常。生产接口中建议在 agent.run() 外层捕获该异常,记录下 capture_run_messages() 里的完整工具交互轨迹用于事后排查提示词漏洞,同时向前端返回一个温和的人工兜底状态(例如将工单转入待人工客服复核队列),保证核心业务链路永不白屏报错。
搭好开源框架后,国内没有外币信用卡怎么开通主力编程与大模型订阅?
可在 本站 AI 会员充值中心 使用支付宝、微信支付或 AlipayHK 自助选购卡密,支持免交密码兑换 Claude Code(Pro / Max)、ChatGPT Plus 与 ChatGPT Pro,并支持开具增值税发票;实时价格与售后边界(封号不在质保范围)以对应商品页说明为准。
小结
- 通过
@dataclass搭配deps_type与RunContext[Deps],实现零全局变量、完美支持静态类型检查与单测替身的依赖注入。 - 用
@agent.output_validator配合raise ModelRetry("具体纠错指引"),把数据库查无此单等业务幻觉拦截在闭环内部自动重修。 - 将
Agent定义为无状态模块级单例,配合ModelFallback挂载跨厂商备用官方模型,轻松扛住单点接口限流抖动。
0 条评论
还没有评论,来抢沙发~