
当你的大模型应用从简单的“一问一答”演进到“先检索知识库 -> 让模型自检相关性 -> 如果没搜准自动改写查询词再搜一遍 -> 最后综合生成带引用答案”的闭环时,早期的有向无环链(DAG Chains)就彻底不够用了,因为链条很难优雅地表达循环回跳(Loops)与动态并行扇出。
目前 Python 生态里解决这个痛点有两大主流学派:一派是以显式全局状态机和连边著称的 LangGraph,另一派就是 LlamaIndex 官方全面主推的 LlamaIndex Workflows(事件驱动异步工作流)。下面先帮你把两者的选型账算明白,再用一份可直接运行的自纠错检索代码带你快速入门。
AI 全栈开发订阅配套入口:在本地部署与联调开源 AI 框架时,搭配固定月费的终端编程智能体与旗舰推理订阅能大幅缩短排错时间。国内无境外信用卡可在本站通过支付宝、微信支付或 AlipayHK 免密自助开通 Claude Code 订阅、ChatGPT Plus / Pro 或查看 AI 会员充值总览。
一、选型不纠结:LlamaIndex Workflows 与 LangGraph 到底怎么挑
很多架构师在启动新项目时都会对比这两套框架(低代码与代码级平台全局对比可先参考 Dify、Coze、n8n 与 LangGraph 选型指南)。其实它们没有绝对高下,核心区别在于你更习惯写“事件订阅函数”还是画“严格状态转换图”:
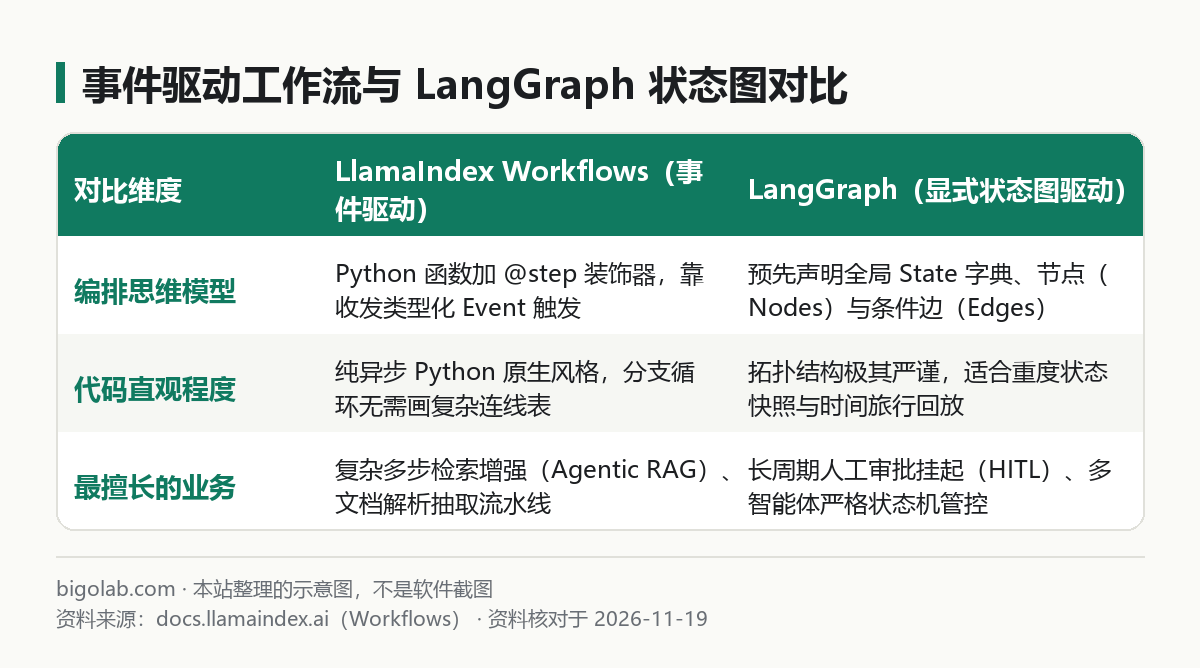
给出一条非常接地气的团队选型标尺:
- 优先选 LlamaIndex Workflows:如果你的核心业务重度围绕复杂文档解析、多源混合检索(Agentic RAG)、财报合同多步抽取校验,且团队后端更喜欢像写 FastAPI 路由那样“给普通异步函数加个
@step装饰器、靠 Python 类型注解自动推导上下游”,Workflows 的代码量极其清爽,没有任何多余的连线样板代码。 - 优先选 LangGraph:如果你的系统核心难点在于跨数天挂起等待人类经理点审批按钮(Human-in-the-Loop)、极其严格的多智能体主管派单状态快照回滚(详见 LangGraph 多智能体 Supervisor 与子图架构),显式状态图的可控度更强。
二、搞懂四个核心积木:Event、@step、Start/Stop 与 Context
在 LlamaIndex Workflows 里,你完全不需要手动调用类似 add_edge(A, B) 的连线函数。框架在启动瞬间会直接扫描每个异步方法的入参类型和返回值类型注解(Type Hints),自动把整张异步执行网络拼装出来:
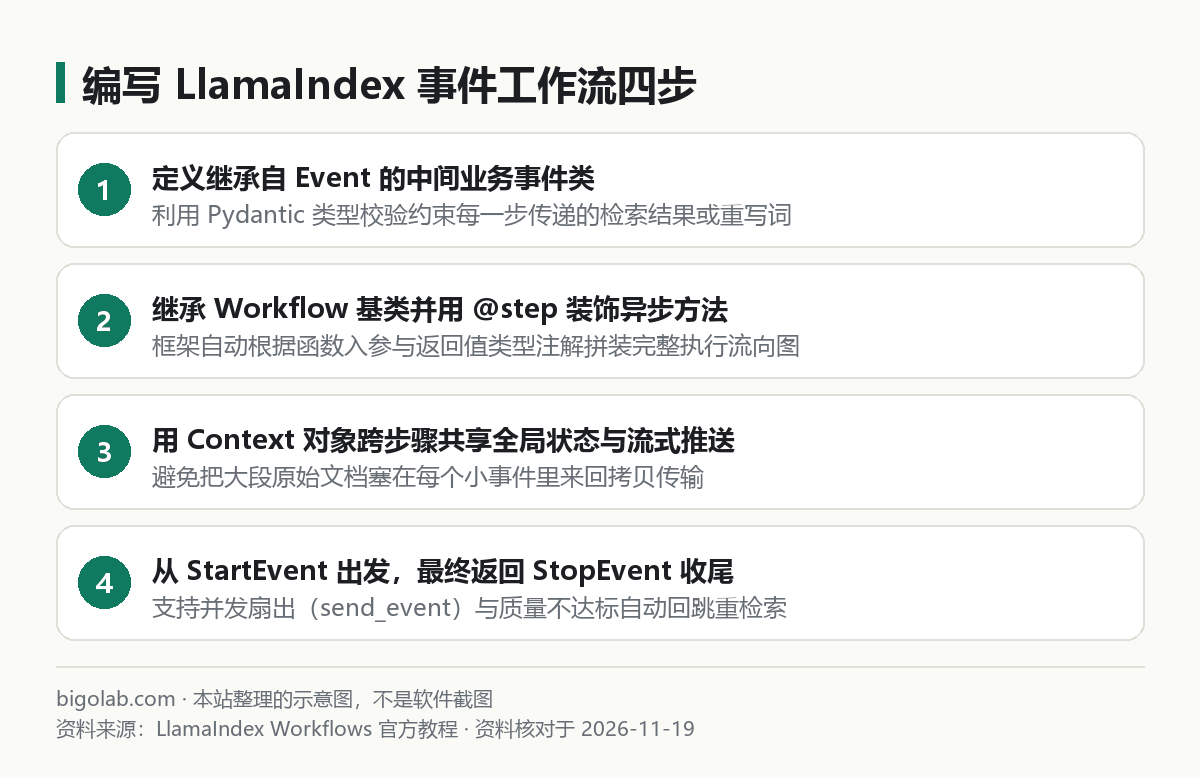
StartEvent与StopEvent:一头一尾两个官方内置锚点。接收StartEvent的步骤是工作流唯一入口;只要任意一个步骤返回了StopEvent(result=...),整趟任务立即收工并把结果交还调用方。- 自定义
Event(继承自 PydanticBaseModel):步骤与步骤之间传递的信封,自带强类型字段校验。 @step装饰器:贴在Workflow子类的async def方法头上。支持联合类型注解(如-> RerankEvent | RewriteQueryEvent),这就是它实现条件分支与循环回跳的全部秘密——根本不用额外写条件路由表。Context(全局共享上下文):如果原始文档很大,没必要塞在每个事件对象里拷来拷去;在函数签名里声明ctx: Context,即可用键值存储安全读写跨步状态(例如记录“当前已经重试改写了几次查询词”防死循环)。
研发团队订阅与高配额省心方案:调试复杂多步智能体循环、RAG 切片策略与 CI 评测流水线非常消耗单日 Token。个人主力开发推荐免上号兑换 Claude Pro iOS 自助卡密 或 5 倍额度的 Claude Max 5x,多人研发团队协同亦可联系客服定制 ChatGPT Business 团队版。
三、完整实战代码:手写一个“搜不准自动改词重搜”的自纠错工作流
安装轻量工作流核心包(pip install llama-index-core 或独立包 pip install llama-index-workflows),保存下面这段零外部数据库依赖的骨架代码即可直接跑通循环控制逻辑:
python
import asyncio
from llama_index.core.workflow import (
    Workflow,
    step,
    Event,
    StartEvent,
    StopEvent,
    Context,
)

# 1. 定义步骤间流转的强类型业务事件
class RetrievedEvent(Event):
    query: str
    docs: list[str]

class RewriteEvent(Event):
    original_query: str
    reason: str

# 2. 组装自纠错检索工作流:无需手写一行 add_edge 连线代码
class CorrectiveRAGWorkflow(Workflow):
    @step
    async def retrieve(self, ctx: Context, ev: StartEvent | RewriteEvent) -> RetrievedEvent:
        if isinstance(ev, StartEvent):
            query = ev.topic
            await ctx.store.set("retries", 0)
        else:
            # 收到回跳的重写事件时,优化检索词再次查询
            query = f"{ev.original_query} 生产环境部署参数详解"

        # 此处替换为真实向量库或混合检索引擎查询
        mock_docs = ["vLLM 分页注意力架构简述"] if "参数详解" not in query else ["vLLM 生产启动需配置 --max-model-len 与 --gpu-memory-utilization"]
        return RetrievedEvent(query=query, docs=mock_docs)

    @step
    async def grade_and_answer(self, ctx: Context, ev: RetrievedEvent) -> RewriteEvent | StopEvent:
        retries = await ctx.store.get("retries", default=0)
        joined = "\n".join(ev.docs)

        # 若检索片段未包含具体配置参数且未超重试上限,触发事件自动回跳上一环节
        if "--" not in joined and retries < 2:
            await ctx.store.set("retries", retries + 1)
            return RewriteEvent(original_query=ev.query, reason="首轮片段缺少具体命令行参数")

        return StopEvent(result=f"最终核验通过(重试 {retries} 次),参考依据:{joined}")

async def main():
    wf = CorrectiveRAGWorkflow(timeout=60, verbose=True)
    result = await wf.run(topic="vLLM 显存配置")
    print(result)

if __name__ == "__main__":
    asyncio.run(main())
仔细看第 23 行的入参注解 ev: StartEvent | RewriteEvent 和第 35 行的返回注解 -> RewriteEvent | StopEvent:仅仅靠标准 Python 类型声明,就天然闭环了“首轮检索 -> 质量打分不达标 -> 抛回 RewriteEvent 重搜 -> 二次达标吐出 StopEvent”的完整循环,并且内置了 timeout=60 全局防卡死熔断。
在工程落地阶段调试这类异步多分支智能体代码时,配合高水准的终端编程助手与旗舰推理模型能大幅缩短排错时间。需要开通海外官方开发订阅的工程师,可前往查看贝果研究社 Claude Code 订阅与配置方案或全站 AI 订阅自助导航。
常见问题
如果我不小心把两个 @step 的类型注解写拼错了导致死路断流,要等到线上跑崩才发现吗?
不会。LlamaIndex Workflows 内置了静态图连通性校验器与可视化工具:启动前它会立刻检查是否存在“某个事件被抛出了却没有任何步骤订阅接收”或者“永远无法抵达 StopEvent”的孤岛错误并直接报出清晰异常;你还可以调用内置绘图辅助函数一键把当前类的事件流转拓扑导出成交互式 HTML 结构图贴进技术评审文档。
怎么让某一步同时并发跑三个子查询、等三个结果全回来再汇总?
在需要扇出(Fan-out)的步骤里,调用 ctx.send_event(SubQueryEvent(...)) 连续发射三次子事件;然后在负责汇总(Fan-in)的下游步骤里调用 **ctx.collect_events(ev, [ResultEvent] 3)*。在凑齐 3 份返回结果之前汇总步骤会优雅挂起返回 None,一旦第 3 份结果抵达便立即向下执行合并总结。
搭好开源框架后,国内没有外币信用卡怎么开通主力编程与大模型订阅?
可在 本站 AI 会员充值中心 使用支付宝、微信支付或 AlipayHK 自助选购卡密,支持免交密码兑换 Claude Code(Pro / Max)、ChatGPT Plus 与 ChatGPT Pro,并支持开具增值税发票;实时价格与售后边界(封号不在质保范围)以对应商品页说明为准。
小结
- LlamaIndex Workflows 采用纯异步事件驱动架构,靠
@step方法的 Python 类型注解自动推导完整拓扑,彻底省去繁琐的连边样板代码。 - 文档密集型多步检索(Agentic RAG)与抽取流水线优先选 Workflows;重度长周期挂起审批与严格全局状态机管控优先选 LangGraph。
- 编写循环回跳逻辑时,务必在
Context存储中维护最大重试计数器并给Workflow(timeout=...)设好全局超时兜底。
0 条评论
还没有评论,来抢沙发~