
自己动手开发 AI 客服、私人学习伴侣或团队研发助手时,很快就会撞上一道必考题:怎么让智能体隔了一个月还能记住“这位用户是素食者、后端只用 Python FastAPI、讨厌长篇寒暄”?
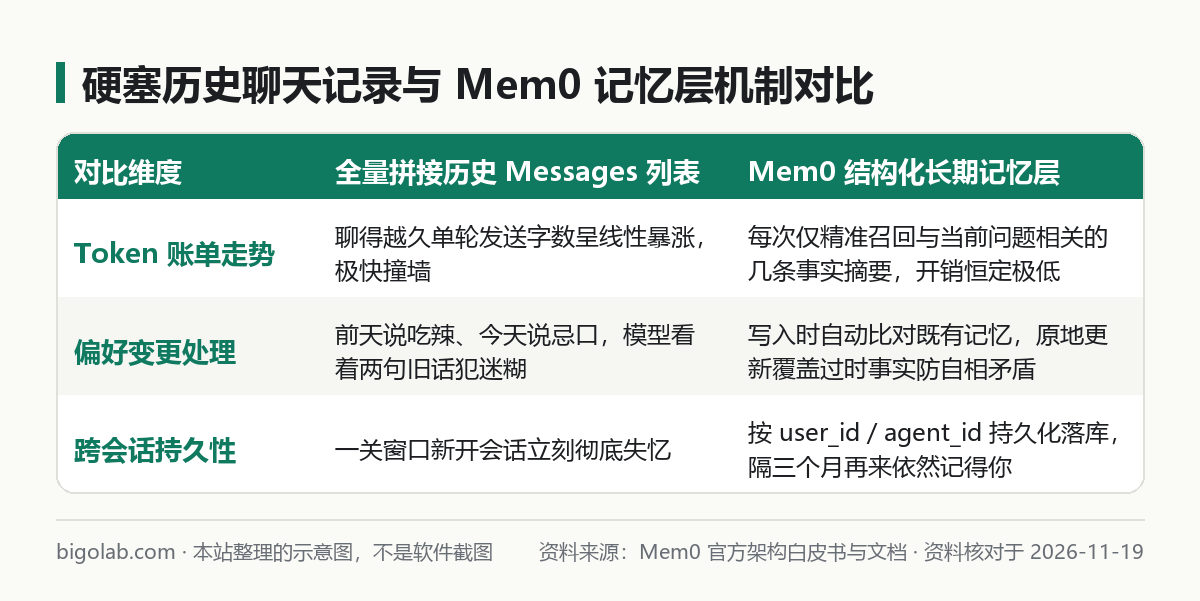
如果采用最原始的办法——每次提问都把该用户过去半年的几百条聊天记录(Messages)原封不动拼进上下文发给大模型,不仅单轮 API 账单会呈指数级爆炸,而且当用户上个月说“我在上海工作”、这个月说“我刚搬到深圳定居”时,大模型同时看着两句前后矛盾的历史废话反而会不知所措。
开源长期记忆层框架 Mem0(包名 mem0ai)专门用来充当智能体与向量数据库之间的“智能记忆提炼管家”。如果你之前了解过 LangGraph 基于 Postgres 的会话检查点与存储 或 用记忆服务替代编辑器旧版自动记忆,用 Mem0 只需十来行 Python 代码就能给任何独立后端接上自更新的个性化记忆底座。
AI 全栈开发订阅配套入口:在本地部署与联调开源 AI 框架时,搭配固定月费的终端编程智能体与旗舰推理订阅能大幅缩短排错时间。国内无境外信用卡可在本站通过支付宝、微信支付或 AlipayHK 免密自助开通 Claude Code 订阅、ChatGPT Plus / Pro 或查看 AI 会员充值总览。
一、Mem0 底层到底比普通向量库多干了哪一步
很多人误以为 Mem0 只是对向量数据库做了一层简单的 insert 封装,其实它的核心价值藏在 m.add() 写入瞬间:
- 事实抽水脱敏:你传进去一段十来句的口水聊天,Mem0 会先调一次轻量模型,只把里面有长期保留价值的客观事实与偏好(例如
"后端框架偏好 FastAPI,包管理固定用 uv")提炼成精简词条,把“你好”、“谢谢”等寒暄垃圾全部扔掉。 - 冲突自动覆盖合并(Update / Delete):写入新词条前,它会自动检索该用户名下已有的相似旧记忆。如果发现旧库里写着
"居住城市:上海",而最新对话提到"已搬家至深圳",它会自动执行原地更新(Update)把过期旧记忆改掉,从根源上消灭新旧偏好打架。
二、Python 四步实战:安装、绑定配置与按 user_id 隔离读写
在虚拟环境中安装官方开源包:
bash
pip install mem0ai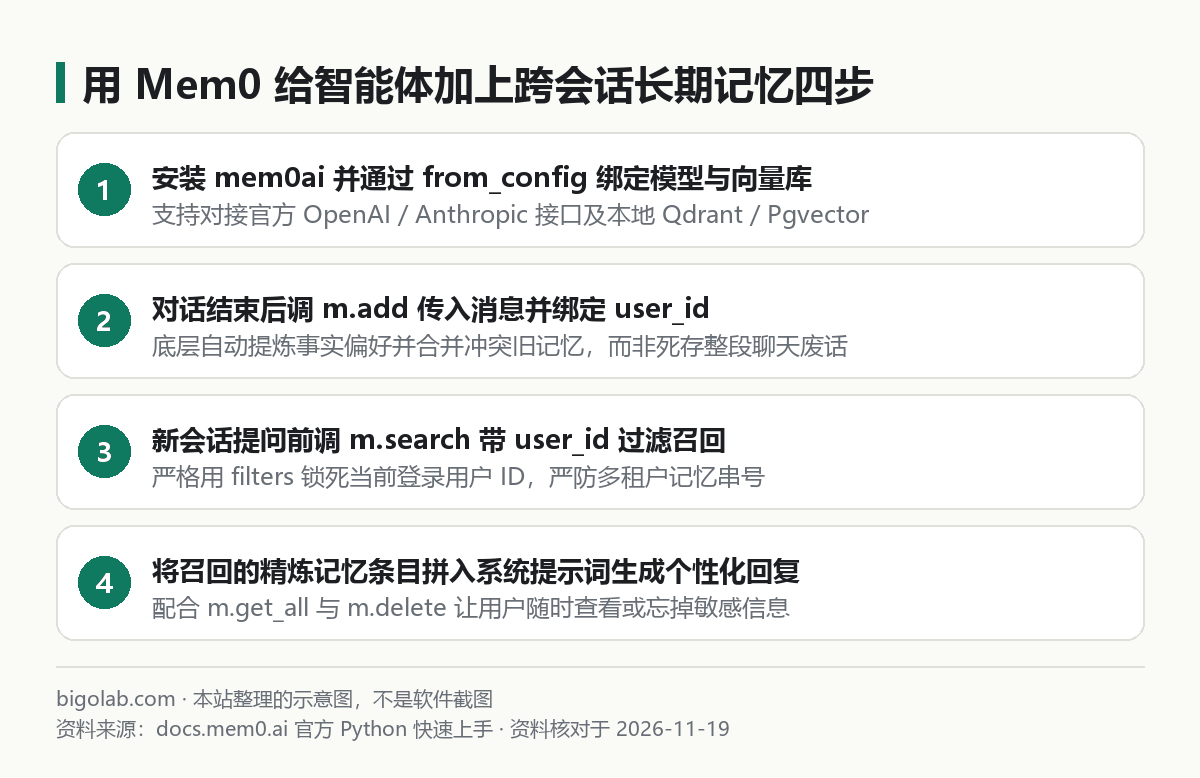
下面是一份生产开发最实用的完整示例:显式使用 Memory.from_config() 指定轻量提取模型与本地持久化 Qdrant 向量目录,并严格按 user_id 隔离不同用户的私密记忆:
python
import os
from openai import OpenAI
from mem0 import Memory

# 1. 自定义底层提炼模型与本地持久化向量库路径(亦支持切换 Anthropic 或 Pgvector)
config = {
    "llm": {
        "provider": "openai",
        "config": {
            "model": "gpt-4o-mini",
            "temperature": 0.1,
        },
    },
    "vector_store": {
        "provider": "qdrant",
        "config": {
            "path": "./local_mem0_qdrant",
        },
    },
}

memory = Memory.from_config(config)
llm_client = OpenAI(api_key=os.getenv("OPENAI_API_KEY"))

def chat_with_memory(user_id: str, user_input: str) -> str:
    # 2. 提问前:严格带上 filters={"user_id": ...} 召回与当前话题最相关的历史记忆
    related = memory.search(query=user_input, filters={"user_id": user_id}, limit=5)
    items = related.get("results", related) if isinstance(related, dict) else related
    mem_context = "\n".join(f"- {item['memory']}" for item in items)

    # 3. 拼入系统提示词,仅消耗几十个 Token 即可实现千人千面回复
    system_prompt = f"你是贴心的技术顾问。以下是该用户的已知长期背景偏好:\n{mem_context}"
    resp = llm_client.chat.completions.create(
        model="gpt-4o-mini",
        messages=[
            {"role": "system", "content": system_prompt},
            {"role": "user", "content": user_input},
        ],
    )
    answer = resp.choices[0].message.content

    # 4. 回复后(生产环境建议放入后台异步队列):提炼本轮新事实归档至该 user_id 名下
    memory.add(
        messages=[
            {"role": "user", "content": user_input},
            {"role": "assistant", "content": answer},
        ],
        user_id=user_id,
    )
    return answer

if __name__ == "__main__":
    uid = "dev_user_001"
    # 第一天会话写入偏好
    memory.add("我平时只写 TypeScript + PostgreSQL,代码示例请一律不要用 class 类写法。", user_id=uid)
    # 隔周新开窗口直接提问,自动按偏好作答
print(chat_with_memory(uid, "帮我写一段连接数据库查询用户列表的示例函数"))研发团队订阅与高配额省心方案:调试复杂多步智能体循环、RAG 切片策略与 CI 评测流水线非常消耗单日 Token。个人主力开发推荐免上号兑换 Claude Pro iOS 自助卡密 或 5 倍额度的 Claude Max 5x,多人研发团队协同亦可联系客服定制 ChatGPT Business 团队版。
三、上生产前必看的三个工程与隐私避坑点
把这段演示逻辑搬进真实多用户 SaaS 系统前,务必守住下面三条铁律:
- 严防多租户串号泄漏:调用
memory.search()、memory.get_all()或memory.delete_all()时,每一次都必须显式传准经过后端登录态校验的真实user_id(切勿直接信任前端请求体传过来的裸 ID),否则甲用户的私人业务数据可能会被检索塞进乙用户的提示词里酿成严重安全事故。 - 把
memory.add()拆到后台异步执行:因为add()内部需要调一次轻量大模型做事实抽取与去重比对,如果同步卡在接口返回前执行,会让前端用户感觉首字回复慢了一两秒。最佳做法是先把大模型生成的回答流式推给前端,同时用 FastAPI 的BackgroundTasks或消息队列在后台静默跑memory.add()。 - 给用户留出“查看与遗忘”面板:合规的商业产品应当允许用户管理 AI 记住了自己什么。利用
memory.get_all(user_id=uid)把词条列表展示在用户个人设置页,每条旁边放一个删除按钮绑定memory.delete(memory_id=...),既透明体面又符合数据隐私规范。如果你想在内网纯离线环境运行,Mem0 同样支持把llm与embedder提供方全部切换为本地 Ollama 服务。
日常搭建智能体后端架构与联调多组件逻辑时,搭配强力的官方编程订阅能显著加快开发验证速度。需要开通直连开发订阅的同学,可前往查看贝果研究社 Claude Code 订阅与配置方案或 ChatGPT Plus 自助充值专页。
常见问题
除了按人类 user_id 隔离,多个不同职责的子智能体之间能分开存记忆吗?
可以。Mem0 原生内置了三个正交的命名空间维度:user_id(针对具体终端客户)、agent_id(针对不同工种智能体各自积累的经验)以及 run_id(仅限单次长程任务周期内的短期工作记忆)。你可以单独使用其中任意一个,也可以组合过滤实现极其精细的权限分层。
提炼记忆调用的模型一定要和主对话一样用最贵的旗舰模型吗?
完全没必要,甚至不推荐用慢速重型推理模型跑 memory.add()。事实抽取与冲突合并属于模式非常固定的结构化小任务,在 config["llm"] 里绑定响应极快、单价极低的轻量高性价比模型(如各家官方的 Mini / Haiku / Flash 档模型),就能以忽略不计的成本跑出非常干净的记忆词条。
搭好开源框架后,国内没有外币信用卡怎么开通主力编程与大模型订阅?
可在 本站 AI 会员充值中心 使用支付宝、微信支付或 AlipayHK 自助选购卡密,支持免交密码兑换 Claude Code(Pro / Max)、ChatGPT Plus 与 ChatGPT Pro,并支持开具增值税发票;实时价格与售后边界(封号不在质保范围)以对应商品页说明为准。
小结
- Mem0 不是死存原始聊天记录,而是在
m.add()时自动提炼高价值事实并原地覆盖过时冲突信息,让长期对话的 Token 开销保持恒定低位。 - 多租户系统调用
m.search()时务必通过filters={"user_id": ...}锁死经过鉴权的用户身份,严防跨用户记忆串号。 - 生产环境将
m.add()放入后台异步任务队列执行免拖慢前端响应,并搭配轻量快速模型与用户自助删除入口兼顾成本与隐私合规。
0 条评论
还没有评论,来抢沙发~