
结论先说
- LangGraph 不需要改任何节点内部业务代码就能接上 Langfuse:只需在调用
graph.invoke或astream时,通过config={"callbacks": [langfuse_handler]}传入回调处理器。 - 注意新版导入路径变化:Langfuse Python SDK 新版统一从
from langfuse.langchain import CallbackHandler导入,自动把整张状态图的节点跳转、条件分支与工具调用串成一棵完整的嵌套调用树(Trace)。 - 一次性命令行脚本退出前务必调用刷新(Flush):Langfuse 默认在后台异步批量上报日志,脚本跑完立刻退出进程会导致队列里的数据还没发出去就被掐断。
- 企业内网合规零改造切换:代码完全不变,只需把环境变量
LANGFUSE_HOST从官方云地址改成你们内网自建的 Langfuse 地址,敏感提示词就绝不出内网。
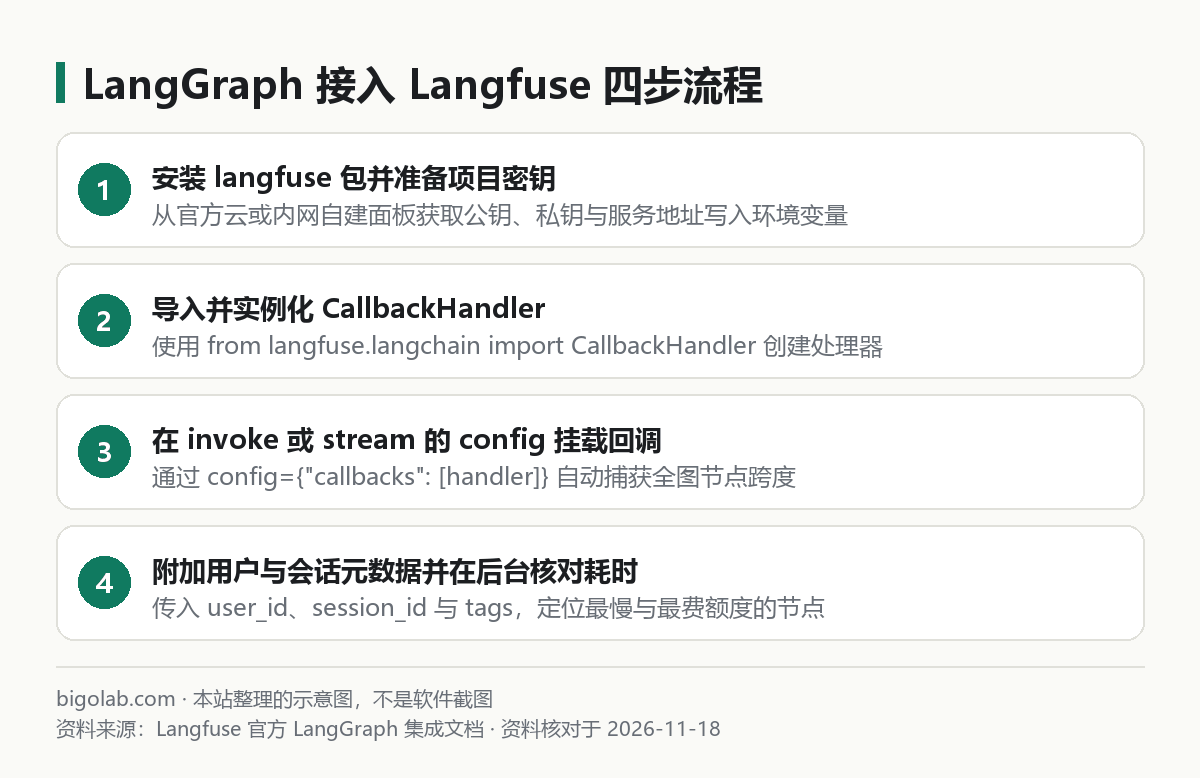
图:本站根据 Langfuse 官方 LangGraph 集成文档 整理的示意图
本文根据 Langfuse 官方 LangChain / LangGraph 集成文档与开源仓库说明整理,核对日期 2026-11-18。配图为本站整理的示意图,不是界面截图。本站(bigolab.com)不是 Langfuse 或 LangChain 官方网站。
适用于谁
- 搜「langgraph 使用 langfuse」「langgraph 接入开源链路追踪」的人;
- 选择了免费开源库自建部署(计费对比见 /guides/langgraph-pricing-open-source-vs-platform),需要一套能私有化部署在内网、看清每个节点耗时和 Token 账单的可观测面板的后端团队;
- 配完回调运行脚本后,发现 Langfuse 后台空空如也、一条记录都没收到的开发者。
如果你还在开发期做单步改状态调试,优先用本地 Studio(见 /guides/langgraph-debug-visualize-studio-guide);上了测试和生产环境监控真实用户请求,就轮到 Langfuse 上场了。
一、第一步:安装依赖与配置三项环境变量
在已经装好 langgraph(基础环境见 /guides/langgraph-quickstart-install-first-graph)的虚拟环境里安装 langfuse:
bash
pip install -U langfuse langgraph langchain-openai
登录 Langfuse 后台(官方云或你们自己的私有实例)创建一个项目,拿到公钥和私钥后写入系统环境变量或 .env 文件:
bash
export LANGFUSE_PUBLIC_KEY="pk-lf-你的公钥"
export LANGFUSE_SECRET_KEY="sk-lf-你的私钥"
# 欧区默认云、美区云或内网自建地址按实际项目填写:
export LANGFUSE_HOST="https://cloud.langfuse.com"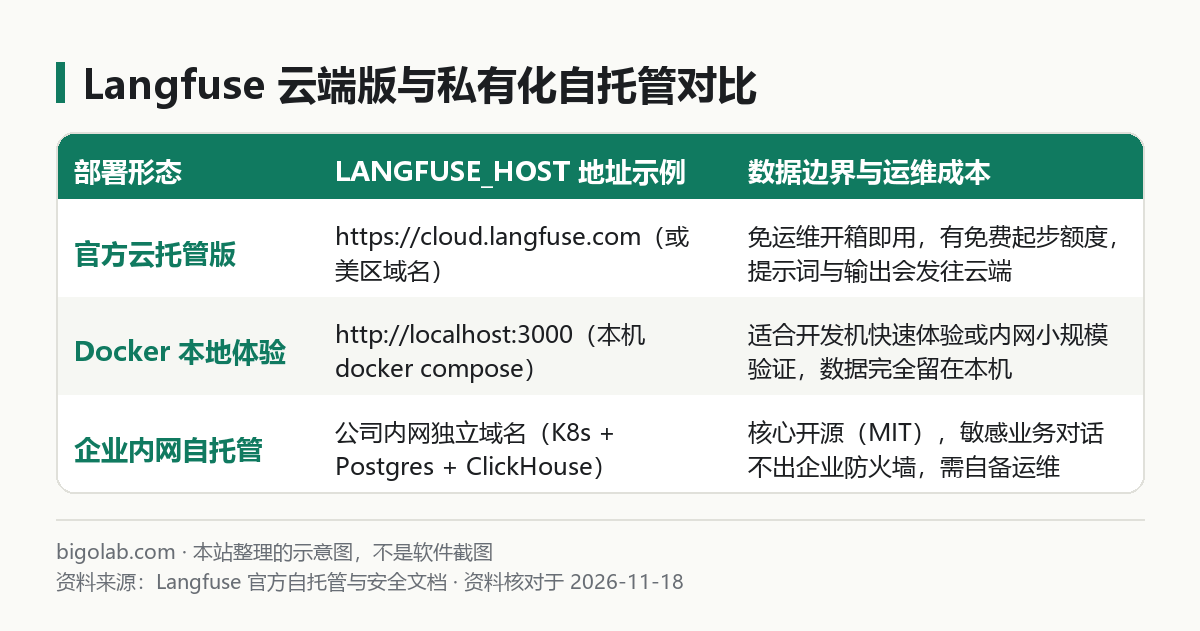
图:本站根据 Langfuse 官方自托管与安全文档 整理的示意图
二、第二步:挂载 CallbackHandler 追踪完整状态图
无需给每个 Python 节点函数挨个加装饰器,LangGraph 在运行期会自动把顶层 config 里的 callbacks 向下透传给图里的所有大模型调用、ToolNode 工具执行以及嵌套子图。
python
from langchain_core.tools import tool
from langchain_openai import ChatOpenAI
from langgraph.graph import StateGraph, MessagesState, START, END
from langgraph.prebuilt import ToolNode, tools_condition
from langfuse import get_client
from langfuse.langchain import CallbackHandler

@tool
def check_order_status(order_id: str) -> str:
    """查询指定订单号的物流状态。"""
    return f"订单 {order_id} 已发出,预计明日送达"

tools = [check_order_status]
llm = ChatOpenAI(model="gpt-4o-mini", temperature=0).bind_tools(tools)

def agent_node(state: MessagesState):
    return {"messages": [llm.invoke(state["messages"])]}

builder = StateGraph(MessagesState)
builder.add_node("agent", agent_node)
builder.add_node("tools", ToolNode(tools))
builder.add_edge(START, "agent")
builder.add_conditional_edges("agent", tools_condition)
builder.add_edge("tools", "agent")
graph = builder.compile()

if __name__ == "__main__":
    # 1. 初始化回调处理器(自动读取环境变量中的密钥)
    langfuse_handler = CallbackHandler()

    # 2. 在调用图时通过 config 注入 callbacks 与业务元数据
    res = graph.invoke(
        {"messages": [("user", "帮我查一下订单 ORD-8899 到哪了")]},
        config={
            "callbacks": [langfuse_handler],
            "metadata": {
                "langfuse_user_id": "user_42",
                "langfuse_session_id": "chat_thread_001",
                "langfuse_tags": ["order-bot", "prod"],
            },
        },
    )
    print(res["messages"][-1].content)

    # 3. 短生命周期脚本退出前强制把缓冲区日志发完
    get_client().flush()
跑完打开 Langfuse 后台的 Traces 列表,点开最新一条记录,你就能清晰看到顶层 LangGraph 下面依次挂着 agent 首次推理、tools 调用 check_order_status 的入参返回值、以及 agent 第二次汇总回复的耗时与 Token 明细。
三、多轮对话归组与成本审计技巧
在真实多 Agent 生产系统里,光抓单次请求还不够,建议把下面两项配置一起用上:
- 把 LangGraph 的
thread_id同步传给langfuse_session_id:当你的图开启了检查点多轮对话记忆时,把同一个对话线程 ID 同时赋给configurable.thread_id和metadata.langfuse_session_id,后台就能在 Sessions 视图里把用户连续十轮追问按时间线串在一起回看; - 用模型单价表定位高消耗节点:多智能体循环最怕某个子代理暗中跑了十几次重试烧光预算(原因拆解见 /guides/multi-agent-token-cost-why-high-how-to-control)。在 Langfuse 后台按节点名称筛选平均耗时与累计 Token,一眼就能揪出最该降级为轻量模型或加缓存的瓶颈节点。
日常在个人工作站调试多节点提示词并对照官方云端模型输出质量时,如需了解个人 Claude 或 ChatGPT 订阅方案,也可参考 /chongzhi/claude-pro 的整理说明。
常见问题
Q:运行没有报错,但 Langfuse 面板里一直看不到任何 Trace 数据?
按三步排查:第一,检查是不是跑完脚本直接退出了进程但漏写了 get_client().flush()(常驻 FastAPI 服务不需要每次手动 flush,但单次测试脚本必须加);第二,核对 LANGFUSE_HOST 区服是否填错(官方欧洲默认区和美国区地址不同,填反会鉴权失败);第三,确认虚拟环境里没有同时开启冲突的 OpenTelemetry 导出器拦截。
Q:从旧版 Langfuse v2 升级到 v3 后报 ModuleNotFoundError: No module named 'langfuse.callback' 怎么办?
v3 重构了底层采集架构,把导入语句改成 from langfuse.langchain import CallbackHandler,并将原本传在 CallbackHandler(...) 构造函数里的 user_id、session_id 移到 graph.invoke 的 config["metadata"] 里即可平滑迁移。
Q:生产环境里可以把测试集评测(Prompt Management 与 Datasets)也和状态图连起来吗?
可以。你可以在 Langfuse 面板里把线上真实出错的某条用户消息一键加入测试数据集(Dataset),修改节点提示词或切换底层模型后批量重跑整张状态图,客观对比新旧版本在耗时、费用和回答准确率上的变化,不用靠人工凭感觉盲调。
相关教程
- /guides/langgraph-quickstart-install-first-graph:LangGraph Python 安装与第一个状态图
- /guides/langgraph-debug-visualize-studio-guide:LangGraph Studio 可视化调试指南
- /guides/langgraph-pricing-open-source-vs-platform:LangGraph 开源库与商业平台收费边界
- /guides/multi-agent-token-cost-why-high-how-to-control:多 Agent 系统 Token 膨胀根源与控费
参考资料
- Langfuse 官方文档:LangChain & LangGraph Integration — https://langfuse.com/integrations/frameworks/langchain
langfuse/langfuse官方开源仓库 — https://github.com/langfuse/langfuse
0 条评论
还没有评论,来抢沙发~