
结论先说
- 接本机 Ollama 请装官方独立包
langchain-ollama并导入ChatOllama,不要再抄旧教程里已废弃的langchain_community同名类。 - 接 vLLM、LM Studio 或
llama.cpp本地服务,直接用langchain-openai的ChatOpenAI,把base_url指向本地端口即可无缝复用。 - 本地跑图成败的第一前提是模型本身支持原生工具调用(Tool Calling):在 Ollama 模型库里必须挑带有
Tools标签的型号(如qwen2.5、llama3.1等),不支持工具调用的模型无法触发ToolNode。 - 必改参数
num_ctx:Ollama 默认上下文窗口通常只有2048Token,挂上几个工具跑两轮就会截断前文,初始化ChatOllama时务必显式调大num_ctx(如8192或16384)。
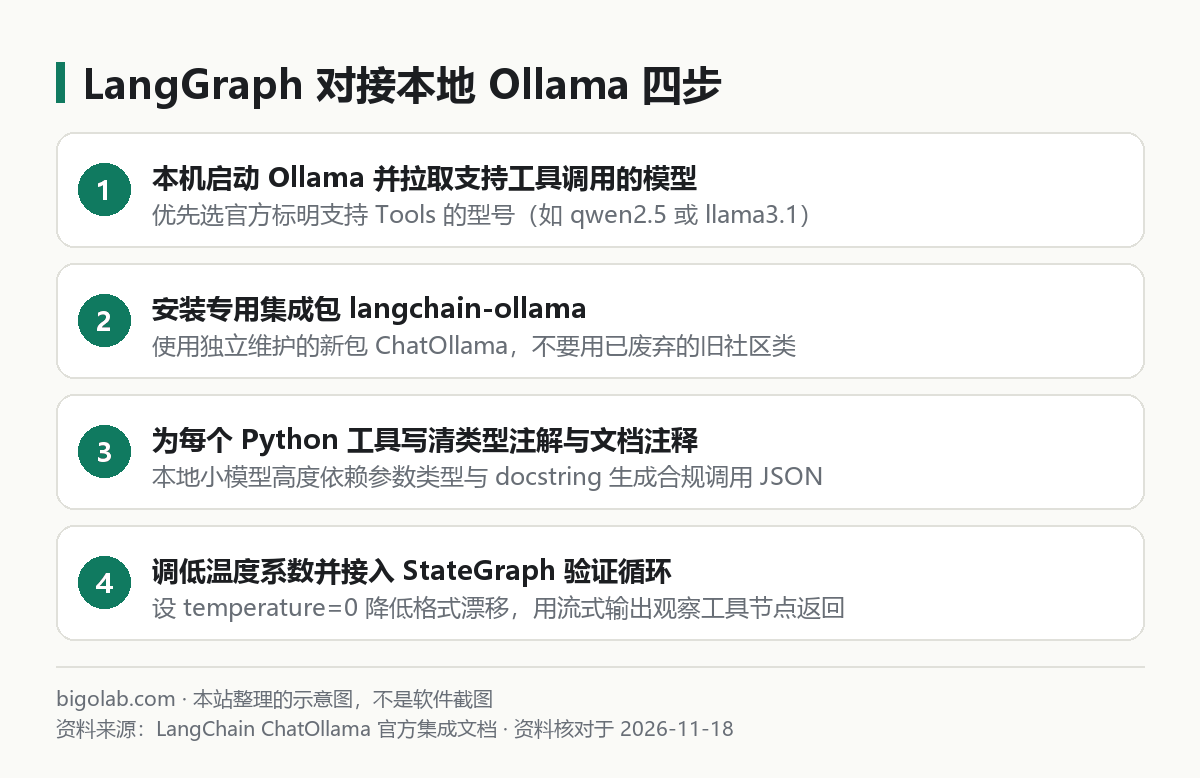
图:本站根据 LangChain ChatOllama 官方集成文档 整理的示意图
本文根据 LangChain 官方langchain-ollama集成文档与 Ollama 官方说明整理,核对日期 2026-11-18。配图为本站整理的示意图,不是界面截图。本站(bigolab.com)不是 LangChain 或 Ollama 官方网站。
适用于谁
- 搜「langgraph 使用 本地 模型」「langgraph 接入 ollama」的人;
- 处于企业内网隔离环境,或者想在本地开发调试阶段免掉云端 API 账单的 Python 开发者;
- 把本地模型接进
StateGraph后,遇到「模型死活不调工具、直接把 JSON 吐在正文里」或「跑两轮就失忆报错」的人。
如果你还没跑通第一个基础状态图,建议先看 /guides/langgraph-quickstart-install-first-graph。
一、准备工作:拉取带 Tools 能力的本地模型与安装包
先确保本机已安装并启动 Ollama,拉取一个明确支持函数工具调用的权重(个人笔记本显存有限可选 7B / 14B 档位,单节点工具数较多时建议 14B 以上准确率更稳):
bash
ollama pull qwen2.5:14b
然后在你的 Python 虚拟环境里安装 langgraph 与专用集成包 langchain-ollama:
bash
pip install -U langgraph langchain-core langchain-ollama
二、完整代码:用 ChatOllama 驱动 StateGraph
新建 local_graph.py。注意我们在初始化 ChatOllama 时显式固定了 temperature=0(减少工具参数格式漂移)和 num_ctx=16384(防止多轮工具输出把系统指令挤出窗口):
python
from langchain_core.tools import tool
from langchain_ollama import ChatOllama
from langgraph.graph import StateGraph, MessagesState, START, END
from langgraph.prebuilt import ToolNode, tools_condition

# 1. 本地模型非常依赖清晰的类型注解和中文/英文文档注释来生成参数结构
@tool
def query_warehouse_stock(sku_code: str) -> str:
    """根据商品编码(如 SKU-101)查询本地仓库当前可用库存数量。"""
    mock_db = {"SKU-101": "剩余 42 件", "SKU-205": "缺货补单中"}
    return mock_db.get(sku_code.upper(), "未找到该商品编码")

tools = [query_warehouse_stock]

# 2. 连接本机 Ollama 服务(默认地址 http://127.0.0.1:11434)
llm = ChatOllama(
    model="qwen2.5:14b",
    temperature=0,
    num_ctx=16384,
).bind_tools(tools)

# 3. 定义推理节点与状态图
def assistant_node(state: MessagesState):
    return {"messages": [llm.invoke(state["messages"])]}

builder = StateGraph(MessagesState)
builder.add_node("assistant", assistant_node)
builder.add_node("tools", ToolNode(tools))

builder.add_edge(START, "assistant")
builder.add_conditional_edges("assistant", tools_condition)
builder.add_edge("tools", "assistant")

graph = builder.compile()

if __name__ == "__main__":
    out = graph.invoke({
        "messages": [("user", "帮我查一下 SKU-101 还有没有货?")]
    })
    for m in out["messages"]:
        m.pretty_print()
如果 Ollama 跑在内网另一台 GPU 服务器上,只需在 ChatOllama(...) 里加上 base_url="http://内网服务器IP:11434" 即可。
三、如果本地跑的是 vLLM 或 LM Studio 怎么接
企业显卡服务器常使用 vLLM 启动高并发推理(开启工具解析参数如 --enable-auto-tool-choice --tool-call-parser hermes),桌面用户则常用 LM Studio 开启本地 HTTP Server。这类服务端都提供标准的 OpenAI /v1 兼容接口,直接用 ChatOpenAI 就能接入同一张图:
python
from langchain_openai import ChatOpenAI

llm = ChatOpenAI(
    model="Qwen/Qwen2.5-14B-Instruct",
    base_url="http://127.0.0.1:8000/v1",
    api_key="EMPTY",  # 本地免鉴权服务随便填非空占位符即可
    temperature=0,
).bind_tools(tools)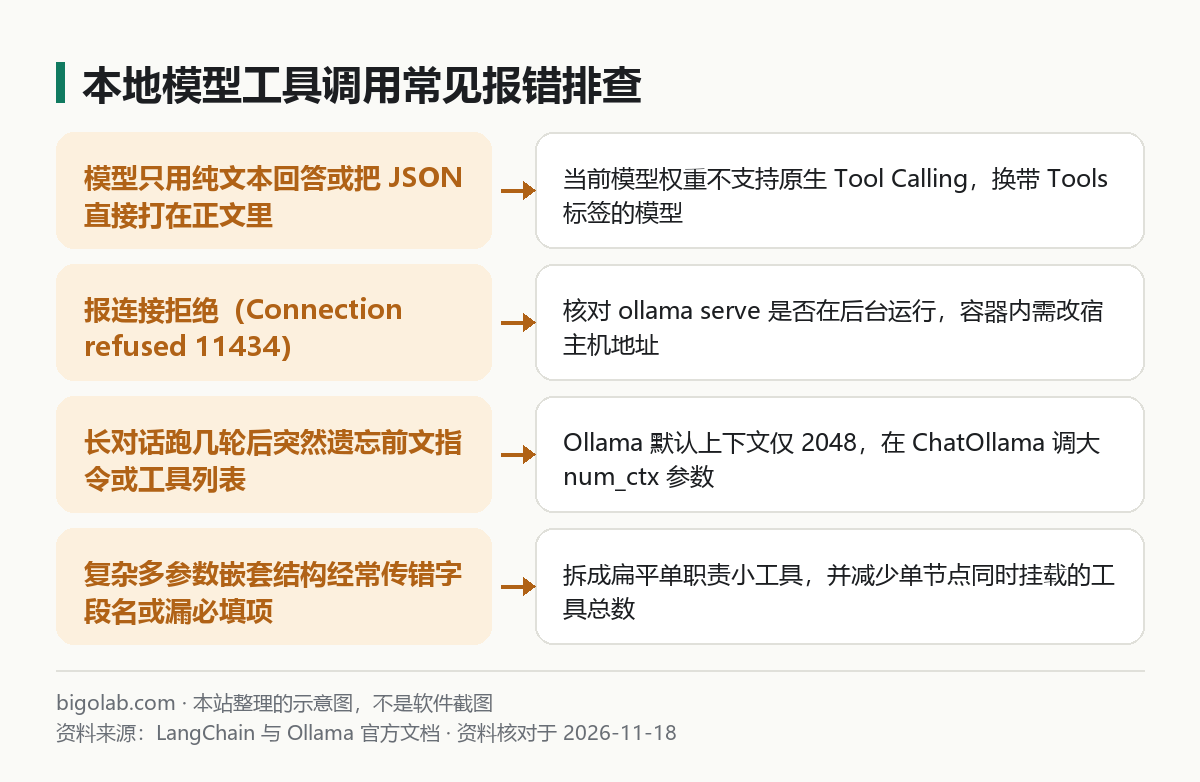
图:本站根据 LangChain 与 Ollama 官方文档 整理的示意图
四、让小参数本地模型在多 Agent 图里不翻车的三个技巧
和云端百亿千亿级旗舰模型相比,7B 到 14B 的本地量化模型在复杂图编排里容错率较低,按下面三条收敛设计成功率会高很多:
- 单个节点挂载的工具不要超过 3 到 5 个:如果你通过 MCP 一次性灌入二十几个工具(接入方法见 /guides/langgraph-mcp-integration-guide),本地小模型极易选错工具或填错字段。按业务拆成专职节点,每个节点只绑两三个扁平参数工具;
- 需要强制返回 JSON 时用
with_structured_output:做前置意图路由节点时,定义 Pydantic 模型调用llm.with_structured_output(RouteSchema),利用底层的语法约束(Grammar / JSON Schema)锁死输出格式,别靠提示词求它「请不要输出多余文字」; - 采用「本地小模型做前哨 + 云端强模型兜底」混合图:在非涉密场景下,把高频字段清洗、简单分类留给本机免费 Ollama 节点,遇到复杂规划节点再路由给云端强模型(成本拆分思路见 /guides/multi-agent-token-cost-why-high-how-to-control 与 /guides/claude-agent-sdk-vs-langchain-how-to-choose)。平时对照评估本地开源模型与云端前沿模型的真实差距时,个人测试环境也可参考 /chongzhi/claude-pro 的官方套餐说明。
常见问题
Q:为什么模型没有触发 ToolNode,而是在回复正文里打印了一段 {"name": "query_warehouse_stock", ...} 代码块?
两个常见原因:第一,你拉取的模型版本在 Ollama 官方库里不支持原生 Tools 协议模板;第二,忘了把 .bind_tools(tools) 返回的新对象赋给节点里实际调用的变量(注意 llm.bind_tools(tools) 不会原地修改原 llm 对象,必须接住返回值)。
Q:在 Docker 容器里跑 Python 脚本连宿主机 Ollama 报 Connection refused 怎么办?
容器内的 127.0.0.1 指的是容器自己而不是宿主机。在 macOS / Windows 的 Docker Desktop 里把 base_url 改成 http://host.docker.internal:11434,并确认宿主机 Ollama 环境变量配置允许非回环地址监听。
Q:本地深度思考模型(如带思维链标签的推理权重)接进图里要注意什么?
部分推理模型会在正文里输出较长的 <think> 思考过程,不仅占用 num_ctx 窗口,还可能在多轮历史回传时拖慢下一轮首字响应。建议查看 ChatOllama 当前版本支持的推理字段分离参数,或在进入下游节点前只保留精简结论,避免把冗长思考草稿原样塞进后续状态。
相关教程
- /guides/langgraph-quickstart-install-first-graph:LangGraph Python 安装与第一个状态图
- /guides/langgraph-mcp-integration-guide:LangGraph 接入 MCP 工具服务器指南
- /guides/claude-agent-sdk-vs-langchain-how-to-choose:Claude Agent SDK 与 LangChain 选型对比
- /guides/multi-agent-token-cost-why-high-how-to-control:多 Agent 系统成本分析与降本方案
参考资料
- LangChain 官方文档:
ChatOllama集成指南 — https://docs.langchain.com/ - Ollama 官方模型库与文档 — https://ollama.com/
0 条评论
还没有评论,来抢沙发~