
結論先說
- OpenAI 提供兩套原生語音對話路線:回合制 HTTP(
gpt-audio)與全雙工流式(Realtime API)。前者像微信發語音條,複用普通 REST 後端即可接入;後者像打電話,走 WebRTC 或 WebSocket 支持邊聽邊說和隨時打斷。 gpt-audio一次請求同時返回語音字節流與配套文字稿。只需將modalities設為["text", "audio"]並指定audio音色與編碼格式,無需自己串聯三段獨立接口。- 流式與非流式支持的音頻格式不同。一次性非流式返回可直接要
wav或mp3;開啟stream=True低延遲邊收邊播時,輸出格式需指定為無頭部的pcm16。 - 若業務完全不需要情緒感知,拆成「轉寫 + 文本模型 + TTS」往往更省成本。純文字鏈路便於中間審核與檢索落庫。
- 想先在手機或電腦端體驗官方原生實時語音效果,國內缺少境外銀行卡的用戶可在本站自助開通 ChatGPT Plus 或高配額 ChatGPT Pro,企業團隊可諮詢 ChatGPT Business 團隊定製。
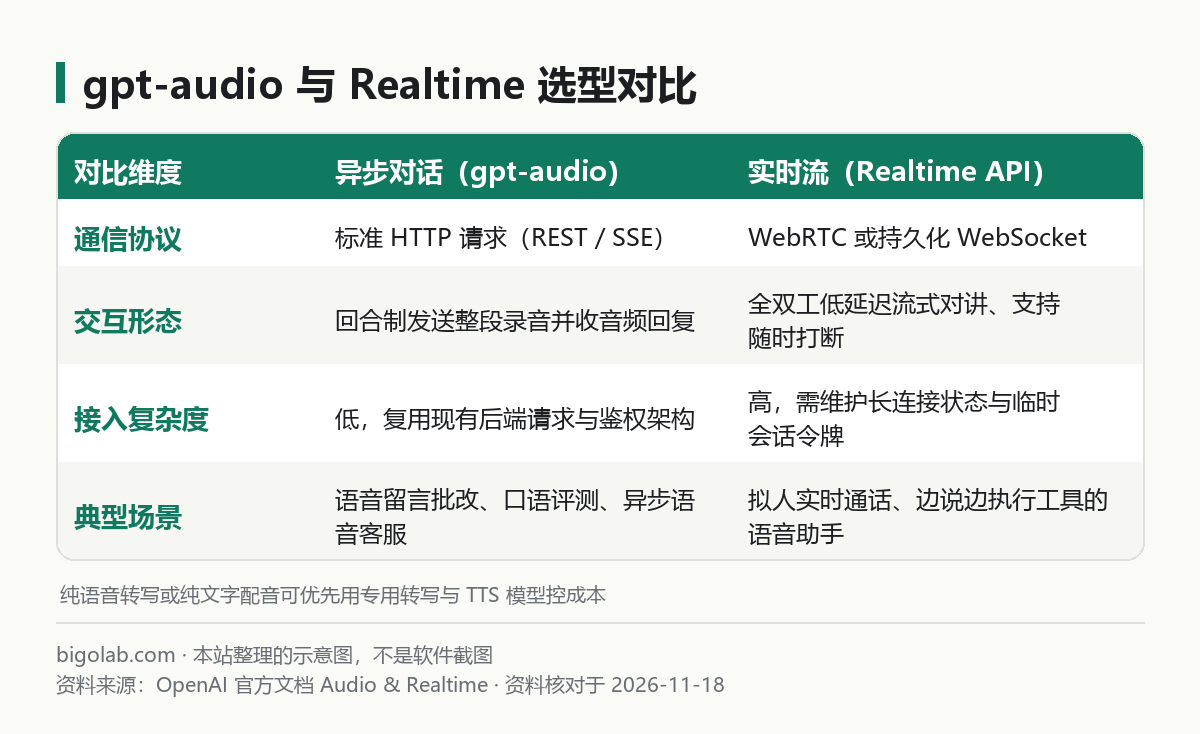
圖:本站根據 OpenAI 官方文檔:Audio and speech 整理的示意圖
本文根據 OpenAI API 官方文檔《Audio and speech》《Realtime API》整理,資料核對於 2026-11-18。配圖為本站整理的示意圖,不是介面截圖。本站(bigolab.com)不是 OpenAI 官方網站。
適用於誰
- 想在小程式、App 或網頁裏做「按住說話發語音、AI 語音加文字回消息」功能,糾結選 HTTP 接口還是 WebSocket 實時流的開發者;
- 希望模型直接感知用戶錄音裏的語氣、停頓與情緒,而不是先轉純文字丟掉聲音細節的人;
- 調用
gpt-audio系列模型時遇到流式音頻格式報錯或多輪歷史拼裝失敗的排查者。
一、三種官方音頻方案怎麼選
結合站內已整理的轉寫配音(見 /guides/openai-api-speech-to-text-text-to-speech)與實時會話(見 /guides/openai-api-realtime),選型對照如下:
| 方案名稱 | 網絡協議 | 核心優勢 | 適用產品形態 |
|---|---|---|---|
gpt-audio 異步對話 | 標準 HTTP / SSE | 接入簡單,原生聽懂語調並同步出音字 | 口語發音糾錯、異步語音留言問答、繪本伴讀 |
| Realtime API | WebRTC / WebSocket | 毫秒級雙向對講、內置語音活動檢測與打斷 | 實時口語陪練、車載語音副駕、電話客服機器人 |
| 轉寫 + 文本 + TTS 串聯 | 標準 HTTP | 中間文本可人工干預修改,單價容易精細拆分 | 會議紀要(參考 /guides/chatgpt-audio-transcription)、長文章朗讀 |
只要你的交互介面有明確的「鬆開發送」動作、不需要用戶在 AI 說話中途插嘴打斷,優先用 gpt-audio 可以省去維護長連接網關的運維負擔。
二、gpt-audio 音頻輸入與輸出 Python 示例
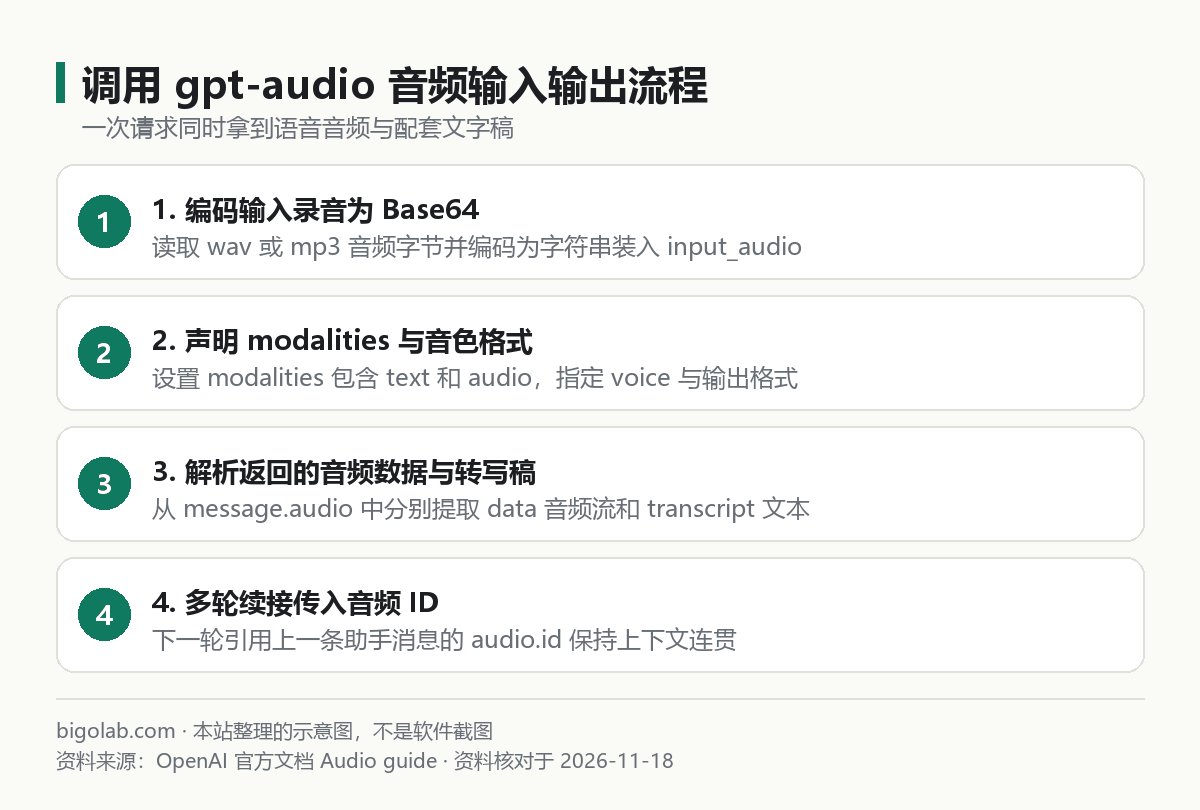
圖:本站根據 OpenAI 官方文檔:Audio and speech 整理的示意圖
下面演示將本地用戶提問錄音 .wav 編碼後傳給 gpt-audio,並把模型回覆的語音存盤、文字打印出來:
python
import base64
from pathlib import Path
from openai import OpenAI

client = OpenAI()

raw_audio = Path("question.wav").read_bytes()
b64_input = base64.b64encode(raw_audio).decode("utf-8")

resp = client.chat.completions.create(
    model="gpt-audio",
    modalities=["text", "audio"],
    audio=dict(voice="alloy", format="wav"),
    messages=[
        dict(
            role="user",
            content=[
                dict(type="text", text="請聽這段英語口語錄音,用中文指出語法和重音問題並示範正確讀法。"),
                dict(type="input_audio", input_audio=dict(data=b64_input, format="wav")),
            ],
        )
    ],
)

msg = resp.choices[0].message
print("文字轉寫稿:", msg.audio.transcript)
Path("reply.wav").write_bytes(base64.b64decode(msg.audio.data))
print("本輪音頻標識:", msg.audio.id)
若只需要「聽錄音回純文字」(比如客服錄音質檢打分),把 modalities 改為 ["text"] 並去掉頂層 audio 參數即可,省去音頻輸出 Token 開銷(價格規則見 /guides/openai-api-price-official-table)。
訂閱與帳號準備提示:音頻 Token 單價顯著高於純文本 Token,個人日常練口語或做外語模擬面試直接用官方客戶端語音模式更划算。國內用戶可在本站開通 ChatGPT Plus 會員 或更高配額的 ChatGPT Pro 充值,支持卡密自助兌換。
三、多輪上下文續接與常見報錯注意事項
- 多輪對話傳
audio.id而非重傳整段 Base64:進行第二輪追問時,把上一輪助手消息按dict(role="assistant", audio=dict(id=msg.audio.id))追加進messages數組即可(服務端緩存的音頻引用有存活時限,過期後可回退為傳transcript文本)。 - 開啟流式
stream=True報格式不支持:流式分塊傳輸無法提前寫入wav文件頭的總長度字節,因此官方規定流式下audio.format必須填pcm16,客戶端按採樣率直接送入聲卡緩衝區播放。 - 輸入音頻格式限制:
input_audio.format目前主要接受wav與mp3;如果前端手機瀏覽器錄出的是webm或m4a,需先在服務端用ffmpeg轉封裝後再編碼傳入。
常見問題
問:gpt-audio 支持在對話中途調用外部函數(Function Calling)嗎?
答:支持。和常規文本對話一樣傳入 tools 定義即可;當模型判定需要查天氣或查訂單時,會先返回 tool_calls,你回傳工具執行結果後,它再用自然語音把查詢結果播報出來。
問:有哪些官方內置音色(voice)可以選?
答:官方提供 alloy、ash、ballad、coral、echo、sage、shimmer、verse 等多款預設音色,具體可用音色列表以官方文檔當天展示為準,建議在業務裏固定同一款音色保持人設一致。
問:國內沒有外幣卡,或者公司需要開增值稅發票報銷,怎麼開通官方 ChatGPT 訂閱體驗高級語音?
答:可通過本站 AI 會員充值總覽 選購 ChatGPT Plus 或 ChatGPT Pro,支持支付寶、微信支付及 AlipayHK,支持卡密自助兌換與企業定製,並可開具增值稅發票。實時價格以頁面顯示為準;售後遵循掉訂閱按剩餘天數折退、封號不在質保範圍的規則。
相關教學
- OpenAI API 語音轉文字和文字轉語音怎麼調
- OpenAI Realtime API 是什麼:WebRTC 與 WebSocket 會話
- ChatGPT 音頻轉文字:上載錄音生成文字稿
- OpenAI API 價格表與計費說明
參考資料
- OpenAI API 官方文檔:Audio and speech — https://platform.openai.com/docs/guides/audio
- OpenAI API 官方文檔:Realtime API — https://platform.openai.com/docs/guides/realtime
0 條評論
還沒有評論,來搶沙發~