
結論先說
- 額度掉得快,核心原因是「上下文滾雪球 + 高推理隱藏 Token + 高速倍率」三重疊加。Codex 並不是按「發了幾條消息」固定扣次,而是按實際消耗的 Token 綜合核算;每一輪新提問都會把歷史聊天與前幾輪粘貼的整屏報錯日誌重新送進模型,高推理檔位的內部思考鏈也全部計入用量。
- 先調「模型檔位」與「推理強度」立竿見影。改字段、寫常規單測、補文檔這類確定性任務,沒必要常駐旗艦模型配
high/xhigh推理;平時預設設為中等或輕量模型加low/medium強度,遇到跨模組架構重構再臨時拉高。 - 非緊急上線別常開 Fast / Ultrafast 加速模式。高速推理模式調用高優算力通道,會顯著加快配額折算消耗;日常編碼切回標準速度模式,省下來的額度最直觀。
- 養成「一件事一個會話」習慣,長對話及時
/compact或/new。不要在同一個窗口裏從週一聊到週五,也不要讓測試命令吐出上萬行完整日誌塞滿上下文。 - 如果你日常就是全天候重度編碼,省流之外更適合直接匹配更高配額套餐。國內缺少外幣卡的用戶可在本站自助開通 ChatGPT Plus 或直接升級高配額 ChatGPT Pro,團隊多人研發可了解 ChatGPT Business 團隊定製。
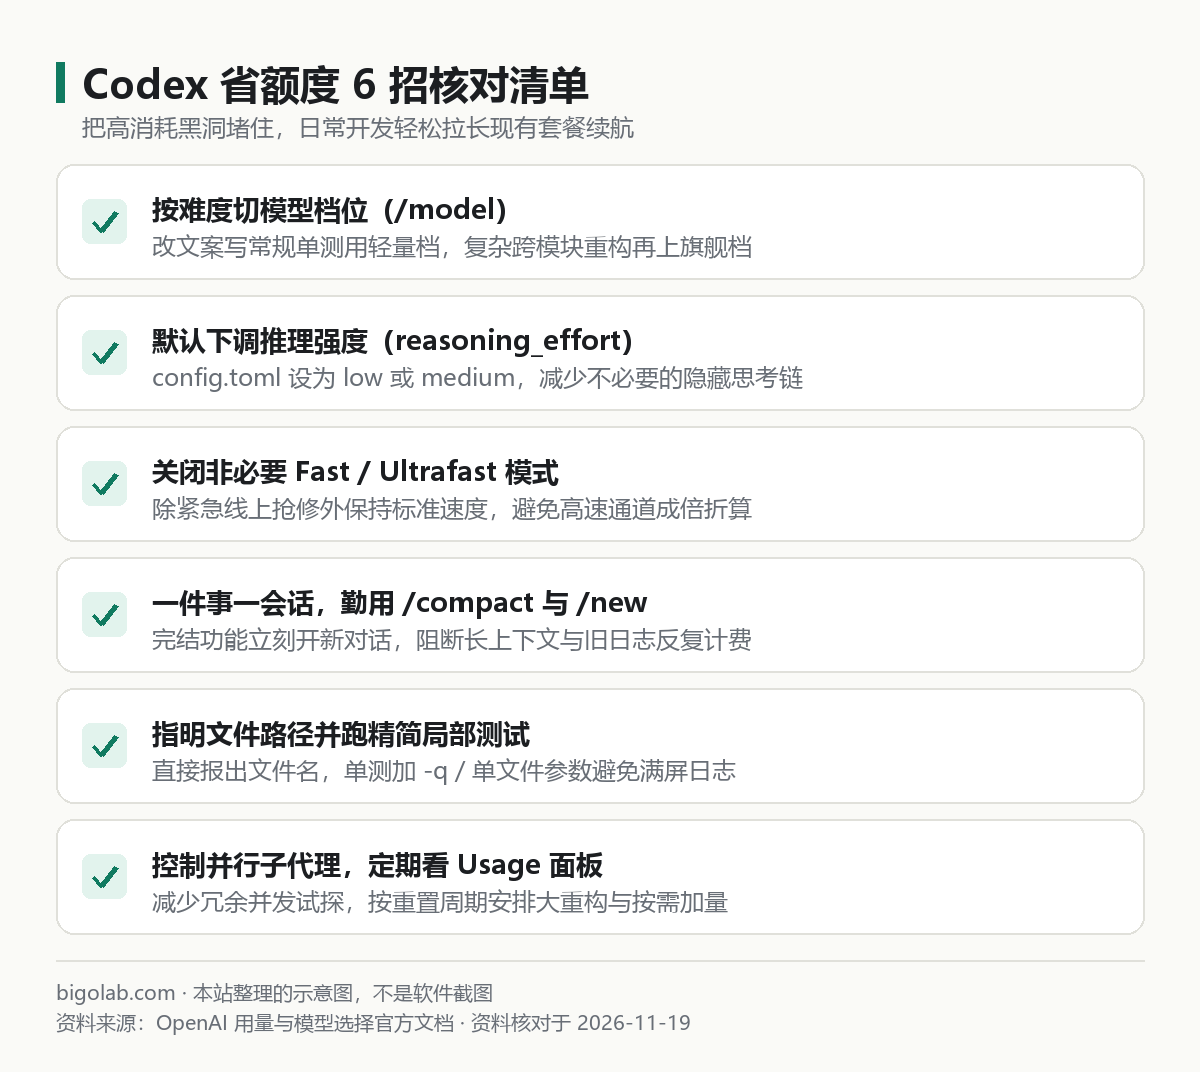
圖:本站根據 OpenAI 幫助中心:Using Codex with your ChatGPT plan 與用量文檔整理的示意圖
本文根據 OpenAI 幫助中心《Using Codex with your ChatGPT plan》《Paid weekly Work and Codex rate limit resets》《Managing usage in Work and Codex》及 Codex 官方模型與速度配置文檔整理,資料核對於 2026-11-19。配圖為本站整理的示意圖,不是介面截圖。本站(bigolab.com)不是 OpenAI 官方網站。
適用於誰
- 平時用 ChatGPT Plus 或 Pro 跑 Codex CLI / 桌面端,經常才開發兩三個小時就觸發 5 小時滾動限額或周限額的開發者;
- 不清楚為什麼問了沒幾句簡單問題、額度條就掉了一大截,想摸清隱藏消耗項的用戶;
- 希望在盡量不犧牲代碼質素的前提下,把現有訂閱額度拉長用足兩倍以上的人。
一、先看清為什麼同樣寫代碼,有人額度掉得快三倍
OpenAI 官方用量文檔指出,Codex 的週期額度由多維因素共同決定:輸入上下文體積、模型輸出與隱藏思考鏈長度、所選模型與速度檔位,以及是否開啟了多並發子代理。以下三種習慣是最常見的「隱形偷跑黑洞」:
- 黑洞 1:拿高強度推理幹雜活。開着
high或xhigh讓它改一個按鈕文案、重命名兩個變量,模型內部會生成數千個隱藏推理 Token 反覆驗證,實際輸出只有五行,扣掉的額度卻堪比一次中型重構。 - 黑洞 2:一條超長會話撐滿上下文。比如在會話第 2 輪讓它跑了一次全量構建,日誌吐了 3000 行;之後你在同一窗口繼續問 20 輪小問題,這 3000 行垃圾日誌和幾十輪歷史 Diff 會被反覆攜帶計費。關於超大上下文窗口的利弊可對照 /guides/codex-app-context-window-1m-setting。
- 黑洞 3:常開高速模式 + 同時起多個子代理。高速模式疊加多路並發子任務,短時間內會把 5 小時滑動窗口直接打穿,迅速觸發限流報錯(若已遇 429 限流可看 /guides/codex-exceeded-retry-limit-429-too-many-requests)。
二、把額度省出一倍以上的 6 招實操
結合官方模型、速度與配置選項,本站建議將以下 6 招落地成日常固定動作:
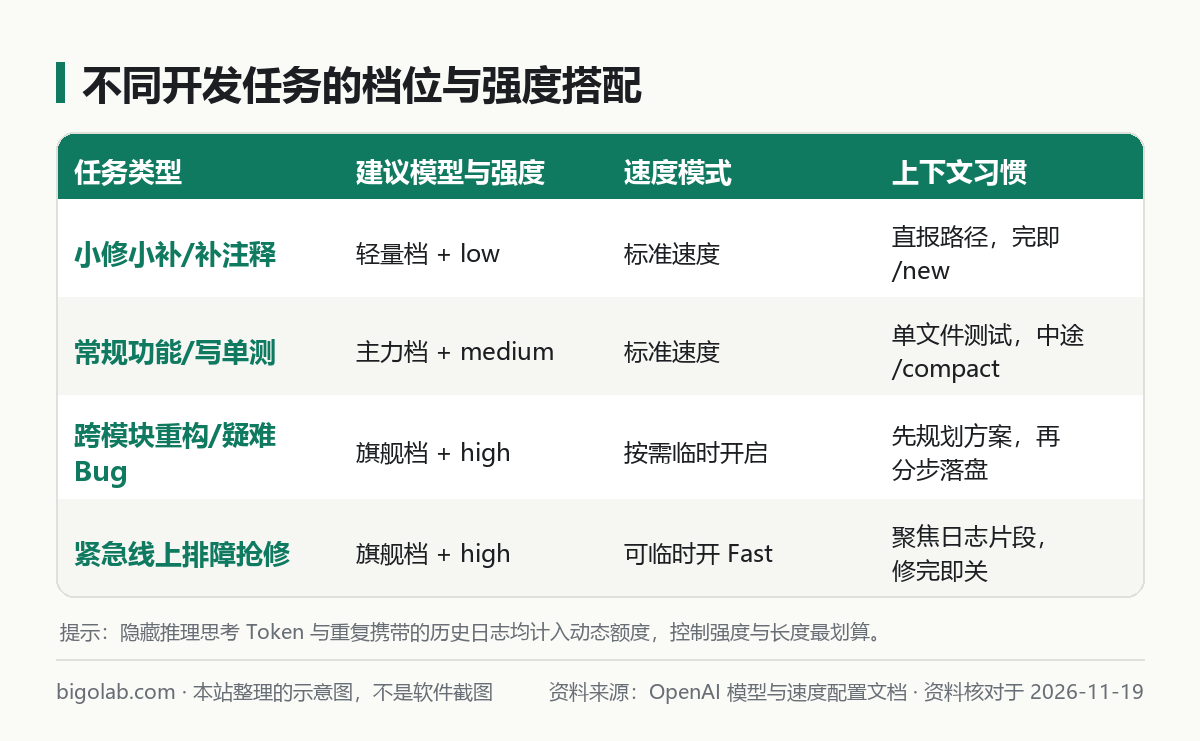
圖:本站根據 OpenAI 官方文檔:Model selection 與速度說明整理的搭配示意圖
第 1 招:按任務複雜度動態切模型檔位
在 CLI 中隨時輸入 /model(或在桌面端輸入框下方下拉切換),做到「簡單活交輕量檔、硬骨頭交旗艦檔」。也可以把日常主力檔位直接寫進 ~/.codex/config.toml 作為省流預設值,完整切換方式可看 /guides/codex-switch-model-reasoning-effort。
第 2 招:把預設推理強度降到 low 或 medium
在 ~/.codex/config.toml 中顯式設定預設推理強度,避免每次啟動都吃滿高推理檔位:
toml
# 日常編碼預設保持中等推理,兼顧準確度與配額消耗
model_reasoning_effort = "medium"
遇到確實棘手的並發死鎖、複雜 SQL 調優或全鏈路設計時,再在單次命令裏臨時拉高:
bash
codex -c model_reasoning_effort=high
第 3 招:關閉非必要 Fast / Ultrafast 加速模式
Fast / Ultrafast 模式的價值在於縮短交互等待延遲,但會加快配額消耗速率。在桌面端設定或 CLI 配置裏檢查當前速度模式,除緊急線上救火或演示場景外,日常開發保持標準速度(Standard),把省出來的 Token 預算留給真正需要深度思考的輪次。
第 4 招:善用 /compact 壓縮,換任務立刻 /new
不要捨不得清對話。當一個子功能已經完成、測試通過並提交 Git 後,直接敲 /new 開啟空白會話,讓上下文歸零;如果單個大任務做到一半上下文明顯變沉,先敲 /compact 把前面幾十輪探索日誌濃縮成精簡摘要再繼續。常用斜槓命令速查見 /guides/codex-cli-commands-cheatsheet。
第 5 招:精準投餵路徑與精簡命令輸出(本站建議)
- 提問直接報出目標文件路徑:寫「修改
src/services/order.ts中的calcDiscount函數」比寫「幫我找一下訂單折扣計算邏輯並改掉」能省下模型四五輪全倉grep和讀無關文件的消耗。 - 單測與報錯輸出加安靜參數:要求 Codex 優先跑單文件精簡模式(如
pytest tests/test_order.py -q --tb=short或pnpm vitest run src/order.test.ts),不要動輒跑全倉測試把幾千行通過日誌塞進上下文。
第 6 招:節制並行子代理,善用用量面板監控節奏
開啟多路並行子代理或雲端批量任務前,先確認是否真有必要同時試探多種方案;平時養成在 Settings → Usage 或 CLI /status 裏看一眼剩餘額度與重置時間的習慣,合理錯開高頻重度任務。關於週期重置機制與額度構成詳解,請對照 /guides/codex-usage-limits。
排障與訂閱提示:如果你的工作流本身就是全天高頻用 Codex 改大型項目、跑並發任務,單靠省流仍會感到 Plus 額度捉襟見肘。建議直接按需選擇 ChatGPT Pro 5x iOS 可覆蓋檔 或更高裕度的 ChatGPT Pro 20x iOS 可覆蓋檔;新帳號首次手機驗證受阻也可參考 Codex 註冊手機驗證服務。
三、真的觸達上限了怎麼辦:補充 Credits 與升級決策
當本週確實趕上版本發版、連省流 6 招都壓不住用量時,有兩個合規出口可選:
- 臨時偶發缺口:個人套餐用戶可了解官方靈活加量點數(Credits)機制,應對單週突擊峰值,詳見 /guides/chatgpt-credits-extra-usage-what-is-how-to-buy。
- 長期高頻剛需:如果幾乎每週都在撞限額紅線,長期零散加購反而划不來,直接切到高配額 Pro 套餐或團隊版更省心,無需每次幹活都盯着進度條算着省。
常見問題
問:我把推理強度從 high 降到 medium,代碼質素會明顯變差嗎?
答:對於需求清晰、接口明確、改動範圍在 1 到 5 個文件內的日常開發,medium 與 high 的一次通過率差距很小,但速度更快且額度消耗明顯更低。真正需要把 high / xhigh 拉滿的,是需求模糊的跨模組重構、疑難底層 Bug 排查和複雜並發設計。
問:是不是對話越短越省,那我把 AGENTS.md 寫得很長會不會每輪都扣很多額度?
答:會的。AGENTS.md 每次啟動會話都會作為基礎指令注入上下文;如果根目錄規則文件動輒貼入上萬字過時文檔,每輪都會白白吃掉大量輸入 Token。保持根目錄 AGENTS.md 精煉在幾百字核心命令與約定內,既省額度又能提高指令遵循度。
問:國內沒有外幣卡,或者 Plus 額度不夠想升級 Pro / 團隊版怎麼辦理?
答:可前往本站 AI 會員充值總覽 按需選購 ChatGPT Plus(含 Plus iOS 可覆蓋版)或高配額 ChatGPT Pro,團隊多人研發亦可選擇企業定製方案。支持支付寶、微信支付及 AlipayHK,提供免交密碼卡密自助兌換並支持開具增值稅發票,價格以商品頁實時展示為準;售後遵循掉訂閱按剩餘天數折退、封號不在質保範圍的說明。
相關教學
- Codex 額度上限與重置規則完全解讀
- Codex 怎麼切換模型與調節推理強度
- ChatGPT / Codex Credits 靈活加量額度是什麼及怎麼買
- Codex 報 exceeded retry limit / 429 限流怎麼辦
- Codex 桌面端 1M 超長上下文設定與使用注意
參考資料
- OpenAI 幫助中心:Using Codex with your ChatGPT plan — https://help.openai.com/en/articles/11369540-using-codex-with-your-chatgpt-plan
- OpenAI 幫助中心:Paid weekly Work and Codex rate limit resets — https://help.openai.com/en/articles/20001507-paid-weekly-work-and-codex-rate-limit-resets
- OpenAI 幫助中心:Managing usage with GPT-6 Astra in Work and Codex — https://help.openai.com/en/articles/20001516-managing-usage-with-gpt-6-astra-in-work-and-codex
- OpenAI ChatGPT Learn:Model selection — https://learn.chatgpt.com/docs/model-selection
- OpenAI ChatGPT Learn:Speed configuration — https://learn.chatgpt.com/docs/agent-configuration/speed
0 條評論
還沒有評論,來搶沙發~