
結論先說
- Plan Mode(規劃模式)的核心價值是「只讀勘察 + 輸出方案 + 人工拍板」。在交互終端裏輸入
/plan或按Shift + Tab即可切換,模型會先檢索倉庫並輸出結構化實施藍圖,不會在方向未確認前擅自改寫源碼。 - 若會話裏找不到
/plan,先檢查特性開關。在~/.codex/config.toml的[features]段確認開啟collaboration_modes = true並重啟 CLI,即可解鎖規劃協作模式。 model_verbosity管「說多細」,model_reasoning_effort管「想多深」。前者提供low、medium、high三檔控制回覆文字詳略,後者控制推理投入深度,兩者可獨立組合,不要混為一談。- 規劃階段調高詳略度與推理深度,執行階段切回精簡檔最省心。通過
config.toml的[profiles]或命令行-c臨時覆蓋,既能把架構風險講透,又能在批量改代碼時省去冗餘解釋。 - 開啟高推理強度疊加高詳略度方案評審會消耗更多上下文額度。國內無外幣銀行卡的用戶,可在本站自助開通 ChatGPT Plus 或高配額的 ChatGPT Pro,團隊協作可了解 ChatGPT Business 團隊定製。
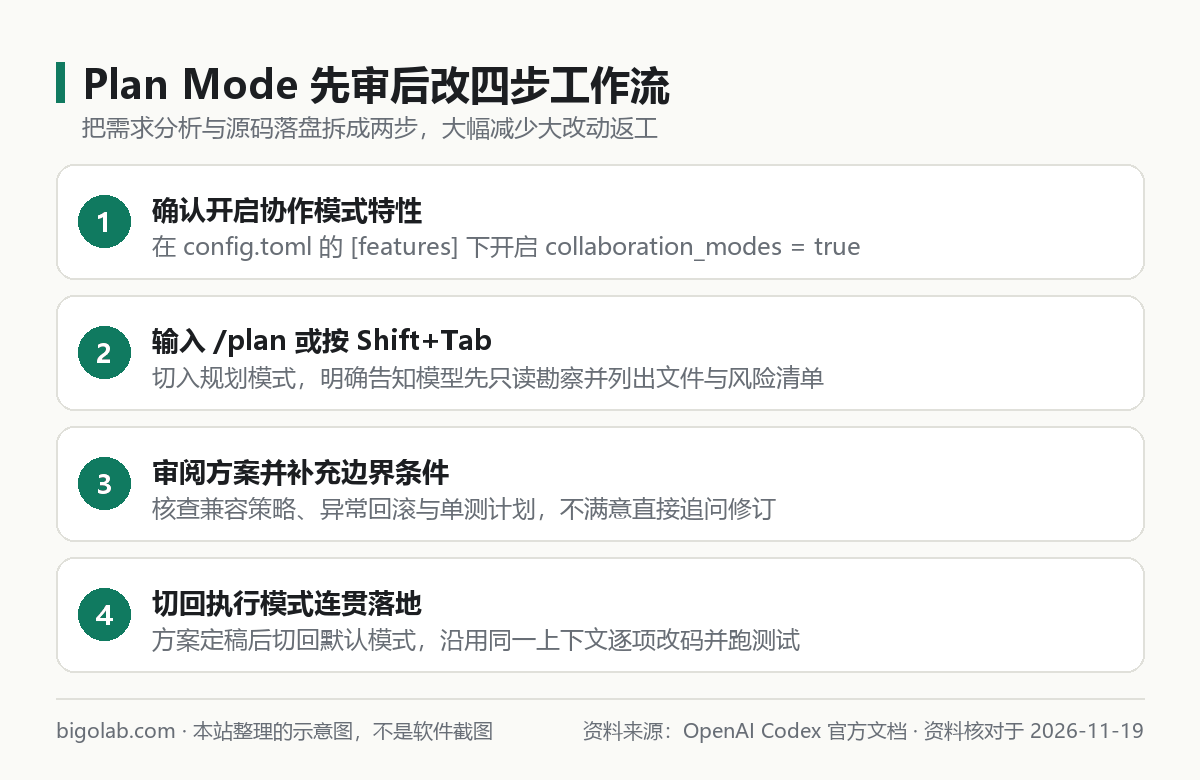
圖:本站根據 OpenAI Codex 官方文檔:Slash commands 整理的示意圖
本文根據 OpenAI Codex 官方文檔《Config reference》《Model selection》《Slash commands》整理,資料核對於 2026-11-19。配圖為本站整理的示意圖,不是介面截圖。本站(bigolab.com)不是 OpenAI 官方網站。
適用於誰
- 遇到跨模組重構、數據庫遷移或接口升級時,希望 Codex 先給出完整改動清單經人工審定後再動代碼的開發者;
- 覺得模型平時回覆解釋太長、刷屏佔視野,或者寫方案時又太簡略看不清風險邊界的 Codex CLI 用戶;
- 希望把「深度設計階段」與「快速執行階段」做成可一鍵切換的配置檔以兼顧質素與額度的工程師。
一、開啟並使用 Plan Mode:先審方案再動手改代碼
直接讓代理「把支付回調重構一下」,模型往往立刻開始修改七八個文件,等改到一半才發現它理解錯了狀態機流轉,返工成本極高。換成 Plan Mode 後,開發節奏會變成可控的四步閉環:
1. 確認特性開關(如預設未啟用)
打開 ~/.codex/config.toml(配置結構說明見 /guides/codex-config-toml-complete-guide),確認包含以下段落:
toml
[features]
collaboration_modes = true
2. 在交互會話中進入規劃模式
啟動 codex 後,在輸入框直接鍵入 /plan,或按下 Shift + Tab 切換到 Plan Mode(更多快捷鍵與斜槓命令見 /guides/codex-cli-commands-cheatsheet)。
輸入需求時,建議順手明確希望方案裏包含的檢查維度,例如:
text
請先梳理訂單狀態從待支付到已退款的現有調用鏈,給出涉及修改的文件列表、數據兼容風險與單測補充計劃,先不要修改文件。
3. 審核、追問並切換回執行模式
Codex 會先只讀瀏覽倉庫,在專門的規劃視圖中列出分步方案;若發現某一步遺漏了灰度兼容或冪等校驗,直接繼續在規劃模式下追問修正。確認方案無誤後,再切回預設執行模式讓它按核定好的清單逐項落盤並跑通測試。
二、model_verbosity 回覆詳略度設定與三檔選型
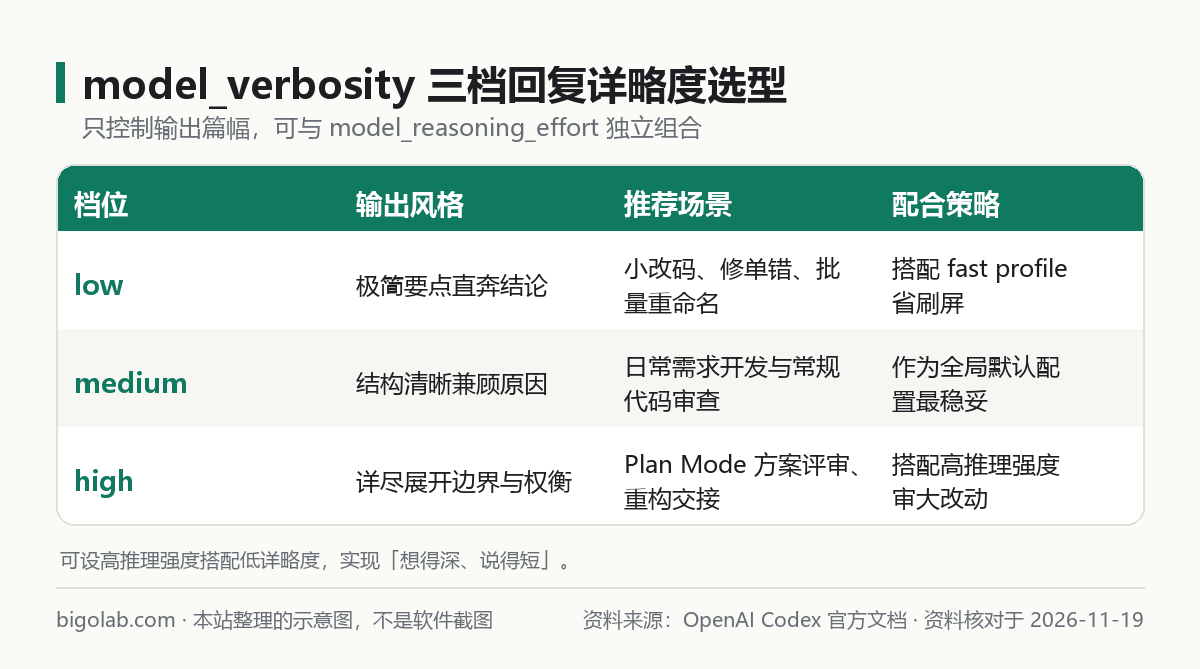
圖:本站根據 OpenAI Codex 官方文檔:Config reference 整理的示意圖
在支持的 GPT 系列模型中,model_verbosity 專門決定模型回覆的展開程度。把它和 model_reasoning_effort(切換方式見 /guides/codex-switch-model-reasoning-effort)區分開來,配置會清晰很多:
| 配置檔位 | 回覆文字風格 | 典型適用場景 | 額度與閱讀成本 |
|---|---|---|---|
low | 極簡要點,只給結論與變更摘要 | 批量機械修改、修小報錯、終端窄屏速覽 | 輸出最短,響應快且省額度 |
medium | 平衡清晰,附帶關鍵原因與核對項 | 日常功能開發、常規代碼審查與單測編寫 | 預設均衡選擇,適合多數任務 |
high | 詳盡展開,寫清權衡、邊界與影響面 | 架構評審、Plan Mode 方案定稿、交接文檔 | 輸出篇幅長,建議按需開啟 |
1. 全局配置與單次臨時覆蓋
在 ~/.codex/config.toml 頂層可直接設定日常預設檔位:
toml
model_verbosity = "medium"
model_reasoning_effort = "medium"
如果平時保持精簡,只在本次做重要架構評審時想讓模型寫得更細緻,啟動時用 -c 臨時提升即可:
bash
codex -c model_verbosity="high" -c model_reasoning_effort="high"
在運行中的交互會話裏,切入 Plan Mode 後也可以通過 /model 單獨調整規劃階段的推理投入,避免和日常執行階段互相牽制。
訂閱與帳號準備提示:在 Plan Mode 裏用高推理深度配合model_verbosity = "high"連續推演大型倉庫,單輪消耗會明顯高於普通改碼(配額規則見 /guides/codex-usage-limits)。若 Plus 檔在方案設計密集期容易限速,可在本站升級 ChatGPT Pro 充值 或選用 ChatGPT Pro 5x iOS 可覆蓋檔;新註冊帳號若遇到手機短訊驗證受阻,可查看 Codex 註冊手機驗證服務。
三、本站建議:用雙 Profile 分離「審方案」與「快執行」
如果每天既要做複雜技術方案又要改大量常規前端或腳本代碼,反覆手動敲 -c 參數很繁瑣。本站建議在 ~/.codex/config.toml 裏建兩組配置檔,按場景一鍵切換:
toml
# 預設走均衡配置
model_verbosity = "medium"
model_reasoning_effort = "medium"

[profiles.plan]
model_verbosity = "high"
model_reasoning_effort = "high"

[profiles.fast]
model_verbosity = "low"
model_reasoning_effort = "low"- 做跨模組設計、排疑難並發 Bug 時,運行
codex --profile plan,進入後按Shift + Tab進 Plan Mode,把邊界條件與回滾方案全部審透; - 方案敲定後做常規樣式微調、補註釋或簡單重命名時,運行
codex --profile fast,回覆直奔結果不刷屏,也能把額度留給真正難的決策環節。
常見問題
問:把 model_verbosity 調成 low,會讓 Codex 寫出來的代碼質素變差嗎?
答:不會直接等同於降低思考深度。model_verbosity 主要壓縮模型對外解釋和敘述的篇幅,真正決定深層推理投入的是 model_reasoning_effort。你完全可以配置 model_reasoning_effort = "high" 搭配 model_verbosity = "low",讓它想得深但說得短。
問:在 Plan Mode 裏審完方案後,需要把整段方案複製出來重開會話嗎?
答:不需要。在同一會話內從 Plan Mode 切回執行模式後,剛剛審核定稿的計劃仍在當前上下文中,直接回復「按上述方案開始實施」即可連貫落地,避免上下文斷層。
問:國內沒有外幣信用卡,或者研發團隊需要開增值稅發票報銷,怎麼開通能穩定跑高推理檔與 Plan Mode 的訂閱?
答:可通過本站 AI 會員充值總覽 辦理 ChatGPT Plus 卡密自助兌換 或高配額 ChatGPT Pro,多人研發團隊可直接選擇 ChatGPT Business 團隊定製。支持支付寶、微信支付與 AlipayHK 付款,無需提供帳號密碼,可開具增值稅發票;實時價格以商品頁為準,售後遵循掉訂閱按剩餘天數折退、封號不在質保範圍的規則。
相關教學
參考資料
- OpenAI Codex 官方文檔:Config reference — https://learn.chatgpt.com/docs/config-file/config-reference
- OpenAI Codex 官方文檔:Model selection — https://learn.chatgpt.com/docs/model-selection
- OpenAI Codex 官方文檔:Slash commands — https://learn.chatgpt.com/docs/cli/slash-commands
0 條評論
還沒有評論,來搶沙發~