
照着 Browser Use 入門安裝與首個瀏覽器智能體教學 跑通演示腳本後,很多研發團隊想拿它自動巡檢自家測試環境後台、批量導出 SaaS 報表或驗證前端下單鏈路。
但從玩具 Demo 邁向真實生產腳本,橫在面前的有三道硬門檻:第一,絕對不能把測試帳號的真實密碼明文塞進 task 字符串發給雲端大模型;第二,抓完網頁數據怎麼無縫回調你本地的 Python 入庫函數或拿回乾淨的 JSON 對象;第三,萬一網頁彈窗遮擋,怎麼防止智能體原地死磕三十步把 Token 燒光。下面用一套完整的加固代碼逐個擊破。
AI 全棧開發訂閱配套入口:在本地部署與聯調開源 AI 框架時,搭配固定月費的終端編程智能體與旗艦推理訂閱能大幅縮短排錯時間。國內無境外信用卡可在本站通過支付寶、微信支付或 AlipayHK 免密自助開通 Claude Code 訂閱、ChatGPT Plus / Pro 或查看 AI 會員充值總覽。
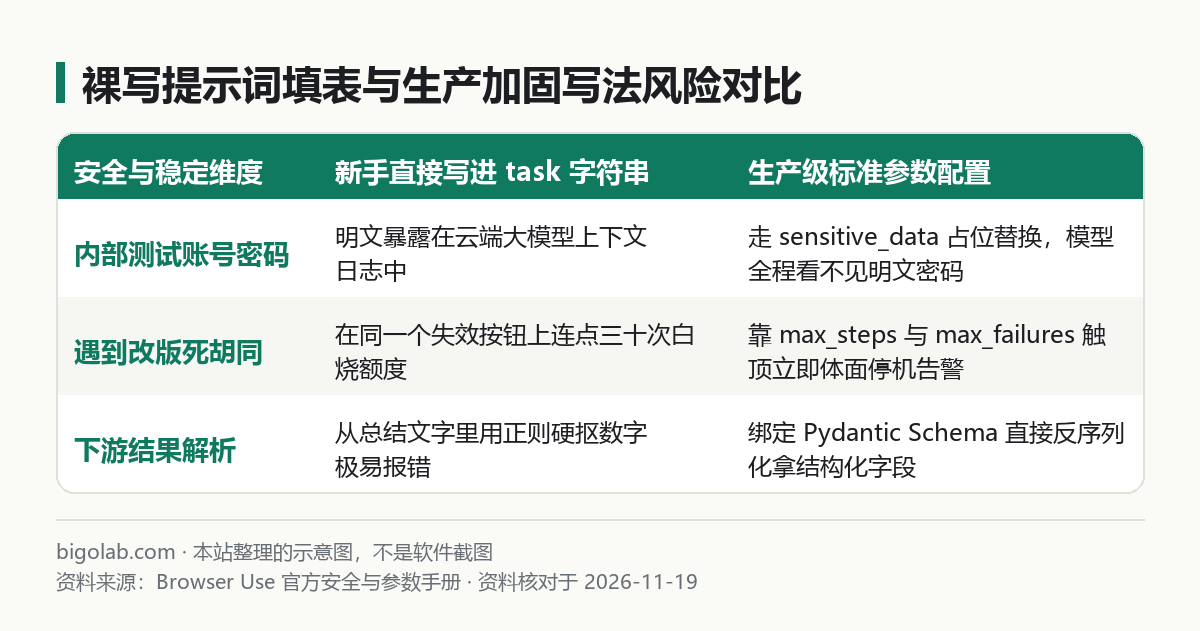
一、sensitive_data:讓雲端大模型全程看不見真實密碼
新手最容易犯的安全事故,就是直接寫 task="打開後台輸入賬號 admin、密碼 P@ssw0rd123 登入"——這樣你的明文密碼會隨着每一輪提示詞被完整發往外部模型接口。
Browser Use 原生提供了 sensitive_data(敏感數據本地映射字典):你只需在提示詞裏寫佔位變量名(如 x_user、x_pass),雲端模型推理時只看到佔位符並輸出“往密碼框填入 <secret>x_pass</secret>”,直到最後一步由你本機運行的代碼在本地內存裏替換成真實密碼敲進輸入框,配合 use_vision=False(登入頁填表階段可關掉截圖上載防密碼框回顯外泄)安全度拉滿。
二、完整加固代碼:脫敏填表 + @tools.action 自定義動作 + 強類型輸出
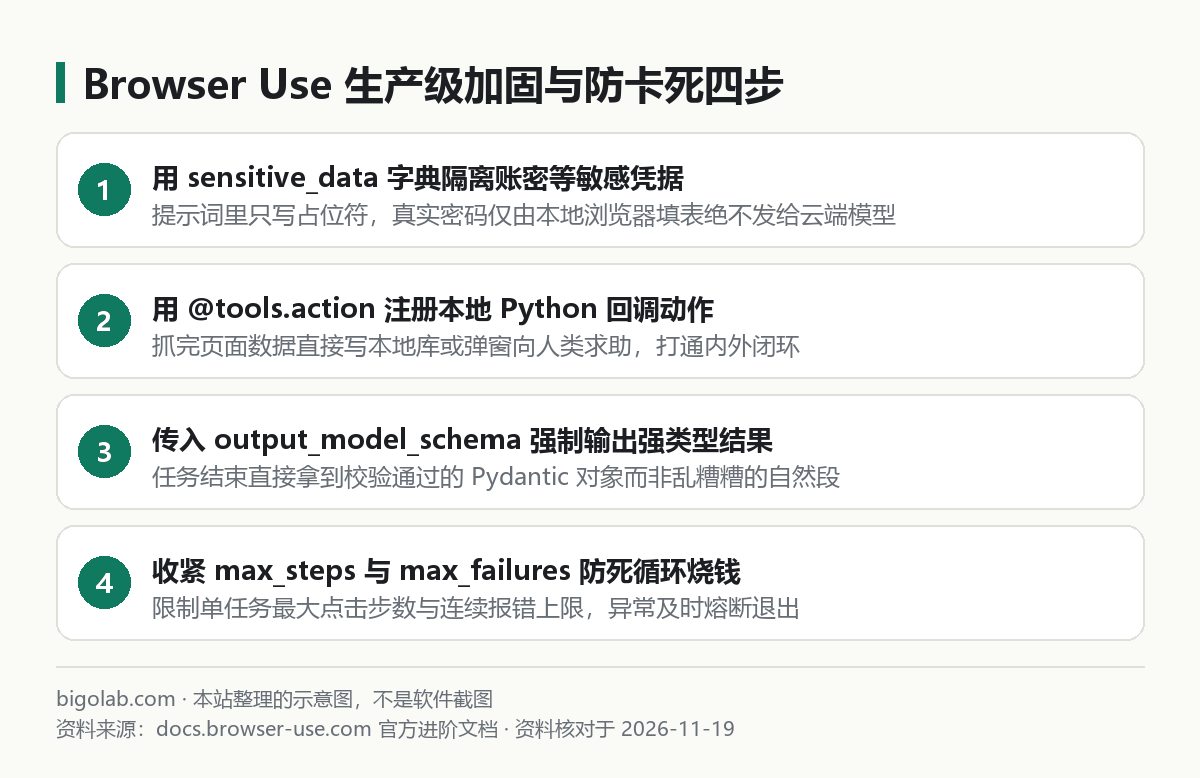
下面這份完整 Python 腳本把敏感憑據隔離、自定義本地動作(Tools)、Pydantic 結構化返回值以及步數與連續失敗熔斷全部組裝在了一起:
python
import asyncio
import os
from pydantic import BaseModel
from browser_use import Agent, Browser, ChatAnthropic, Tools, ActionResult

# 1. 定義任務結束時必須返回的強類型結構(原理同 Pydantic AI 結構化校驗)
class DashboardMetrics(BaseModel):
    active_users: int
    pending_tickets: int
    system_healthy: bool

# 2. 註冊自定義本地 Python 動作:讓瀏覽器智能體隨時回調你的內部邏輯
tools = Tools(output_model=DashboardMetrics)

@tools.action("當頁面出現異常紅色告警橫幅時,發送內部通知給值班工程師")
async def notify_oncall(alert_text: str) -> ActionResult:
    print(f"[本地告警回調已觸發] 捕獲頁面異常:{alert_text}")
    return ActionResult(extracted_content="已成功記錄告警並通知值班人員")

async def run_inspection():
    # 3. 準備敏感憑據字典:從本地環境變量讀取,絕不明文拼入提示詞
    secrets = {
        "https://admin.staging.example.com": {
            "stg_user": os.environ["STAGING_ADMIN_USER"],
            "stg_pass": os.environ["STAGING_ADMIN_PASS"],
        }
    }

    browser = Browser(headless=True)
    llm = ChatAnthropic(model="claude-sonnet-4-5", temperature=0.0)

    agent = Agent(
        task=(
            "訪問 https://admin.staging.example.com ,使用帳號 stg_user 和密碼 stg_pass 登入測試後台。"
            "進入概覽看板提取今日活躍用戶數與待處理工單數;若頂部有紅色告警條請先調用通知工具,最後按指定結構輸出結果。"
        ),
        llm=llm,
        browser=browser,
        tools=tools,
        sensitive_data=secrets, # 按域名嚴格綁定的敏感佔位字典
        max_failures=3,         # 連續 3 次動作報錯立即熔斷止損,不死磕
        max_actions_per_step=4, # 允許同一輪把“輸帳號+輸密碼+點登入”打包批量執行省費用
    )

    # 4. 硬卡全局最大步數上限 max_steps=15,嚴防意外跳轉陷入死循環
    history = await agent.run(max_steps=15)
    raw_json = history.final_result()
    if raw_json:
        metrics = DashboardMetrics.model_validate_json(raw_json)
        print("巡檢結構化結果:", metrics)

if __name__ == "__main__":
asyncio.run(run_inspection())研發團隊訂閱與高配額省心方案:調試複雜多步智能體循環、RAG 切片策略與 CI 評測流水線非常消耗單日 Token。個人主力開發推薦免上號兌換 Claude Pro iOS 自助卡密 或 5 倍額度的 Claude Max 5x,多人研發團隊協同亦可聯絡客服定製 ChatGPT Business 團隊版。
三、省一半 Token 與防卡死的四個關鍵參數細節
由於瀏覽器智能體每走一步都要讀取精簡 DOM 樹(開啟視覺時還要附帶網頁截圖),單次任務的上下文開銷遠高於純文本問答。調優下面四個細節能讓穩定性和帳單同時改善:
- 務必給
sensitive_data套上域名限定鍵名:注意上面代碼裏字典外層包了"https://admin.staging.example.com": { ... }。這樣就算網頁上藏着惡意第三方跳轉連結把瀏覽器拐到了外部釣魚域名,Browser Use 檢測到當前 URL 域名不匹配,會當場拒絕填入真實密碼。 - 善用
max_actions_per_step合併連貫小動作:面對包含五六個輸入框的常規表單,允許模型在單次推理裏一口氣規劃好“填姓名 -> 填電郵 -> 勾選協議 -> 點提交”四步動作連續跑完,比每填一個框就重新截一次圖調一次大模型快三倍、省一大半開銷。 - 分清何時用本地獨立配置目錄(
user_data_dir)複用登入態:對於已經手動登入好的複雜後台,不要直接掛載你平時辦公正在開着的系統主 Chrome 目錄(兩個進程同時讀寫同一個 Profile 極易引發文件鎖衝突報錯);更穩妥的做法是單獨指定一個專用目錄如user_data_dir="./bot_chrome_profile",首次以有頭模式(headless=False)手動登好儲存 Cookie,後續定時巡檢再切無頭模式靜默複用。 - 純靜態內容採集別殺雞用牛刀:如果目標網頁根本不需要多步點按鈕填表,只是想把幾十篇公開網頁轉成乾淨文本入庫,改用 Crawl4AI 異步並發抓取框架 會省掉百分之九十以上的模型調用費;而複雜的純後端數據校驗編排則可搭配 Pydantic AI 框架 協同處理。
日常編寫自動化端到端巡檢腳本與調試前端選擇器邏輯時,配合官方固定額度的編程訂閱工具效率極高。需要開通海外直連開發訂閱的同學,可前往查看貝果研究社 Claude Code 訂閱與配置方案或 ChatGPT Plus 自助充值專頁。
常見問題
巡檢過程中如果意外撞上人機驗證碼(CAPTCHA)或者二次短訊確認,應該怎麼優雅處理?
切記:嚴禁嘗試用任何自動化腳本或視覺模型去破解、繞過人機驗證碼門禁。針對自家測試環境,正道是在測試服後台給自動化巡檢帳號或內網 IP 配置免驗證碼白名單;針對個人本地輔助填表場景,可以寫一個 @tools.action("遇到人工驗證或支付確認時暫停等待人類接管") 函數,在終端發出提示音並 input("請人工在瀏覽器窗口完成核驗後按回車繼續..."),人手點完再交還給智能體收尾。
怎麼回放排查昨天半夜無頭模式(headless=True)跑掛的那一步到底點偏到了哪兒?
在初始化 Agent 時傳入 save_conversation_path="./logs/run_trace" 或開啟內置的 GIF 錄屏參數(generate_gif=True)。跑完後目錄下會自動生成一張按步驟標清高亮點擊框的完整操作動圖,一眼就能看清是彈窗沒關掉還是測試服接口超時白屏。
搭好開源框架後,國內沒有外幣信用卡怎麼開通主力編程與大模型訂閱?
可在 本站 AI 會員充值中心 使用支付寶、微信支付或 AlipayHK 自助選購卡密,支持免交密碼兌換 Claude Code(Pro / Max)、ChatGPT Plus 與 ChatGPT Pro,並支持開具增值稅發票;實時價格與售後邊界(封號不在質保範圍)以對應商品頁說明為準。
小結
- 涉及登入帳號密碼等敏感字段一律走按域名鎖定的
sensitive_data字典,絕不把明文憑據塞進task提示詞。 - 用
Tools(output_model=...)與@tools.action打通本地 Python 告警入庫函數並拿回經過 Pydantic 校驗的強類型結果。 - 生產運行必須同時卡死
agent.run(max_steps=...)與max_failures=3,複用登入態時優先創建獨立的專用user_data_dir配置文件夾避免鎖衝突。
0 條評論
還沒有評論,來搶沙發~