
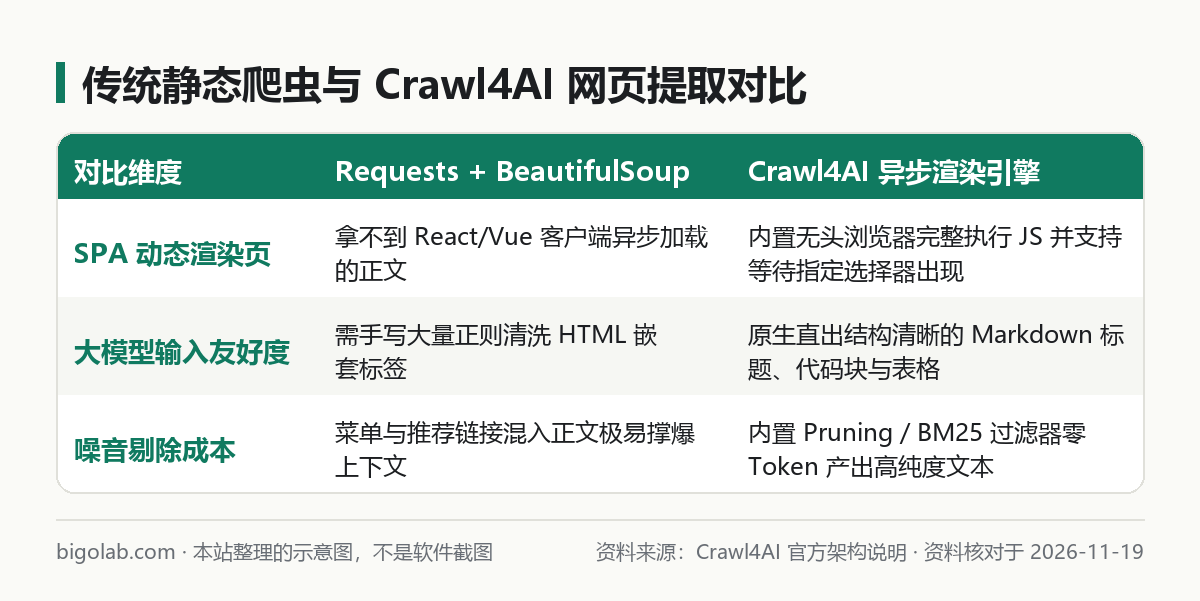
給私有知識庫(例如 RAGFlow 或 Dify 知識庫)採集外部技術文檔、競品幫助中心或行業資訊時,傳統 requests + BeautifulSoup 老組合越來越力不從心:一方面現代單頁應用(SPA)全是客戶端 JavaScript 異步渲染,靜態請求抓回來只有空殼;另一方面就算拿 Playwright 取到了完整 HTML,裏面八成字數都是頂部巨大下拉選單、側邊推薦連結和頁腳版權聲明,原樣餵給大模型白白燒掉一大半上下文額度。
專門面向大模型與智能體數據管道設計的開源 Python 框架 Crawl4AI,把“無頭瀏覽器並發渲染 + 智能噪音剪枝 + 原生結構化 Markdown 生成”打包成極簡的幾行異步代碼。下面帶你從零跑通最核心的清洗流水線。
AI 全棧開發訂閱配套入口:在本地部署與聯調開源 AI 框架時,搭配固定月費的終端編程智能體與旗艦推理訂閱能大幅縮短排錯時間。國內無境外信用卡可在本站通過支付寶、微信支付或 AlipayHK 免密自助開通 Claude Code 訂閱、ChatGPT Plus / Pro 或查看 AI 會員充值總覽。
一、兩行命令安裝與初始化瀏覽器內核
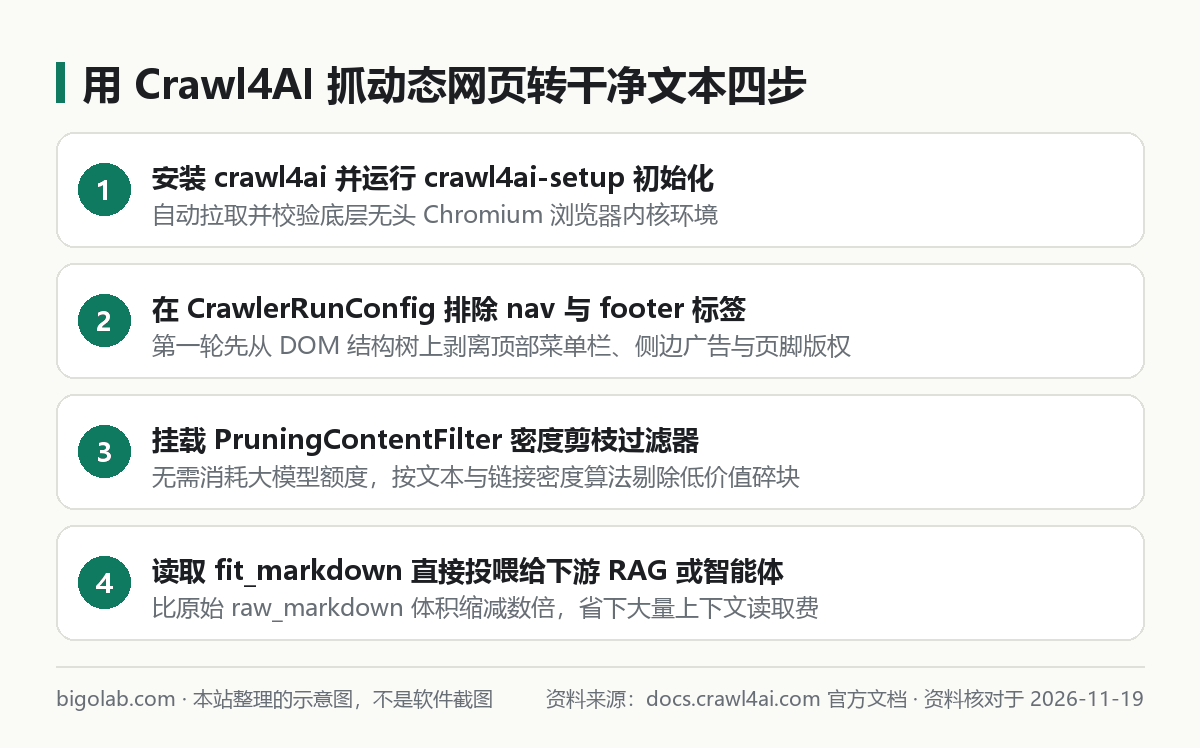
在 Python 3.10 及以上虛擬環境中安裝主包,並執行內置初始化嚮導自動拉取無頭 Chromium 瀏覽器依賴:
bash
pip install -U crawl4ai
crawl4ai-setup
如果在無圖形介面的 Ubuntu 雲伺服器上部署,跑完 crawl4ai-setup 後還可以順手執行一句 crawl4ai-doctor,它會自動做一次自檢,確認系統底層字體庫與沙箱依賴全部齊備。
二、核心實戰代碼:用 PruningContentFilter 榨出純淨 fit_markdown
很多新手第一次跑 Crawl4AI 只打印了預設的原始 Markdown,發現頂部選單連結還是被轉成了幾十行列表。真正的省錢精髓在於配置 PruningContentFilter(密度剪枝過濾器) 並讀取 fit_markdown——它完全不消耗半點大模型 API 額度,純靠本地算法計算 DOM 節點的文本密度與超連結佔比,精準砍掉“字少連結多”的導航欄噪音塊。
儲存下面這段完整異步腳本為 clean_crawl.py 直接運行:
python
import asyncio
from crawl4ai import AsyncWebCrawler, BrowserConfig, CrawlerRunConfig, CacheMode
from crawl4ai.content_filter_strategy import PruningContentFilter
from crawl4ai.markdown_generation_strategy import DefaultMarkdownGenerator

async def fetch_clean_doc(target_url: str):
    # 1. 配置無頭瀏覽器參數(調試時可將 headless 設為 False 觀察渲染過程)
    browser_cfg = BrowserConfig(headless=True, verbose=False)

    # 2. 定義無 LLM 開銷的動態密度剪枝過濾器
    prune_filter = PruningContentFilter(
        threshold=0.45,           # 剪枝閾值:越高越嚴格,常規技術文檔 0.4~0.5 最均衡
        threshold_type="dynamic", # 根據頁面標籤類型與連結佔比動態打分
        min_word_threshold=5      # 自動丟棄不足 5 個詞的零碎按鈕提示文本
    )

    # 3. 組裝單次抓取運行配置:先剔除語義噪音標籤,再執行 Markdown 清洗生成
    run_cfg = CrawlerRunConfig(
        cache_mode=CacheMode.BYPASS,
        excluded_tags=["nav", "footer", "aside", "header"],
        markdown_generator=DefaultMarkdownGenerator(content_filter=prune_filter),
        wait_until="networkidle"  # 等待前端異步接口數據加載穩定後再提取
    )

    async with AsyncWebCrawler(config=browser_cfg) as crawler:
        result = await crawler.arun(url=target_url, config=run_cfg)
        if not result.success:
            raise RuntimeError(f"抓取失敗:{result.error_message}")

        md_obj = result.markdown_v2 if getattr(result, "markdown_v2", None) else result.markdown
        print(f"原始文本長度:{len(md_obj.raw_markdown)} -> 剪枝後純淨長度:{len(md_obj.fit_markdown)}")
        return md_obj.fit_markdown

if __name__ == "__main__":
    clean_text = asyncio.run(fetch_clean_doc("https://docs.python.org/3/whatsnew/3.13.html"))
    print(clean_text[:800])
跑完對比長度你會直觀看到:一份原本長達四萬字符的帶導航技術文檔,經過 excluded_tags 標籤剔除加 PruningContentFilter 剪枝後,濃縮出的 fit_markdown 往往只剩下一萬多字符的純乾貨正文、完整代碼塊與標準 Markdown 表格,直接切片入庫或餵給大模型總結省錢又精準。
研發團隊訂閱與高配額省心方案:調試複雜多步智能體循環、RAG 切片策略與 CI 評測流水線非常消耗單日 Token。個人主力開發推薦免上號兌換 Claude Pro iOS 自助卡密 或 5 倍額度的 Claude Max 5x,多人研發團隊協同亦可聯絡客服定製 ChatGPT Business 團隊版。
三、進階實戰技巧:帶查詢詞的 BM25 過濾與結構化抽取
除了通用的密度剪枝,面對長篇鉅製網頁或電商列表頁,還有兩個極其好用的內建武器:
- 只保留與特定問題相關的段落(
BM25ContentFilter):如果你只需要從一篇五萬字的年度財報網頁裏撈出“研發費用投入”相關段落,把過濾器換成BM25ContentFilter(user_query="研發費用 算力基礎設施"),它會在本地算完相關性得分,只把命中主題的高分段落拼進fit_markdown。 - 零大模型開銷按 CSS 選擇器直接抽 JSON(
JsonCssExtractionStrategy):對於結構高度規整的新聞列表、商品卡片或開源倉庫榜單,無需每頁都調昂貴大模型硬抽字段,只需寫好一份包含標題、價格、詳情連結 CSS 選擇器的規則字典傳給extraction_strategy,一次抓取就能直接拿到乾乾淨淨的 JSON 數組。 - 跟視覺瀏覽器智能體劃清分工邊界:如果你的任務是“批量把幾百個公開幫助文檔洗成乾淨 Markdown”,用 Crawl4AI 異步並發
arun_many()速度快一個數量級;但如果你需要讓 AI 自己看着螢幕填寫複雜多步表單、點彈窗交互,則更適合交給 Browser Use 瀏覽器操作智能體 來驅動。
日常編寫數據清洗管道與調試複雜選擇器規則時,搭配趁手的終端編程智能體能省掉大量手試 DOM 結構的時間。需要開通海外官方開發訂閱的工程師,可前往查看貝果研究社 Claude Code 訂閱與配置方案或全站 AI 開發者訂閱自助導航。
常見問題
抓取單頁應用時,正文明明在瀏覽器裏看得到,抓回來為什麼還是空白?
部分重前端框架在 networkidle 之後還會花幾百毫秒做本地組件掛載渲染。遇到這種情況,不要盲目加死睡眠等待,直接在 CrawlerRunConfig 裏傳入 wait_for="css:article.main-content"(填正文容器的真實 CSS 選擇器),讓爬蟲精準等到目標正文元素真正渲染上屏的那一刻再動手提取。
批量並發抓幾百個網頁時需要注意什麼合規底線?
務必嚴格遵守目標站點的 robots.txt 協議與服務條款,不要用來繞過付費牆、登入鑑權或反爬驗證碼門禁;在調用批量異步接口 arun_many 時,配合內置的速率限制與並發信號量控制單域名請求間隔,避免給對方文檔伺服器造成異常流量壓力。
搭好開源框架後,國內沒有外幣信用卡怎麼開通主力編程與大模型訂閱?
可在 本站 AI 會員充值中心 使用支付寶、微信支付或 AlipayHK 自助選購卡密,支持免交密碼兌換 Claude Code(Pro / Max)、ChatGPT Plus 與 ChatGPT Pro,並支持開具增值稅發票;實時價格與售後邊界(封號不在質保範圍)以對應商品頁說明為準。
小結
- 安裝
crawl4ai後運行crawl4ai-setup一鍵配齊無頭瀏覽器內核,輕鬆搞定動態 JS 渲染頁面。 - 組合使用
excluded_tags與PruningContentFilter,零大模型 API 成本輸出高信噪比的fit_markdown。 - 動態慢加載頁面用
wait_for="css:選擇器"精準守候渲染完成,規整列表頁優先用JsonCssExtractionStrategy直接提取結構化 JSON。
0 條評論
還沒有評論,來搶沙發~