
在讀完 Pydantic AI 快速入門與基礎 output_type 用法 之後,把智能體真正接進企業 FastAPI 後端立刻會碰到三個實戰深水區問題:
- 工具函數里要查 PostgreSQL 連接池和當前登入用戶的
tenant_id,難道要靠醜陋且線程不安全的全局變量往裏塞嗎? - 模型雖然輸出了合法的 JSON 字符串
{"order_id": "ORD-9999"},但去庫裏一查根本沒這個單號,怎麼把報錯原因精準踢回給大模型讓它自己重查,而不是直接拋 500 崩給前端? - 主力雲端模型突遇高峰期
429限流時,怎麼零改動業務代碼平滑切到備用廠商?
把 RunContext[Deps]、ModelRetry 與 ModelFallback 三劍客組合起來,就能寫出類型檢查器百分百放心的生產級 Python 智能體。
AI 全棧開發訂閱配套入口:在本地部署與聯調開源 AI 框架時,搭配固定月費的終端編程智能體與旗艦推理訂閱能大幅縮短排錯時間。國內無境外信用卡可在本站通過支付寶、微信支付或 AlipayHK 免密自助開通 Claude Code 訂閱、ChatGPT Plus / Pro 或查看 AI 會員充值總覽。
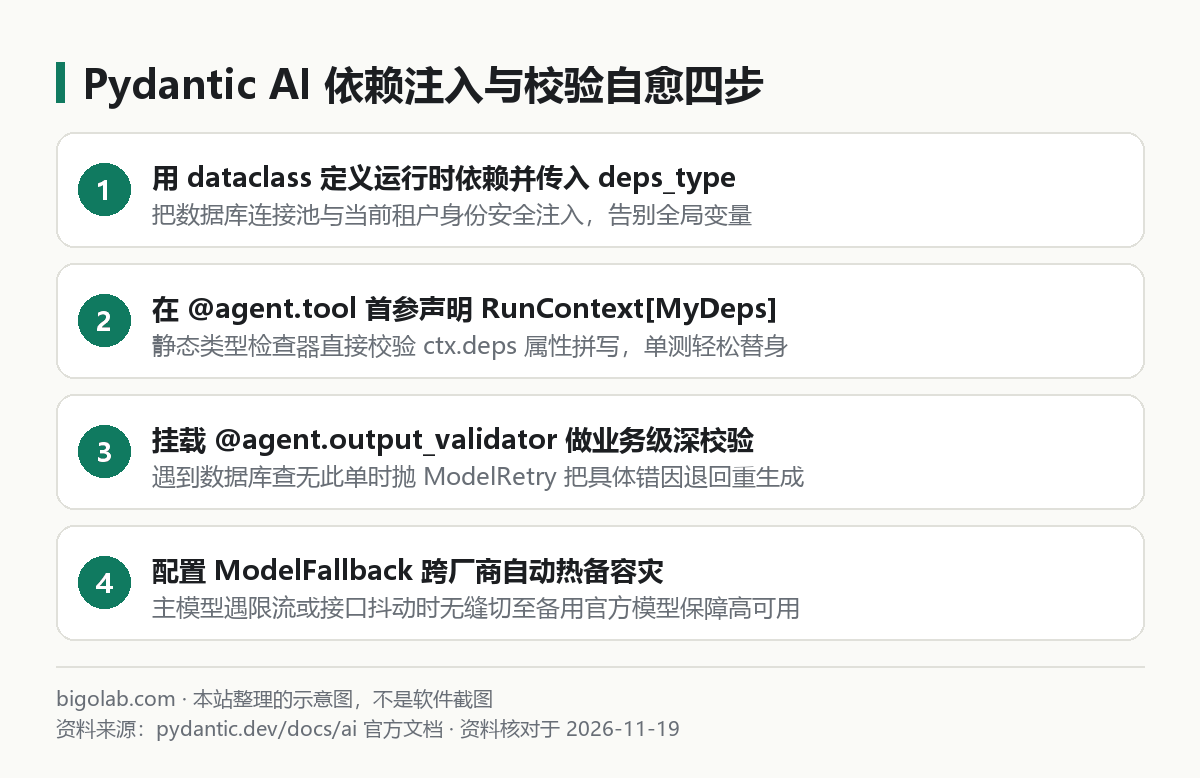
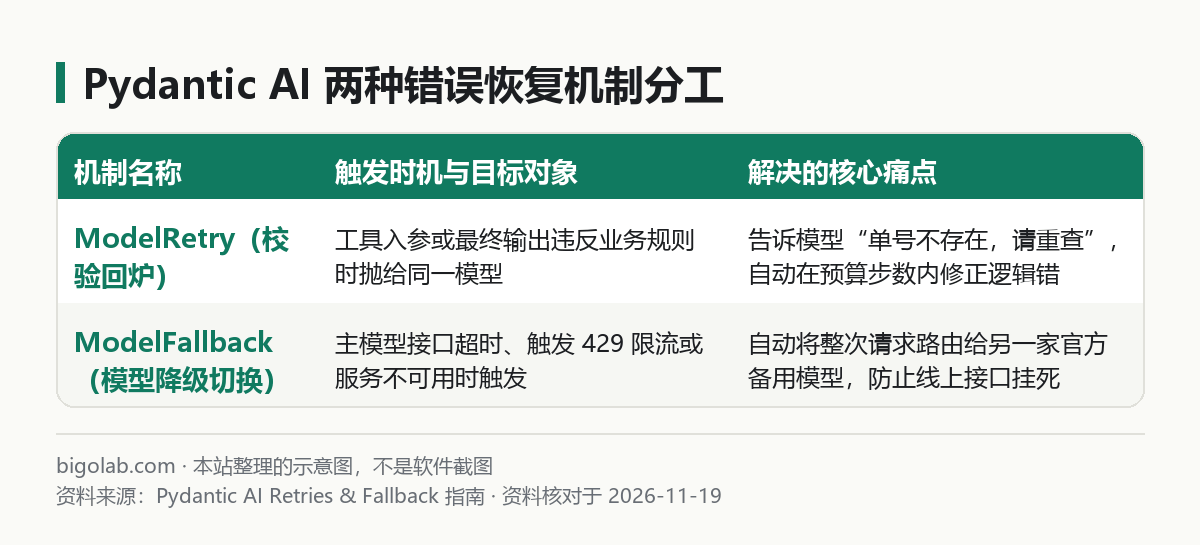
一、看清兩種恢復機制的職責邊界:ModelRetry 與 ModelFallback
很多剛進階的開發者容易把“校驗不通過讓模型重改”和“接口掛了換備用模型”混為一談。在 Pydantic AI 架構裏,這兩件事由完全不同的組件分工負責:
二、完整生產級代碼:依賴注入 + 數據庫深校驗自愈 + 備用模型容災
裝好核心包(pip install pydantic-ai),下面這段結構緊湊的代碼展示瞭如何像寫 FastAPI Depends 一樣,把異步數據庫連接與當前用戶身份強類型注入給動態指令、工具函數與輸出校驗器:
python
import asyncio
from dataclasses import dataclass
from pydantic import BaseModel, Field
from pydantic_ai import Agent, ModelRetry, RunContext
from pydantic_ai.capabilities import ModelFallback

# 1. 定義運行時依賴容器:測試時可輕鬆替換為內存替身對象,無需連真實數據庫
@dataclass
class SupportDeps:
    current_user_id: str
    valid_orders: dict[str, str]  # 生產中替換為異步數據庫連接池如 AsyncSession

# 2. 定義強類型最終輸出結構
class RefundDecision(BaseModel):
    order_id: str = Field(description="核實存在且歸屬當前用戶的訂單號")
    approved: bool
    reason_cn: str = Field(description="給用戶的簡明中文處理說明")

# 3. 初始化智能體:綁定依賴類型、重試預算及跨廠商熱備模型
refund_agent = Agent(
    "anthropic:claude-sonnet-4-5",
    deps_type=SupportDeps,
    output_type=RefundDecision,
    retries=2,  # 允許工具或輸出校驗觸發最多 2 次回爐修正
    capabilities=[ModelFallback("openai:gpt-4o")],
)

# 4. 動態系統指令:通過 ctx.deps 安全讀取當前請求上下文
@refund_agent.instructions
def dynamic_user_context(ctx: RunContext[SupportDeps]) -> str:
    return f"當前發起售後的登入用戶 ID 為 {ctx.deps.current_user_id},嚴禁處理他人名下訂單。"

# 5. 工具函數:首參聲明 RunContext[SupportDeps],IDE 自動補全所有依賴屬性
@refund_agent.tool
async def list_my_orders(ctx: RunContext[SupportDeps]) -> dict[str, str]:
    """查詢當前用戶名下所有真實歷史訂單號及狀態。"""
    return ctx.deps.valid_orders

# 6. 業務級深層輸出校驗器:攔截“格式合法但業務查無此單”的幻覺輸出
@refund_agent.output_validator
async def verify_order_exists(
    ctx: RunContext[SupportDeps], decision: RefundDecision
) -> RefundDecision:
    if decision.order_id not in ctx.deps.valid_orders:
        raise ModelRetry(
            f"訂單號 '{decision.order_id}' 在當前用戶名下不存在。"
            "請先調用 list_my_orders 工具核實真實單號後再重新輸出結構化結果。"
        )
    return decision

async def main():
    deps = SupportDeps(
        current_user_id="U-801",
        valid_orders={"ORD-202611": "已簽收三天"},
    )
    # 故意輸入一個用戶記錯的模糊單號,觸發校驗攔截 -> 自動調工具核實 -> 自愈通過
    res = await refund_agent.run("幫我給尾號 2611 的那個訂單申請退貨", deps=deps)
    print(res.output)

if __name__ == "__main__":
asyncio.run(main())研發團隊訂閱與高配額省心方案:調試複雜多步智能體循環、RAG 切片策略與 CI 評測流水線非常消耗單日 Token。個人主力開發推薦免上號兌換 Claude Pro iOS 自助卡密 或 5 倍額度的 Claude Max 5x,多人研發團隊協同亦可聯絡客服定製 ChatGPT Business 團隊版。
三、這套設計給工程團隊帶來的三個真金白銀收益
相比在普通工作流框架(例如對比 LlamaIndex Workflows 或 LangGraph 狀態圖)裏手寫一堆 try/except JSONDecodeError 循環,上面這段代碼把最髒的膠水邏輯全部收歸框架底層:
- 靜態類型檢查直接抓低級拼寫 Bug:你在
Agent(..., deps_type=SupportDeps)裏聲明瞭依賴類型,如果在工具裏不小心手滑把ctx.deps.current_user_id敲成了ctx.deps.user_id,不用等上線跑代碼,編輯器裏的 Pyright 或 Mypy 當場就會標紅報錯。 - 單元測試一秒跑完零外部耦合:寫
pytest單元測試時,根本不需要拉起 Docker 數據庫容器,只需構造一個塞了假字典的SupportDeps實例傳進agent.run(..., deps=fake_deps),連模型本身都可以用內置的TestModel替身秒級跑通全鏈路校驗邏輯。 ModelRetry把報錯文案變成最精準的二次提示詞:注意看第 47 行拋出的ModelRetry異常文本——務必用清晰直白的語言寫明“哪裏錯了 + 下一步該調哪個工具糾正”,並通過ctx.retry觀察當前是第幾次重試,通常retries=2就能救回九成以上的字段疏漏。
日常編寫 Python 類型安全後端與多模型容災架構時,搭配高配額的官方編程訂閱與推理帳號能大幅提升聯調效率。需要開通海外正規開發訂閱的工程師,可前往查看貝果研究社 Claude Code 訂閱與配置方案或全站 AI 訂閱自助導航。
常見問題
在工具函數內部(@agent.tool)如果發現大模型傳進來的查詢參數不合法,也能拋 ModelRetry 嗎?
完全可以,而且非常推薦這樣做。比如大模型傳了一個格式錯誤的日期字符串 "昨天" 給要求 YYYY-MM-DD 的統計工具,千萬不要直接拋普通的 ValueError 讓整個請求崩潰退出,而是直接 raise ModelRetry("日期參數必須為 YYYY-MM-DD 格式,請修正後重調本工具"),大模型看到反饋後下一秒就會自己改好參數重調一次。
運行時想臨時給 VIP 用戶升級成更強的模型,需要重新實例化一個新的 Agent 嗎?
不需要。Agent 實例在設計上是無狀態、全局可安全複用的單例(就像 FastAPI 的 APIRouter)。遇到高價值請求需要臨時切換模型時,只需在單次執行時傳入覆蓋參數 await refund_agent.run(prompt, deps=deps, model="anthropic:claude-opus-4-6"),僅對當次請求生效且絕不污染其他並發用戶。
如果連續觸發了 2 次 ModelRetry 模型依然改不對,後端該怎麼捕獲降級?
當重試次數耗盡(超過 retries=2 設定的預算)仍未通過輸出校驗時,Pydantic AI 會拋出明確的 UnexpectedModelBehavior 異常。生產接口中建議在 agent.run() 外層捕獲該異常,記錄下 capture_run_messages() 裏的完整工具交互軌跡用於事後排查提示詞漏洞,同時向前端返回一個溫和的人工兜底狀態(例如將工單轉入待人工客服覆核隊列),保證核心業務鏈路永不白屏報錯。
搭好開源框架後,國內沒有外幣信用卡怎麼開通主力編程與大模型訂閱?
可在 本站 AI 會員充值中心 使用支付寶、微信支付或 AlipayHK 自助選購卡密,支持免交密碼兌換 Claude Code(Pro / Max)、ChatGPT Plus 與 ChatGPT Pro,並支持開具增值稅發票;實時價格與售後邊界(封號不在質保範圍)以對應商品頁說明為準。
小結
- 通過
@dataclass搭配deps_type與RunContext[Deps],實現零全局變量、完美支持靜態類型檢查與單測替身的依賴注入。 - 用
@agent.output_validator配合raise ModelRetry("具體糾錯指引"),把數據庫查無此單等業務幻覺攔截在閉環內部自動重修。 - 將
Agent定義為無狀態模組級單例,配合ModelFallback掛載跨廠商備用官方模型,輕鬆扛住單點接口限流抖動。
0 條評論
還沒有評論,來搶沙發~