
當你的大模型應用從簡單的“一問一答”演進到“先檢索知識庫 -> 讓模型自檢相關性 -> 如果沒搜準自動改寫查詢詞再搜一遍 -> 最後綜合生成帶引用答案”的閉環時,早期的有向無環鏈(DAG Chains)就徹底不夠用了,因為鏈條很難優雅地表達循環回跳(Loops)與動態並行扇出。
目前 Python 生態裏解決這個痛點有兩大主流學派:一派是以顯式全局狀態機和連邊著稱的 LangGraph,另一派就是 LlamaIndex 官方全面主推的 LlamaIndex Workflows(事件驅動異步工作流)。下面先幫你把兩者的選型帳算明白,再用一份可直接運行的自糾錯檢索代碼帶你快速入門。
AI 全棧開發訂閱配套入口:在本地部署與聯調開源 AI 框架時,搭配固定月費的終端編程智能體與旗艦推理訂閱能大幅縮短排錯時間。國內無境外信用卡可在本站通過支付寶、微信支付或 AlipayHK 免密自助開通 Claude Code 訂閱、ChatGPT Plus / Pro 或查看 AI 會員充值總覽。
一、選型不糾結:LlamaIndex Workflows 與 LangGraph 到底怎麼挑
很多架構師在啟動新項目時都會對比這兩套框架(低代碼與代碼級平台全局對比可先參考 Dify、Coze、n8n 與 LangGraph 選型指南)。其實它們沒有絕對高下,核心區別在於你更習慣寫“事件訂閱函數”還是畫“嚴格狀態轉換圖”:
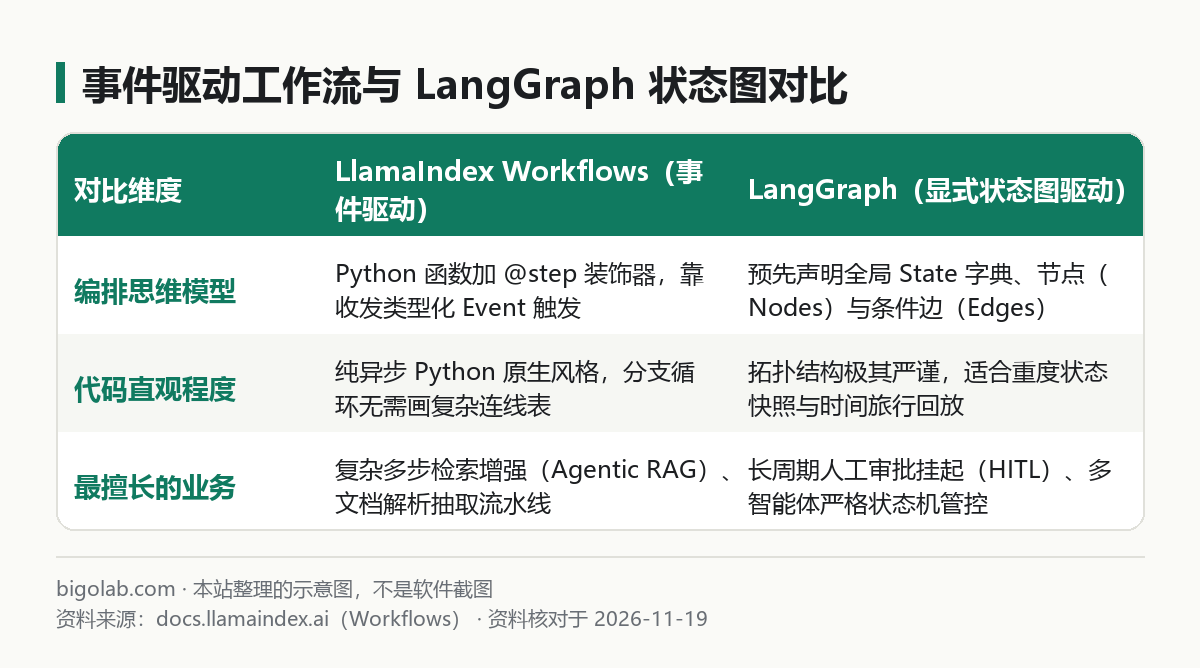
給出一條非常接地氣的團隊選型標尺:
- 優先選 LlamaIndex Workflows:如果你的核心業務重度圍繞複雜文檔解析、多源混合檢索(Agentic RAG)、財報合同多步抽取校驗,且團隊後端更喜歡像寫 FastAPI 路由那樣“給普通異步函數加個
@step裝飾器、靠 Python 類型註解自動推導上下游”,Workflows 的代碼量極其清爽,沒有任何多餘的連線樣板代碼。 - 優先選 LangGraph:如果你的系統核心難點在於跨數天掛起等待人類經理點審批按鈕(Human-in-the-Loop)、極其嚴格的多智能體主管派單狀態快照回滾(詳見 LangGraph 多智能體 Supervisor 與子圖架構),顯式狀態圖的可控度更強。
二、搞懂四個核心積木:Event、@step、Start/Stop 與 Context
在 LlamaIndex Workflows 裏,你完全不需要手動調用類似 add_edge(A, B) 的連線函數。框架在啟動瞬間會直接掃描每個異步方法的入參類型和返回值類型註解(Type Hints),自動把整張異步執行網絡拼裝出來:
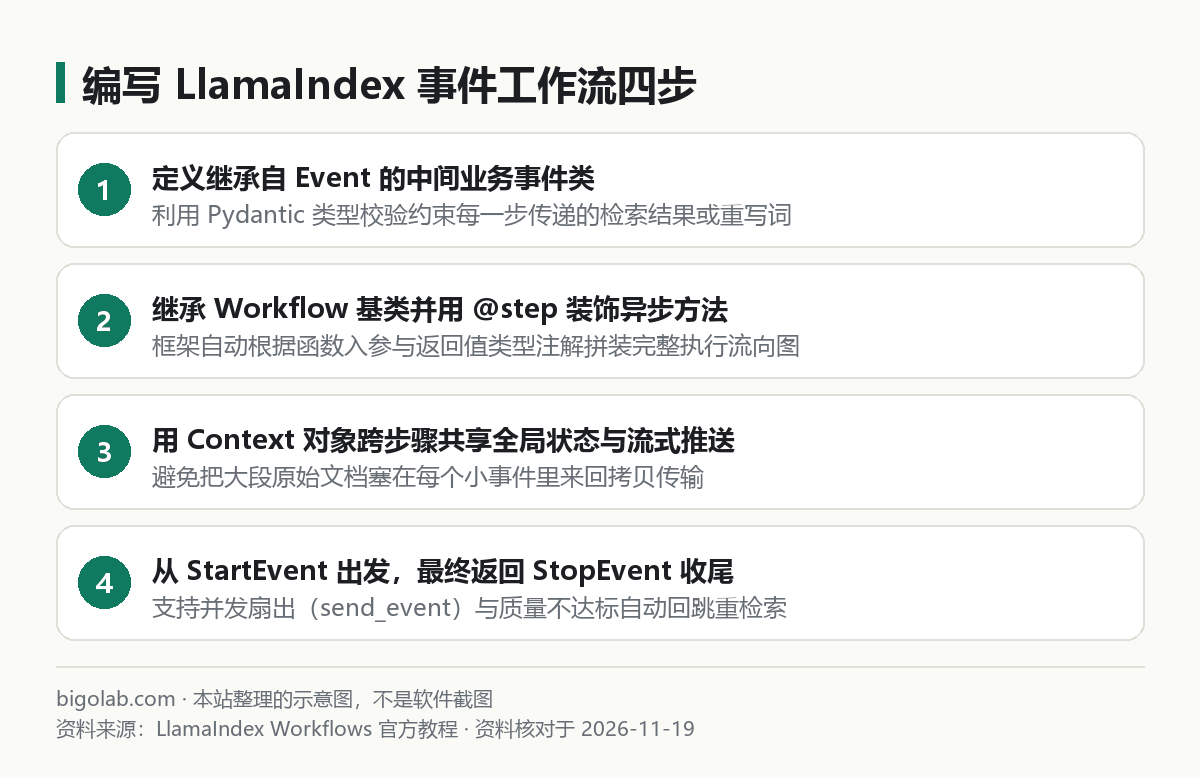
StartEvent與StopEvent:一頭一尾兩個官方內置錨點。接收StartEvent的步驟是工作流唯一入口;只要任意一個步驟返回了StopEvent(result=...),整趟任務立即收工並把結果交還調用方。- 自定義
Event(繼承自 PydanticBaseModel):步驟與步驟之間傳遞的信封,自帶強類型字段校驗。 @step裝飾器:貼在Workflow子類的async def方法頭上。支持聯合類型註解(如-> RerankEvent | RewriteQueryEvent),這就是它實現條件分支與循環回跳的全部秘密——根本不用額外寫條件路由表。Context(全局共享上下文):如果原始文檔很大,沒必要塞在每個事件對象裏拷來拷去;在函數簽名裏聲明ctx: Context,即可用鍵值存儲安全讀寫跨步狀態(例如記錄“當前已經重試改寫了幾次查詢詞”防死循環)。
研發團隊訂閱與高配額省心方案:調試複雜多步智能體循環、RAG 切片策略與 CI 評測流水線非常消耗單日 Token。個人主力開發推薦免上號兌換 Claude Pro iOS 自助卡密 或 5 倍額度的 Claude Max 5x,多人研發團隊協同亦可聯絡客服定製 ChatGPT Business 團隊版。
三、完整實戰代碼:手寫一個“搜不準自動改詞重搜”的自糾錯工作流
安裝輕量工作流核心包(pip install llama-index-core 或獨立包 pip install llama-index-workflows),儲存下面這段零外部數據庫依賴的骨架代碼即可直接跑通循環控制邏輯:
python
import asyncio
from llama_index.core.workflow import (
    Workflow,
    step,
    Event,
    StartEvent,
    StopEvent,
    Context,
)

# 1. 定義步驟間流轉的強類型業務事件
class RetrievedEvent(Event):
    query: str
    docs: list[str]

class RewriteEvent(Event):
    original_query: str
    reason: str

# 2. 組裝自糾錯檢索工作流:無需手寫一行 add_edge 連線代碼
class CorrectiveRAGWorkflow(Workflow):
    @step
    async def retrieve(self, ctx: Context, ev: StartEvent | RewriteEvent) -> RetrievedEvent:
        if isinstance(ev, StartEvent):
            query = ev.topic
            await ctx.store.set("retries", 0)
        else:
            # 收到回跳的重寫事件時,優化檢索詞再次查詢
            query = f"{ev.original_query} 生產環境部署參數詳解"

        # 此處替換為真實向量庫或混合檢索引擎查詢
        mock_docs = ["vLLM 分頁注意力架構簡述"] if "參數詳解" not in query else ["vLLM 生產啟動需配置 --max-model-len 與 --gpu-memory-utilization"]
        return RetrievedEvent(query=query, docs=mock_docs)

    @step
    async def grade_and_answer(self, ctx: Context, ev: RetrievedEvent) -> RewriteEvent | StopEvent:
        retries = await ctx.store.get("retries", default=0)
        joined = "\n".join(ev.docs)

        # 若檢索片段未包含具體配置參數且未超重試上限,觸發事件自動回跳上一環節
        if "--" not in joined and retries < 2:
            await ctx.store.set("retries", retries + 1)
            return RewriteEvent(original_query=ev.query, reason="首輪片段缺少具體命令行參數")

        return StopEvent(result=f"最終核驗通過(重試 {retries} 次),參考依據:{joined}")

async def main():
    wf = CorrectiveRAGWorkflow(timeout=60, verbose=True)
    result = await wf.run(topic="vLLM 顯存配置")
    print(result)

if __name__ == "__main__":
    asyncio.run(main())
仔細看第 23 行的入參註解 ev: StartEvent | RewriteEvent 和第 35 行的返回註解 -> RewriteEvent | StopEvent:僅僅靠標準 Python 類型聲明,就天然閉環了“首輪檢索 -> 質素打分不達標 -> 拋回 RewriteEvent 重搜 -> 二次達標吐出 StopEvent”的完整循環,並且內置了 timeout=60 全局防卡死熔斷。
在工程落地階段調試這類異步多分支智能體代碼時,配合高水準的終端編程助手與旗艦推理模型能大幅縮短排錯時間。需要開通海外官方開發訂閱的工程師,可前往查看貝果研究社 Claude Code 訂閱與配置方案或全站 AI 訂閱自助導航。
常見問題
如果我不小心把兩個 @step 的類型註解寫拼錯了導致死路斷流,要等到線上跑崩才發現嗎?
不會。LlamaIndex Workflows 內置了靜態圖連通性校驗器與可視化工具:啟動前它會立刻檢查是否存在“某個事件被拋出了卻沒有任何步驟訂閱接收”或者“永遠無法抵達 StopEvent”的孤島錯誤並直接報出清晰異常;你還可以調用內置繪圖輔助函數一鍵把當前類的事件流轉拓撲導出成交互式 HTML 結構圖貼進技術評審文檔。
怎麼讓某一步同時並發跑三個子查詢、等三個結果全回來再彙總?
在需要扇出(Fan-out)的步驟裏,調用 ctx.send_event(SubQueryEvent(...)) 連續發射三次子事件;然後在負責彙總(Fan-in)的下游步驟裏調用 **ctx.collect_events(ev, [ResultEvent] 3)*。在湊齊 3 份返回結果之前彙總步驟會優雅掛起返回 None,一旦第 3 份結果抵達便立即向下執行合併總結。
搭好開源框架後,國內沒有外幣信用卡怎麼開通主力編程與大模型訂閱?
可在 本站 AI 會員充值中心 使用支付寶、微信支付或 AlipayHK 自助選購卡密,支持免交密碼兌換 Claude Code(Pro / Max)、ChatGPT Plus 與 ChatGPT Pro,並支持開具增值稅發票;實時價格與售後邊界(封號不在質保範圍)以對應商品頁說明為準。
小結
- LlamaIndex Workflows 採用純異步事件驅動架構,靠
@step方法的 Python 類型註解自動推導完整拓撲,徹底省去繁瑣的連邊樣板代碼。 - 文檔密集型多步檢索(Agentic RAG)與抽取流水線優先選 Workflows;重度長週期掛起審批與嚴格全局狀態機管控優先選 LangGraph。
- 編寫循環回跳邏輯時,務必在
Context存儲中維護最大重試計數器並給Workflow(timeout=...)設好全局超時兜底。
0 條評論
還沒有評論,來搶沙發~