
掌握了 Aider 基礎命令、Architect 雙模型與自動 Git 提交之後,想把效率再往上提一檔,核心在於打通無人值守的“改代碼 -> 跑靜態檢查 -> 跑單元測試 -> 報錯自動喂回模型重修”閉環,同時搞清楚它是怎麼在不燒穿 Token 預算的前提下看懂上百個文件調用關係的。
把倉庫根目錄的 .aider.conf.yml 配好,團隊每個人進目錄只需敲兩個詞 aider 就能直接享受全套自動化防線。
本站開發者訂閱直達入口:高頻跑多文件重構與工具鏈調用時,搭配固定月費的主力訂閱往往比純燒按量 API 更省錢。國內無境外信用卡可通過支付寶、微信支付或 AlipayHK 在本站免密自助開通 Claude Code 訂閱(Pro / Max)、ChatGPT Plus 或瀏覽 AI 會員充值總覽。
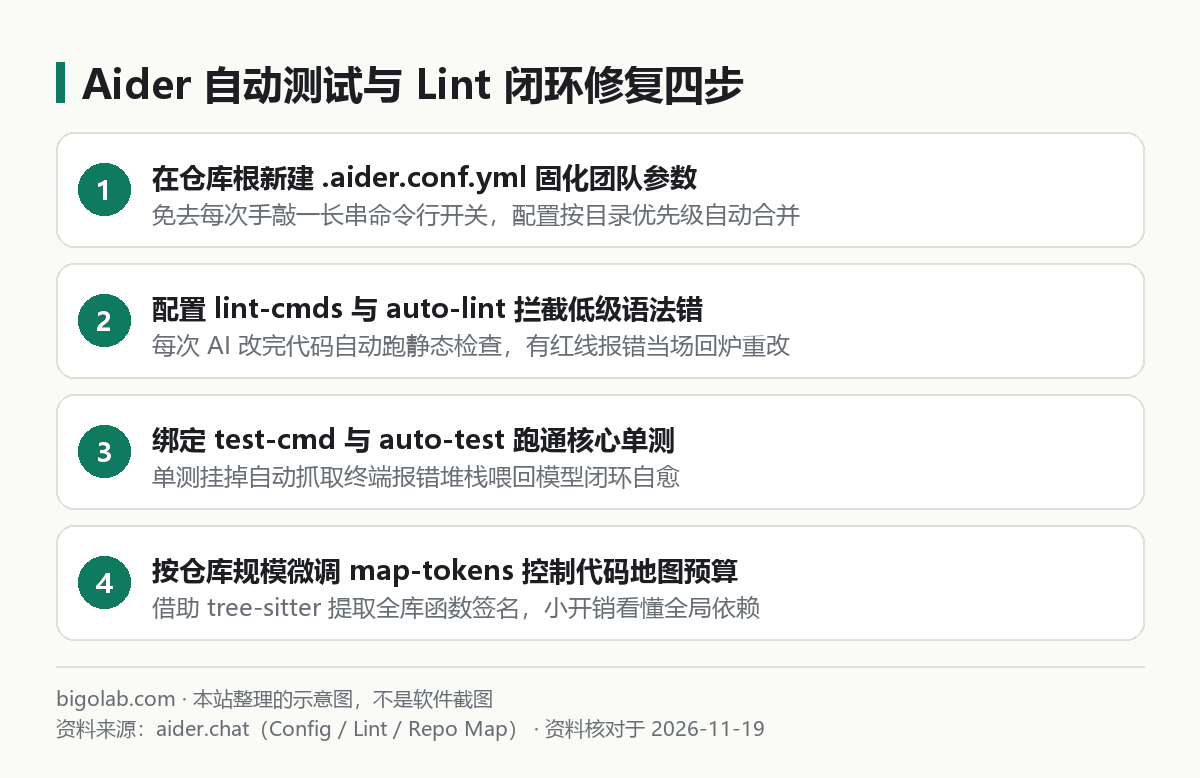
一、用 .aider.conf.yml 固化團隊參數與只讀規範
Aider 啟動時會按“用戶主目錄 ~/.aider.conf.yml -> Git 倉庫根目錄 .aider.conf.yml -> 當前工作子目錄”的優先級依次加載併合並 YAML 配置。
強烈建議在項目根目錄新建一份不含任何明文密鑰的 .aider.conf.yml 提交進 Git(個人 API Key 放進被忽略的 .env 或系統環境變量即可):
yaml
# 1. 預設啟用主腦 + 副手雙模型協作與提示詞緩存
model: anthropic/claude-sonnet-4-5
architect: true
cache-prompts: true
auto-commits: true

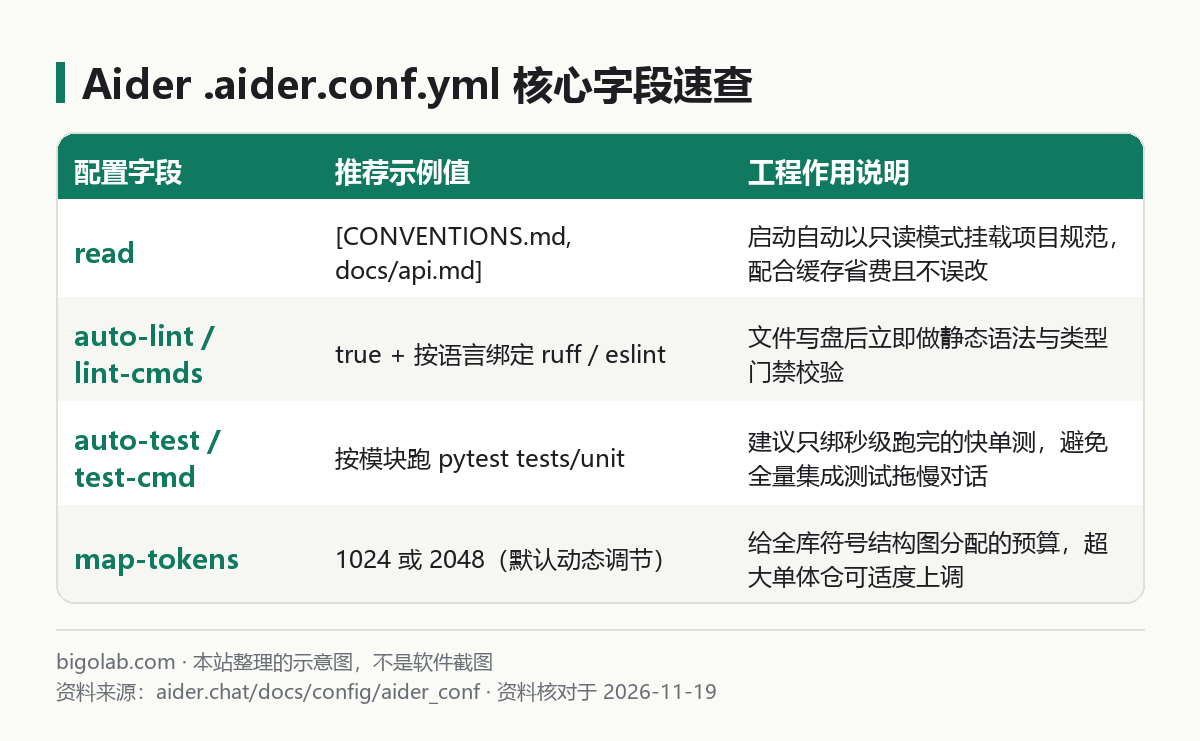
# 2. 啟動自動以只讀模式加載項目規範(絕不會被 AI 誤改)
read:
  - CONVENTIONS.md
  - docs/api-error-codes.md

# 3. 每次 AI 改完文件自動觸發靜態檢查與快速單測
auto-lint: true
lint-cmds:
  python: "ruff check"
  typescript: "npx eslint --quiet"

auto-test: true
test-cmd: "pytest tests/unit -q --maxfail=3"

# 4. 代碼庫符號地圖(Repo Map)預設預算控制
map-tokens: 2048
這裏有兩個非常省心的細節:
cache-prompts: true:配合read自動掛載的只讀項目規範文檔,開啟提示詞緩存後,後續多輪對話重複發送的固定規範文本與代碼地圖都能命中官方緩存摺扣,大幅壓低長會話開銷。- 與鉤子機制殊途同歸:這種寫盤即校驗的思路(正如我們在 Claude Code 裏配置 PostToolUse 自動跑 Prettier / Ruff 鉤子異曲同工,專門治大模型“順手漏引包、拼錯類型名”的小毛病)。
二、lint-cmds 與 test-cmd:讓報錯堆棧自動回爐自愈
如果不配自動測試,你每次等 AI 改完代碼,都要切到另一個終端手動敲 pytest,看到紅字報錯再複製一大段 Traceback 粘回聊天框說“修一下”。開啟 auto-lint 與 auto-test 後,整套動作會變成絲滑的流水線:
- 第一道關卡(Lint 靜態門禁):Aider 內置了基於語法樹的快速語法掃描;當你進一步在
lint-cmds裏按語言綁好ruff、mypy或eslint後,一旦修改後的文件觸發了未定義變量或類型不匹配告警,Aider 會當場截取報錯行喂回給大模型要求立刻訂正。 - 第二道關卡(
test-cmd單測門禁):靜態檢查過關後,系統緊接着自動在後台執行test-cmd指定的測試命令。測試全部綠燈則安心結束本輪對話;只要返回非零退出碼(Exit Code != 0),終端故障堆棧會自動打包發給模型觸發下一輪修復提交。
防拖慢對話的實戰鐵律:千萬不要把耗時五分鐘、需要連遠程 Docker 數據庫的全量端到端(E2E)集成測試直接綁進auto-test: true,否則 AI 每改兩行代碼你都要乾等五分鐘。日常開發建議只綁兩三秒內就能跑完的純內存單元測試子集(或者平時關掉auto-test,等一個模組改完後手動在聊天框敲/test觸發一次檢驗)。
重度編碼配額與雙引擎互補建議:在開源插件或終端智能體裏處理大型單體倉庫時,不少工程師會同時備好一套包月封頂的官方訂閱兜底複雜架構攻堅。可按需前往查看 Claude Max 5x / 20x 充值說明、Claude Pro iOS 自助卡密 或 ChatGPT Pro 充值頁。
三、看懂 Repo Map(代碼地圖):為什麼沒 /add 的文件它也知道怎麼調
很多剛上手的同學會好奇:“我明明只用 /add 餵了 order_service.py 一個文件,為什麼 Aider 卻能精準寫出另一個目錄裏 PaymentClient.charge(amount, currency) 的參數名,完全沒有瞎編?”
幕後功臣就是 Aider 基於 Tree-sitter 語法解析器加圖排序算法構建的 Repo Map(全庫結構地圖):
- 它不會傻乎乎地把全倉庫幾百個文件的完整函數體硬塞進上下文(那樣一輪就會燒掉幾十萬 Token);也不像重型 IDE 那樣需要在後台建龐大的向量索引庫(避免了代碼庫索引卡住或漏文件的煩惱)。
- 相反,它只在本地秒級提取所有源碼文件裏的類名、核心函數簽名、導出接口與跨文件引用關係,算出與你當前
/add文件關聯最緊密的骨架摘要,濃縮進短短1024或2048個 Token(由map-tokens控制)裏發給模型。 - 模型看到這張“全庫通訊錄”後,如果發現某處底層實現細節必須看源碼才能改準,會主動在對話裏禮貌地請求你允許把對應文件加入上下文。在聊天框隨時敲
/map命令,你就能親眼看到當前這一輪發給大模型的精簡代碼地圖長什麼樣。
如果你在重度工程團隊裏既用 Aider 跑精準模組單測閉環,又需要固定額度的官方包月訂閱工具處理日常全庫探索任務,可以前往了解貝果研究社 Claude Code 訂閱與配置方案或查看全站 AI 開發者訂閱自助導航。
常見問題
我的單體倉庫有幾千個歷史遺留腳本,Repo Map 會把構建產物或老廢代碼也掃進去嗎?
Repo Map 預設只掃描當前受 Git 版本追蹤(Tracked)的源碼文件,已經寫進 .gitignore 的 dist/、node_modules/ 絕不會被掃入。如果倉庫裏還有受 Git 追蹤但不想讓 AI 看見的廢棄老目錄或龐大靜態數據文件,可以在根目錄新建一份 .aiderignore(語法與 .gitignore 完全一致)把它們屏蔽掉,讓寶貴的 map-tokens 預算全留給核心業務目錄。
如果跑 auto-test 時遇到死衚衕,AI 連續改了三次單測還是掛,會無限燒錢死循環嗎?
不會無限死循環,Aider 對連續自動修復輪次設有內置安全上限;但一旦看到模型對同一個報錯連續兩次給出相似的無效修改,說明它缺少關鍵上下文或判斷錯了根因。此時直接按 Ctrl+C 中斷自動重試,敲 /undo 退回乾淨狀態,再用 /add 把相關的底層依賴文件補進來重新指明方向最省錢。
國內沒有海外信用卡,怎麼開通 Claude Code 或 ChatGPT 編程訂閱?
可直接在 本站充值中心 使用支付寶、微信支付或 AlipayHK 下單獲取自助卡密,支持免上號兌換 Claude Pro、Claude Max 與 ChatGPT Plus / Pro,可開具增值稅發票;實時價格、兌換前提與售後邊界(封號不在質保範圍)以對應商品頁說明為準。
小結
- 在項目根目錄配置
.aider.conf.yml,配合read只讀規範與cache-prompts: true,既統一團隊參數又能吃滿官方提示詞緩存摺扣。 - 綁定按語言觸發的
lint-cmds與秒級跑完的輕量test-cmd,把低級語法錯與單測迴歸攔截在落盤瞬間自動自愈。 - 善用
/map查看 Tree-sitter 代碼地圖並通過.aiderignore剔除陳舊目錄,花極小的 Token 預算讓模型精準掌握全局調用鏈。
0 條評論
還沒有評論,來搶沙發~