Cursor Codebase Indexing 索引一直卡住或搜不到文件:.cursorignore 與 .cursorindexingignore 區別

打開大項目時 Cursor 索引進度條一直卡在 40% 失敗,或者把目錄寫進 .cursorignore 後連手動敲 @ 都選不中文件了?本文按官方文檔拆解兩個專用忽略文件的硬軟邊界與四步重建索引排錯。

NNathaniel bigo··原創首發·AI 輔助撰寫
9 分鐘讀完
資料核對於 2026-11-19 · 依據官方文檔與公開資料整理 Plus 帳號

結論先說

  1. 千萬分清兩兄弟:.cursorignore 是「全功能硬拉黑」,.cursorindexingignore 才是「只跳後台索引、保留手動 @」:把超大靜態字典和老歸檔目錄放進後者,既能讓索引秒級跑完,又不耽誤你偶爾手動點名查它。
  2. 預設自動繼承 .gitignore:已經被 Git 忽略的 node_modules/、dist/ 不用再重複抄一遍;真正拖死索引進度條的元兇,往往是提交進了 Git 倉庫裏的幾兆大 JSON 樣本、SQL 備份或壓縮混淆 JS。
  3. 搜不到剛新建的代碼或進度條僵死時,進設定先點 Resync 不行再 Delete Index 重建:若伴隨網絡握手報錯,順手把網絡設定裏的 HTTP/2 降級模式打開。
  4. 大倉庫檢索與雙工具互補:需要開通訂閱額度或在重型工程搭配純終端引擎,可查看本站 Grok / X 訂閱充值說明 與 Claude Code 訂閱服務。
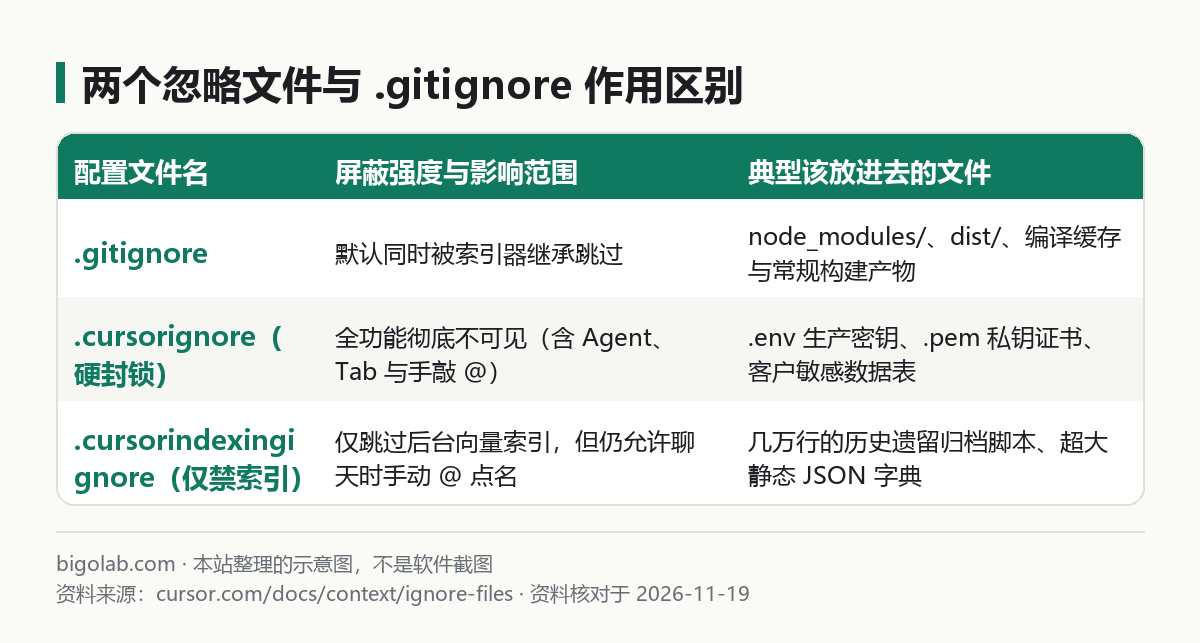
兩個忽略文件與 .gitignore 作用區別

圖:本站根據 Cursor Ignore Files 官方文檔 整理的三份忽略配置作用域對比圖

本文根據 Cursor 官方文檔《Codebase Indexing》《Ignore Files》(cursor.com/docs/context/ignore-files)整理,資料核對於 2026-11-19。配圖為本站整理的示意圖,不是軟件截圖。本站(bigolab.com)不是 Cursor 官方網站。

適用於誰

  • 打開幾萬個文件的老倉庫時,Cursor 右上角設定裏的 Codebase Indexing(代碼庫索引) 一直轉圈卡死或報 Handshake failed 同步失敗的開發者;
  • 為了加速索引把歷史腳本文件夾塞進了 .cursorignore,結果需要參考時發現在聊天框手動敲 @ 都搜不到那個文件的人;
  • 擔心本地 .env 生產密鑰、.pem 私鑰證書在自動檢索時被誤傳到雲端模型接口的安全負責人。

一、兩份可直接複製的忽略文件標準模板

語法跟標準 .gitignore 完全一致,放在你項目的根目錄下即可生效:

1. .cursorignore(安全底線硬封鎖:AI 絕對不準看)

凡是涉及密鑰、證書、真實客戶導出表的文件,萬一沒寫進 .gitignore(比如本地測試用的配置模板),必須寫進 .cursorignore——寫入後 Agent、Chat、Tab 自動補全以及手動 @ 選單統統無法讀取它們(私隱設定全貌見 Cursor Privacy Mode 私隱模式說明):

gitignore
# 嚴禁任何 AI 功能讀取的敏感憑據與私鑰
.env
.env.*
!.env.example
*.pem
*.key
secrets/
customer_dumps/

2. .cursorindexingignore(性能優化軟過濾:不建向量庫,但能手動 @)

凡是沒有安全機密、但體積巨大純屬佔坑污染 @Codebase 搜尋準確度的文件(符號用法見上一篇 Cursor @ 引用符號全解),一律放進這裏:

gitignore
# 跳過後台 AST 向量嵌入索引,保留需要時手動 @Files 引用能力
migrations/legacy_*.sql
test/fixtures/**/*.json
public/vendor/*.min.js
docs/archive/
pnpm-lock.yaml
package-lock.json
AI 編程主力訂閱與多工具分流方案:日常寫代碼把行內補全交給 IDE,把跨十幾個文件的重度重構與單測閉環分流給固定月費的終端智能體,是目前最省預算的組合拳。本站支持支付寶、微信支付與 AlipayHK 免密自助開通 Claude Code 訂閱(含 Claude Max 5x)、ChatGPT Plus / Pro 與 SuperGrok 會員。

二、索引一直卡住、報失敗或漏掉新文件的四步排查
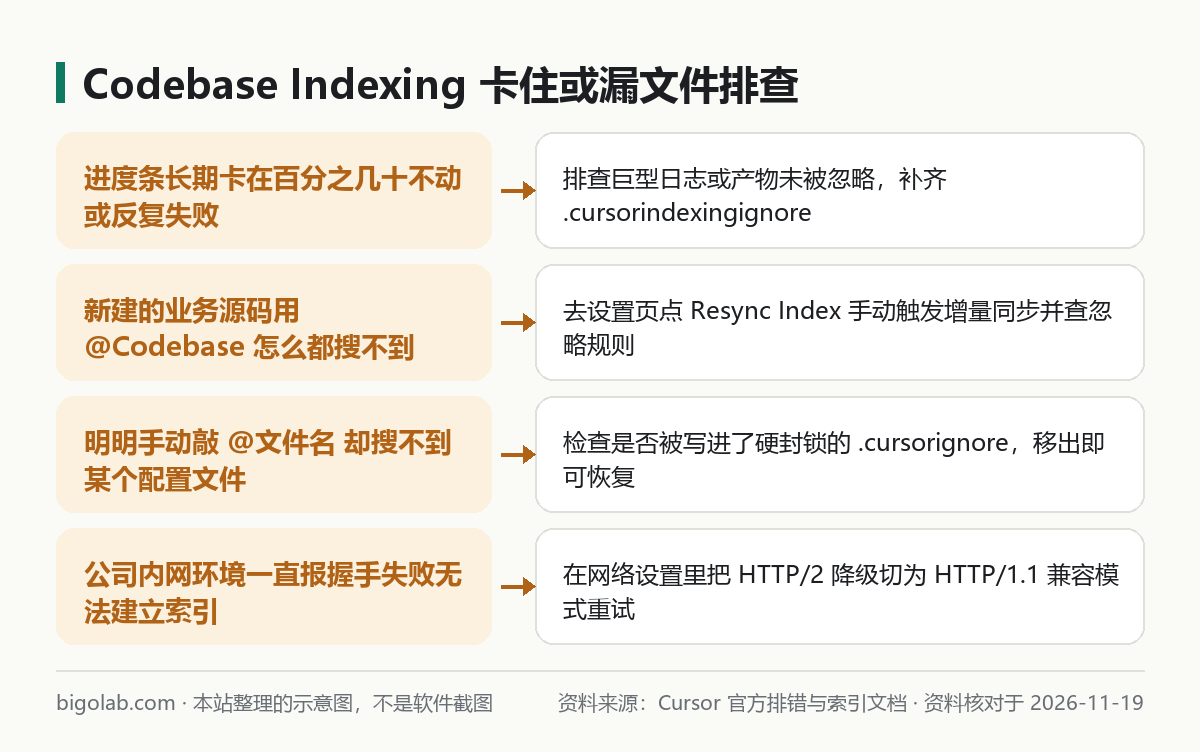
Codebase Indexing 卡住或漏文件排查

圖:本站根據 Cursor 代碼庫索引官方文檔 整理的排錯決策示意圖

  1. 揪出倉庫裏藏着的「巨無霸文本文件」:在終端跑一條命令找出被 Git 追蹤但大於 500KB 的大文件(比如前端沒忽略的 sourcemap 或測試錄製快照),把它們補進上面的 .cursorindexingignore,九成的卡進度條問題當場解決。
  2. 手動刷新或徹底刪庫重建:打開 Cursor Settings → Features → Codebase Indexing。如果剛拉下同事新合入的幾十個文件搜不到,點一次同步(Resync);如果狀態一直紅字卡在異常百分比,點 Delete Index(刪除索引) 清掉損壞狀態重新跑一遍乾淨索引。
  3. 企業內網報 Connection failed 或索引握手超時:部分公司防火牆或網關對長連接雙向流兼容性不佳(常規網絡斷連排查見 Cursor 連接失敗報錯解決)。打開設定搜 HTTP Compatibility Mode,從預設的 HTTP/2 切換為 HTTP/1.1 後重新點索引即可跑通。
  4. 檢查客戶端是否低於最低受支持版本:過舊的歷史客戶端偶爾會因為服務端索引接口升級而無法同步,順手核對更新方法見 Cursor 版本升級與最低版本要求。

常見問題

問:打開一個全新的陌生開源大項目查兩眼源碼,不想讓它一上來自動建索引耗流量怎麼辦?

答:可以在 Cursor Settings → Features → Codebase Indexing 裏把「對新打開的倉庫自動建立索引」預設關掉。平時只讀兩眼的項目靠普通正則搜文件名就夠了,確定要長期深度開發的項目再手動點開啟索引。

問:為什麼 .gitignore 裏已經忽略了 build/,我想讓 AI 幫我看一眼構建報錯產物卻 @ 不出來?

答:因為預設繼承了 .gitignore。如果你臨時想對某個被 Git 忽略的目錄解除封鎖,可以在 .cursorignore 裏用感嘆號反選語法(如 !build/report.json),或者直接把報錯片段複製粘進對話框最省事。

問:代碼庫索引會把我的全部源碼明文永久存在雲端嗎?

答:按官方文檔說明,建立語義索引時會計算代碼塊嵌入向量與加密路徑哈希用於匹配行號,源碼正文在你本地需要時才按命中片段組裝;開啟私隱模式後更嚴格遵守零數據留存策略(Tab 補全觸發邏輯見 Cursor Tab 代碼補全教學)。

問:按量 API 帳單波動太大,國內沒有境外卡怎麼開通固定包月的 AI 編程訂閱?

答:可在 本站 AI 會員充值中心 按編碼強度自助選購 Claude Pro iOS 自助檔、Claude Max 充值 或包含 Codex 額度的 ChatGPT Pro 充值,全程卡密自助兌換無需交出密碼,封號不在質保範圍。

相關教學

Nathaniel 的更多內容

  1. 01

    獨立開發者用 ChatGPT + Codex 跑通產品全流程:市場驗證、PRD、原型到代碼上線覆盤清單

    單人做獨立產品最容易陷入「閉門寫兩個月代碼上線零用戶」或「AI 寫到一半目錄越改越崩」。本文整理「ChatGPT 負責市場驗證、PRD 與覆盤 + Codex 負責工程實現與測試」的五階段雙軌流程,附起手提示詞與 7 項上線覆盤清單。

    ChatGPTCodex0
  2. 02

    用 ChatGPT 批量生成規範文件命名規則、整理混亂目錄樹與合併零散發票抬頭清單腳本

    面對滿桌面的「新建文件夾」「最終版2」和上百張零散電子發票,手工改名抄台帳耗時又容易漏重。本文分享先脫敏取樣、再用 ChatGPT 生成帶預演和回滾日誌的本地 Python 腳本,離線安全完成目錄整理與發票抬頭合併去重的實戰流程。

    ChatGPT0
  3. 03

    用 ChatGPT 做海外電郵營銷(EDM)受眾分層文案、A/B 主題行測試與防進垃圾箱自檢

    做海外獨立站或出海 SaaS 電郵營銷(EDM),最怕千人一面群發被直接送進垃圾箱。本文結合 Gmail/Yahoo 批量發件人規範,梳理用 ChatGPT 設計受眾分層文案、批量生成 A/B 主題行矩陣並開展發前垃圾詞與合規自檢的實戰提示詞。

    ChatGPT0
  4. 04

    用 ChatGPT 寫 Notion Formula 2.0 公式、Obsidian Dataview 查詢與 Airtable 自動化腳本

    給 Notion 數據庫寫多條件 Formula 2.0 公式、給 Obsidian 寫 Dataview 動態看板,或在 Airtable 裏寫自動化腳本,經常因為一個小括號或類型不匹配報錯半天。本文整理三大工具的通用上下文喂料規範與三套直接可複製的生成提示詞。

    ChatGPT其他 AI 工具0
  5. 05

    用 ChatGPT 處理複雜 JSON / YAML / XML 字段映射、格式轉換與校驗規則編寫實戰

    對接第三方 API、遷移 Kubernetes 配置或解析政企 XML 報文時,手工對照幾百行嵌套字段既慢又容易漏掉空值與類型邊界。本文整理用 ChatGPT 完成字段映射表梳理、生成確定性轉換腳本以及編寫 JSON Schema / Pydantic / XSD 校驗規則的實戰流。

    ChatGPT其他 AI 工具0
  6. 06

    用 ChatGPT 準備本科/碩士畢業論文答辯:提煉答辯 PPT 結構、模擬導師犀利追問與 3 分鐘自述稿

    畢業論文寫完後,要在 3–5 分鐘內講清研究價值並頂住答辯評委的連環追問並不輕鬆。本文整理在嚴格遵守高校學術規範的前提下,用 ChatGPT 提煉答辯 PPT 結構、打磨 3 分鐘口語自述稿並開展模擬導師犀利追問的排練流程與提示詞。

    ChatGPT0

同產品的其他教學

  1. 01

    用 ChatGPT 速讀英文產品手冊、開源文檔與 GitHub Issue 並沉澱團隊中文內訓手冊

    團隊引入海外 SaaS 工具或開源框架時,全英文文檔晦澀冗長、真正的坑全藏在幾十頁 GitHub Issue 討論裏。本文分享速讀拆解英文手冊、歸類 Issue 排障庫以及重構團隊中文內訓 SOP 的完整實戰流程。

    ChatGPT其他 AI 工具0
  2. 02

    用 ChatGPT 寫油猴腳本(Tampermonkey)與瀏覽器書籤小工具解決網頁繁瑣重複操作實戰

    每天在後台系統裏重複勾選幾十個複選框、手工複製網頁表格或清理遮擋閱讀的側邊欄,既枯燥又浪費時間。本文分享不會寫 JS 也能用 F12 配合 ChatGPT 寫出油猴腳本與書籤小工具的完整實戰流程。

    ChatGPT其他 AI 工具0
  3. 03

    用 ChatGPT 寫高質素 SQL 窗口函數(RANK / LAG / SUM OVER)做留存與漏斗分析實戰

    做用戶留存率、復購間隔與有序轉化漏斗時,多層自連接既難讀又拖垮數據庫,窗口函數則是高效解法。本文整理數據庫方言喂數規範、CTE 分層提示詞以及用內置沙盒先驗證再上線的完整實戰流程。

    ChatGPT其他 AI 工具0
  4. 04

    ChatGPT 連接 Canva、Figma、Linear、Jira、Dropbox 等第三方應用搜不到數據或授權失效怎麼辦

    在 ChatGPT 接入 Canva、Figma、Linear、Jira 或 Dropbox 後,明明顯示已連接卻搜不到文件工單,或老提示授權失效怎麼辦?本文拆解帳號錯綁、OAuth 範圍漏選、權限繼承與管理員攔截 5 步排障法。

    ChatGPT其他 AI 工具0
  5. 05

    Anthropic Contextual Retrieval(上下文增強檢索)是什麼、怎麼實現:給文檔塊自動補背景摘要結合緩存降失誤率

    長文檔切成小塊後丟了公司名、年份和主語指代導致 RAG 頻頻搜錯?本文按 Anthropic 官方技術文章詳解 Contextual Retrieval 原理、官方公開評測失誤率下降 49% 至 67% 的組合架構,以及用 Claude 提示詞緩存低成本批量生成切片背景的完整 Python 代碼。

    Claude其他 AI 工具0
  6. 06

    RAG 知識庫回答不準怎麼調優:切片大小(Chunking)、BM25 + 向量混合檢索與 Rerank 重排序三步排查法

    搭好的 RAG 企業知識庫一問具體型號、報錯碼或跨行表格就答非所問?本文按 OpenAI 與 Anthropic 官方檢索文檔,給出先隔離檢索與生成故障、再按結構化切片(Chunking)、BM25 加向量混合召回(RRF)與 Rerank 重排序逐層調優的三步法。

    Claude其他 AI 工具0

0 條評論

登入 後參與評論

還沒有評論,來搶沙發~