
結論先說
- Claude Code 沒有云端自動同步給全組的「隱式聊天記憶池」:官方的自動記憶(auto memory)是純本地 Markdown 文件,只留在你自己的電腦上,不會自動傳給隊友。
- 你本機的多個
git worktree預設共享同一份自動記憶:同一個 Git 倉庫衍生出的各個工作樹與子目錄,共用同一個~/.claude/projects/<project>/memory/目錄。 - 真正的「團隊共享記憶」靠 Git 版本控制實現:載體是倉庫根目錄的
./CLAUDE.md(或./.claude/CLAUDE.md)以及模組化的./.claude/rules/*.md。 - 最穩妥的團隊記憶流轉是「個人自動積累 → 人工篩選提煉 → PR 合入倉庫」:平時讓自動記憶接住零散糾偏,每週挑出全組通用的經驗寫進
CLAUDE.md或rules/,避免未經審核的個人習慣污染全組上下文。
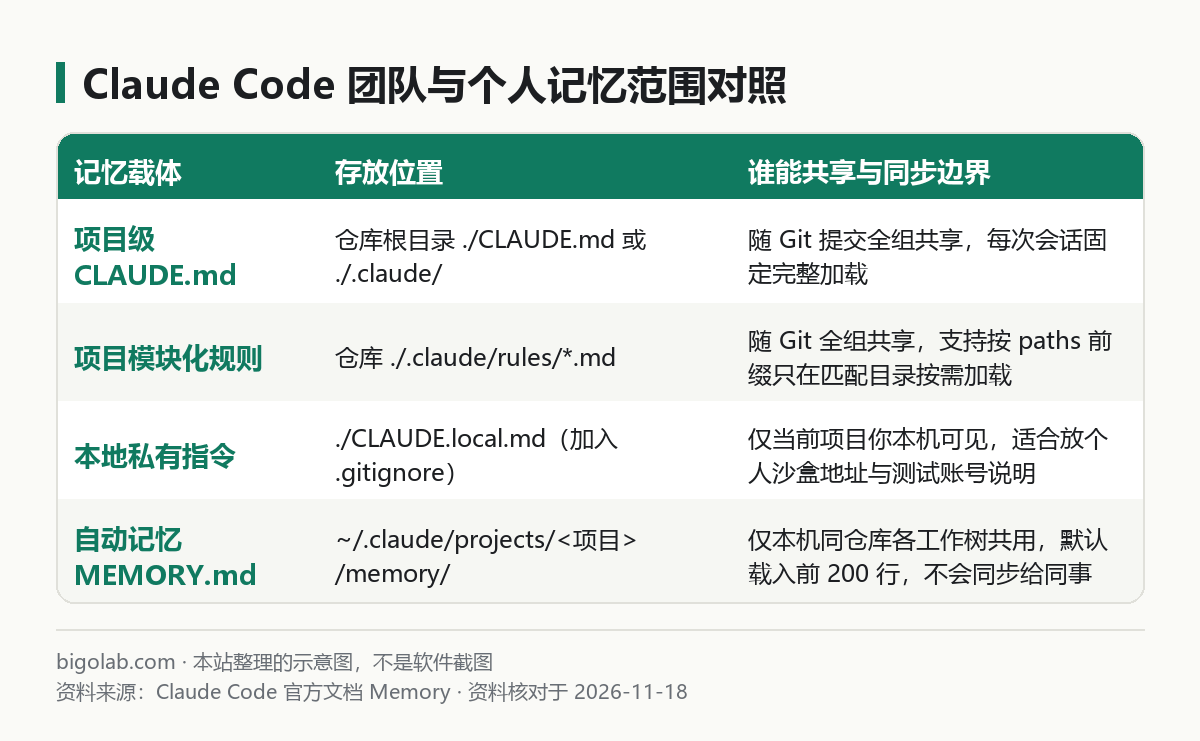
圖:本站根據 Claude Code 官方文檔:How Claude remembers your project 整理的示意圖
本文根據 Claude Code 官方文檔《How Claude remembers your project》整理,核對日期 2026-11-18。配圖為本站整理的示意圖,不是介面截圖。本站(bigolab.com)不是 Anthropic 官方網站。
適用於誰
- 搜「claude code共享記憶」「claude code 團隊記憶怎麼同步」的人;
- 團隊多人維護同一個代碼倉庫,發現自己糾正過的坑同事那邊的 Claude Code 完全不知道的人;
- 同時開多個
git worktree並行開發,想知道記憶文件能不能跨工作樹共用的開發者。
如果你還不清楚 CLAUDE.md 為什麼不會自己改動,可以先看 /guides/claude-md-auto-update-how-to-update;如果你只配個人全局偏好,見 /guides/claude-code-global-claude-md-user-level。本文專門拆解「跨工作樹本機共享」與「跨成員團隊共享」的邊界和落地做法。
一、先分清兩層「共享」:同機跨工作樹 vs 跨成員跨機器
大家搜「共享記憶」通常指兩種完全不同的場景,官方機制對這兩者的處理截然不同:
1. 同一台機器上的多會話 / 多工作樹共享(自動生效)
當你用 claude --worktree 或 git worktree 同時開三四個並行分支改需求時(用法見 /guides/claude-code-worktree),官方明確說明:屬於同一個 Git 倉庫的所有工作樹和子目錄共用同一個自動記憶目錄 ~/.claude/projects/<project>/memory/。
目錄裏有一個主索引 MEMORY.md 和若干按主題拆分的筆記文件。每次新開會話時,Claude Code 自動載入 MEMORY.md 的前 200 行(或前 25KB,以先到為準),其餘主題文件在需要時按需讀取。因此你在 A 分支糾正過一次「本倉庫測試必須帶某個環境變量」,切到同倉庫的 B 工作樹新開會話時,本機的 Claude 依然記得。
2. 團隊成員之間的跨機器共享(必須進 Git)
自動記憶儲存在你的系統用戶主目錄下,不在項目倉庫裏,也不會通過帳號在雲端同步給其他成員。想讓全組所有人的 Claude Code 一拉代碼就擁有相同的項目背景,官方指定的唯一共享通道就是隨代碼提交進 Git 的項目級指令文件。關於團隊權限和插件的配套共享,可一併參考 /guides/claude-code-team-collaboration-shared-config。
二、團隊項目記憶該怎麼組織才不撐爆上下文
如果全組所有人都往根目錄同一個 CLAUDE.md 裏塞經驗,不出一個月文件就會突破幾百行,既拖慢每次啟動消耗的額度,又容易出現前後矛盾的規則。按官方推薦的拆分方式,建議按「全局必讀 + 目錄按需」兩層存放:
- 根目錄
CLAUDE.md(控制在 200 行以內):只放全員每次改代碼都繞不開的硬資訊,例如包管理器與構建測試命令、分層架構紅線、提交前必跑檢查; - **
.claude/rules/.md(按業務域和路徑懶加載)*:把只在特定模組才用得到的記憶拆成獨立文件,並用 YAML 頂部的paths字段限定觸發範圍。
例如前端表單校驗的歷史踩坑,可以寫進 .claude/rules/frontend-forms.md 並提交 Git:
markdown
---
paths:
  - "src/components/forms/**/*.tsx"
---

# 表單組件團隊約定
- 統一使用項目封裝的 `useAppForm` 鉤子,不要直接裸調底層校驗庫
- 異步提交按鈕必須綁定返回的 `isSubmitting` 狀態防止重複點擊
官方說明:不帶 paths 的規則文件會在啟動時同 CLAUDE.md 一起載入;帶了 paths 的文件只有當 Claude 真正讀取或編輯匹配路徑下的文件時才載入上下文,非常適合沉澱大團隊的模組級記憶。
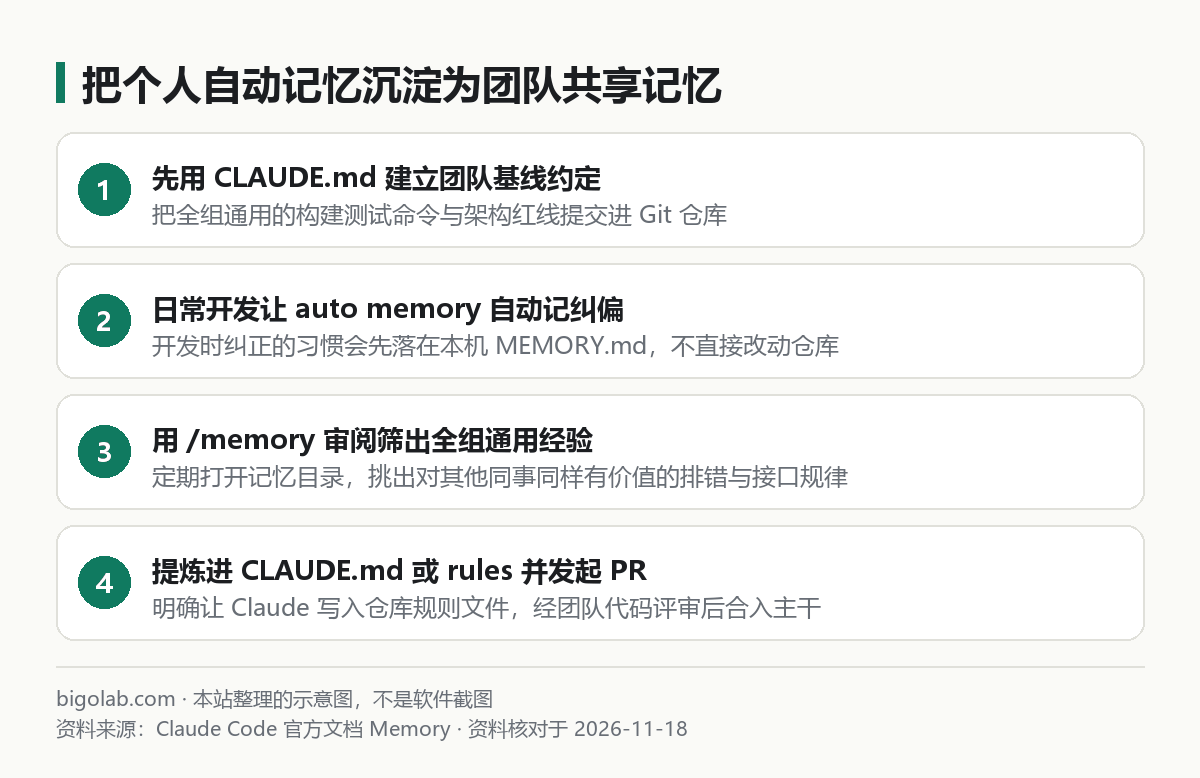
圖:本站根據 Claude Code 官方文檔:How Claude remembers your project 整理的示意圖
三、怎麼把個人 MEMORY.md 裏的好經驗轉成團隊共享記憶
為什麼官方不設計成「所有人的自動記憶直接自動寫進倉庫」?因為自動記憶裏混雜着大量個人偏好(比如某位成員習慣讓模型用英文簡短回答、或者本機臨時連了某個測試端口),直接推給全組反而會互相干擾。
更合理的團隊協作習慣是定期做一次「記憶提煉」:
- 打開
/memory查看本機積累:檢查當前項目自動記憶裏最近記下的feedback(糾偏)和project(項目決策)條目; - 區分個人習慣與項目事實:純個人調試設定留在本機自動記憶或寫進已加入
.gitignore的CLAUDE.local.md;凡是「新同事接手也會踩坑」的構建細節、接口約定,才需要升級為團隊記憶; - 明確指令寫入倉庫文件:在對話裏對 Claude 說「把我自動記憶裏關於數據庫遷移的注意事項整理成兩條精簡規則,加到
.claude/rules/db.md」,提交 Pull Request 讓隊友審閱確認; - 定期跑
/doctor prompt-audit清理過期記憶:代碼重構後舊記憶容易變成誤導資訊,運行該命令可以讓 Claude 掃描倉庫裏的CLAUDE.md與.claude/rules/,找出指向已刪除文件或互相沖突的舊條目報告給你。
團隊日常使用若涉及個人訂閱開通或續費方案對比,也可查看 /chongzhi/claude-code 的官方訂閱層級整理。
常見問題
Q:能用軟連結或同步盤把 ~/.claude/projects/<project>/memory/ 強行全組同步嗎?
不建議這樣做。多人同時在不同機器會話裏觸發自動記憶寫入,極易造成 MEMORY.md 覆蓋衝突,而且會把別人的個人角色設定(user 類筆記)混進你的會話。團隊共享請始終走 Git 倉庫裏的 CLAUDE.md 和 .claude/rules/。
Q:某個項目不想讓 Claude 往本機寫自動記憶,怎麼關掉?
如果全組希望某個敏感倉庫統一關閉自動記憶,可以在項目共享的 .claude/settings.json 裏加上 "autoMemoryEnabled": false,這樣所有拉取該倉庫的成員在該項目下都不會生成本機自動記憶文件。
Q:公司所有倉庫都要遵守同一套安全或合規底線,每個倉庫拷一份 CLAUDE.md 太麻煩怎麼辦?
官方支持組織級(Managed policy)CLAUDE.md,由企業 IT 統一部署到系統級固定路徑(如 macOS 的 /Library/Application Support/ClaudeCode/CLAUDE.md 或 Windows 的 C:\Program Files\ClaudeCode\CLAUDE.md),對機上所有項目自動生效。
相關教學
- /guides/claude-md-auto-update-how-to-update:自動記憶 auto memory 與
CLAUDE.md的區別 - /guides/claude-code-global-claude-md-user-level:全局
~/.claude/CLAUDE.md與各層級範圍詳解 - /guides/claude-code-team-collaboration-shared-config:Claude Code 團隊共享配置與插件管理
- /guides/claude-code-worktree:多工作樹(worktree)並行開發指南
參考資料
- Claude Code 官方文檔:How Claude remembers your project — https://code.claude.com/docs/en/memory
0 條評論
還沒有評論,來搶沙發~