
本文根據 OpenAI 官方《Web search》整理,資料核對於 2026-11-05。配圖為本站整理的示意圖,不是介面截圖。代碼裏的模型名取自官方當天示例,請以官方模型頁為準。本站(bigolab.com)不是 OpenAI 官方網站。API 是按用量計費的獨立服務,與 ChatGPT 訂閱分開計算,Key 的獲取見 /guides/openai-api-key。
適用於誰
- 需要讓模型回答“今天發生了什麼”“最新版本是多少”這類時效問題的開發者;
- 已會用 Responses API 發請求(不熟的先看 /guides/openai-responses-api),想給它加聯網能力的人;
- 想在回答裏顯示來源連結、或限制只在某幾個網站裏搜的人。
結論先說
- 一行就能開:在
tools裏加{"type": "web_search"},不用自己寫搜尋代碼。 - 新接入用
web_search,舊的web_search_preview還能用,但不支持域名過濾等新選項。 - 模型不一定搜:
tool_choice為auto時它自己決定要不要搜,想強制就設required或指定這個工具。 - 回答裏的引用在
annotations,類型是url_citation;官方要求把行內引用以顯眼的可點擊連結展示給用戶。 - 搜尋要額外計費:搜尋動作有工具調用費用,另外還有模型本身的 token 費用,數字以官方價格頁當天為準。
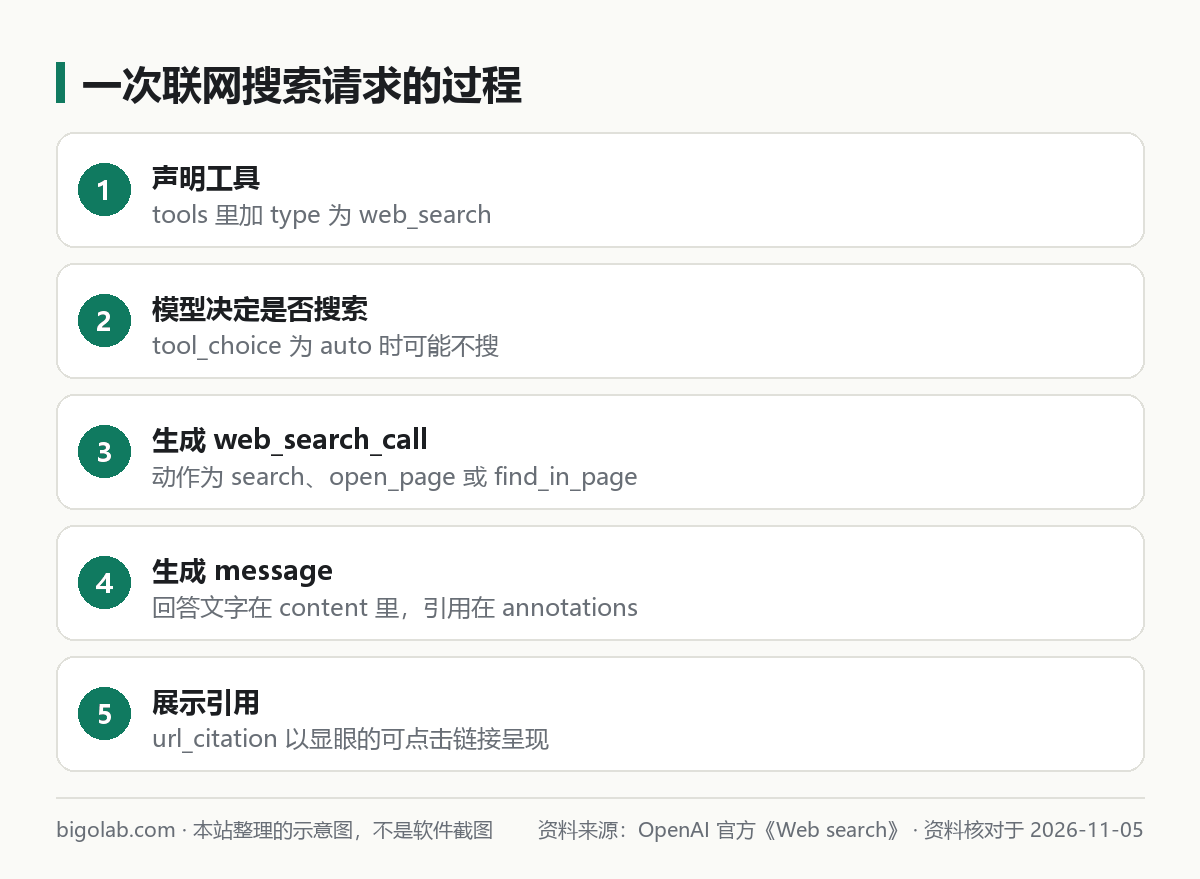
圖:本站根據 OpenAI 官方《Web search》 整理的示意圖
一、最小示例
Python:
python
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="gpt-6-astra",  # 以官方模型頁當天為準
    tools=[{"type": "web_search"}],
    input="今天有什麼積極向上的新聞?",
)

print(response.output_text)
Node.js(儲存為 .mjs):
javascript
import OpenAI from "openai";

const client = new OpenAI();

const response = await client.responses.create({
  model: "gpt-6-astra", // 以官方模型頁當天為準
  tools: [{ type: "web_search" }],
  input: "今天有什麼積極向上的新聞?",
});

console.log(response.output_text);
沒有 Key 或還沒跑通基礎請求的,先看 /guides/openai-api-python-quickstart 或 /guides/openai-api-nodejs-quickstart。
二、響應裏有什麼
一次帶搜尋的響應,output 裏通常有兩類項:
web_search_call:記錄搜尋動作,有id、status和action。action的類型可能是search(帶查詢詞)、open_page(打開某個頁面)或find_in_page(在頁面內查找)。搜尋類動作會產生工具調用費用;message:真正的回答,文字在content[0].text,引用放在content[0].annotations。
每條 url_citation 包含 type、start_index、end_index、url、title。其中 start_index 和 end_index 指出這條引用對應回答文字的哪一段,你可以據此在頁面上做角標或連結。行內引用預設就帶上。官方明確要求:你向用戶展示聯網結果時,行內引用必須以顯眼的、可點擊的連結形式呈現。
三、限制搜尋範圍
域名過濾
用 filters 指定只搜某些網站,或者排除某些網站:
python
tools=[{
    "type": "web_search",
    "filters": {
        "allowed_domains": ["openai.com", "developers.openai.com"],
    },
}]規則:allowed_domains 與 blocked_domains 各自最多 100 個域名;寫域名時不要帶協議,寫 openai.com,不要寫 https://openai.com/;子域名自動包含。這個功能只適用於 Responses API 的 web_search,舊的 web_search_preview 不支持。
用戶位置
問“附近有什麼”這類問題時,可以給個大致位置:
python
tools=[{
    "type": "web_search",
    "user_location": {
        "type": "approximate",
        "country": "US",
        "city": "Minneapolis",
        "region": "Minnesota",
        "timezone": "America/Chicago",
    },
}]
type 固定寫 approximate;country 是兩位 ISO 國家代碼;city、region 是自由文本;timezone 是 IANA 時區名。
四、查看全部來源
回答裏的引用只是模型最終採用的幾條。想看它查過的所有網址,請求裏加:
python
include=["web_search_call.action.sources"]
官方說這個來源列表通常比引用列表更長。實時數據類來源會帶有 oai-sports、oai-weather、oai-finance 這樣的標籤。
五、幾個參數怎麼選
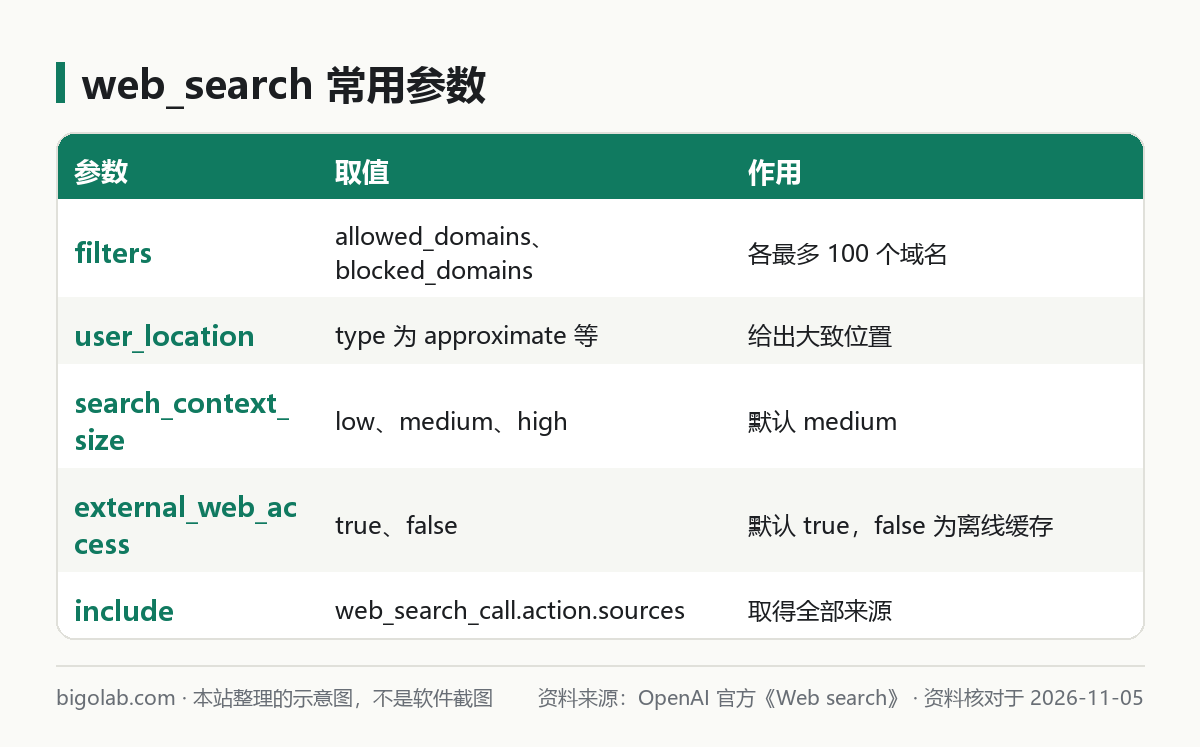
圖:本站根據 OpenAI 官方《Web search》 整理的示意圖
search_context_size:取low、medium(預設)、high,控制給模型多少搜尋上下文。官方特別說明,它不是精確的 token 數,也不保證來源或引用的數量;external_web_access:布爾值,預設true,即實時聯網。設為false是隻用緩存、不訪問外部網絡的離線模式;舊的web_search_preview會忽略這個參數;tool_choice:auto時模型可能直接回答不去搜,要保證搜尋就用required或指定該工具;return_token_budget:只用於託管的web_search與 GPT-5 及以上的推理模型,取值default或unlimited,官方提醒unlimited可能增加延遲和費用,要謹慎,長任務可配合background: true。
六、官方列出的限制
- 聯網搜尋的上下文窗口最多 128k,不管模型本身窗口多大;
- 速率限制沿用底層模型的分級限制,提高限額的辦法見 /guides/openai-api-usage-tiers-rate-limits;
- 官方提醒:
gpt-5.4搭配推理強度none可能得到質素較低的搜尋結果;仍在用gpt-5的,推理強度要高於minimal; - Chat Completions 裏只有
gpt-5-search-api一個搜尋模型,它每次回答前都會先搜,但不支持域名過濾、來源列表、實時訪問控制;官方建議僅為保持舊集成才用; - 安全上,官方建議把公開網頁搜尋和訪問私有數據的 MCP 查詢放在不同請求裏,以降低提示注入的風險;
- 官方頁面還提到一些舊的搜尋預覽模型已經安排下線,如果你的代碼還在用,請到官方頁面核對日期。
常見問題
Q:為什麼有時候明明開了工具,模型沒搜?
tool_choice 預設是 auto,模型認為不需要就不會搜。要強制搜尋,把它設為 required。
Q:能不能讓搜尋結果只來自我信任的網站?
用 filters.allowed_domains,最多 100 個域名。
Q:怎麼在介面上顯示來源?
讀 annotations 裏的 url_citation,用 url 和 title 做連結,並按官方要求讓連結顯眼可點擊。
Q:要不要同時讓回答按固定格式輸出?
可以,格式化輸出見 /guides/openai-api-structured-outputs;讓模型自己調用你寫的函數見 /guides/openai-api-function-calling。
Q:遇到 429 或其他報錯?
按 /guides/openai-api-error-codes 排查。價格見 /guides/openai-api-price-official-table,以官方當天為準。
參考資料
- OpenAI 官方:Web search — https://developers.openai.com/api/docs/guides/tools-web-search
0 條評論
還沒有評論,來搶沙發~