
本文根據 OpenAI 官方《Structured model outputs》整理,資料核對於 2026-11-05。配圖為本站整理的示意圖,不是介面截圖。代碼裏的模型名取自官方當天示例,請以官方模型頁為準。本站(bigolab.com)不是 OpenAI 官方網站。API 是按用量計費的獨立服務,與 ChatGPT 訂閱分開計算,Key 的獲取見 /guides/openai-api-key。
適用於誰
- 要把模型回答直接交給程序處理的開發者:資訊抽取、分類打標、生成表單或介面描述;
- 以前靠提示詞“請只輸出 JSON”、總是偶爾多一句廢話或少一個字段的人;
- 想知道 Structured Outputs 和 JSON 模式有什麼區別的人。
如果你想了解跨廠商的思路(只靠提示詞、JSON 模式、結構化輸出三種做法對比),先看 /guides/llm-json-structured-output-reliable。本文只寫 OpenAI 的具體寫法。
結論先說
- Structured Outputs 保證輸出符合你給的 JSON Schema:不會漏掉必填字段,也不會冒出不存在的枚舉值。JSON 模式只保證是合法 JSON,不保證符合 schema。
- 官方建議能用就用 Structured Outputs,不用 JSON 模式。
- Responses API 裏的寫法:
text.format設成type: "json_schema",並設strict: true。 - 有現成輔助方法:Python 用 Pydantic 加
responses.parse,Node 用 Zod 加responses.parse,結果在output_parsed。 - 仍然要處理兩種意外:模型拒絕回答(refusal),以及輸出被 token 上限截斷(incomplete)。這兩種情況輸出不一定符合 schema。
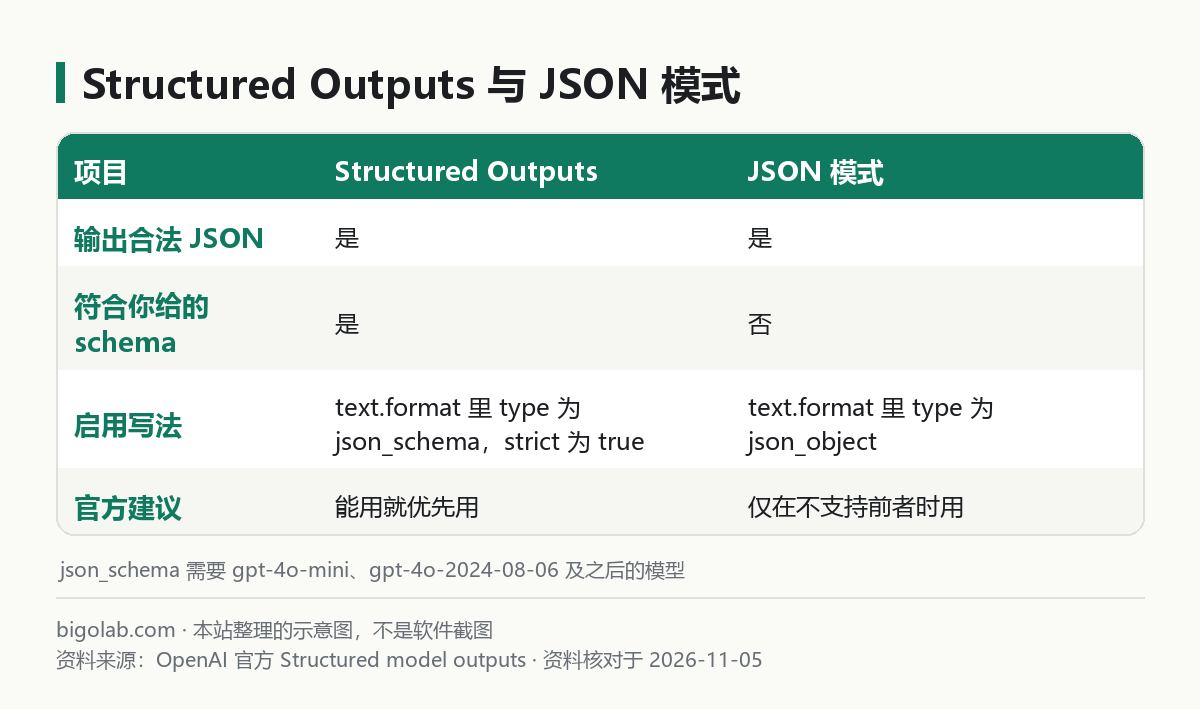
圖:本站根據 OpenAI 官方《Structured model outputs》 整理的示意圖
一、和函數調用怎麼選
官方說 Structured Outputs 有兩種形式:一是用在函數調用上,二是用 json_schema 響應格式。區分很簡單:
- 模型要連接你的工具、函數、數據:用函數調用,見 /guides/openai-api-function-calling;
- 你想規定模型回答用戶時的結構:用
text.format,比如數學輔導應用想讓答案分成“步驟”和“最終答案”,好在介面上分別展示。
二、最省事的寫法:Pydantic 和 Zod
Python(需要先 pip install openai pydantic)。下面按官方“抽取日程”例子改寫:
python
from openai import OpenAI
from pydantic import BaseModel

client = OpenAI()

class CalendarEvent(BaseModel):
    name: str
    date: str
    participants: list[str]

response = client.responses.parse(
    model="gpt-6-astra",  # 以官方模型頁當天為準
    input=[
        {"role": "system", "content": "從用戶的話裏提取日程資訊。"},
        {"role": "user", "content": "小明和小紅週五要去參加科學展。"},
    ],
    text_format=CalendarEvent,
)

event = response.output_parsed
print(event.name, event.date, event.participants)
Node.js(需要 npm install openai zod,儲存為 .mjs 運行):
javascript
import OpenAI from "openai";
import { zodTextFormat } from "openai/helpers/zod";
import { z } from "zod";

const openai = new OpenAI();

const CalendarEvent = z.object({
  name: z.string(),
  date: z.string(),
  participants: z.array(z.string()),
});

const response = await openai.responses.parse({
  model: "gpt-6-astra", // 以官方模型頁當天為準
  input: [
    { role: "system", content: "從用戶的話裏提取日程資訊。" },
    { role: "user", content: "小明和小紅週五要去參加科學展。" },
  ],
  text: {
    format: zodTextFormat(CalendarEvent, "event"),
  },
});

console.log(response.output_parsed);
官方推薦盡量用 SDK 的這類輔助方法,理由是避免“JSON schema 和代碼裏的類型逐漸不一致”。如果你堅持手寫 schema,官方建議在 CI 裏加規則:只要 schema 或對應的數據類被改了就報警,或者讓 CI 從類型定義自動生成 schema。
三、自己寫 JSON Schema
不用輔助方法時,直接在 text.format 裏寫。下面是官方“數學輔導”例子的 Python 結構:
python
response = client.responses.create(
    model="gpt-6-astra",  # 以官方模型頁當天為準
    input=[
        {"role": "system", "content": "你是數學老師,一步一步引導用戶解題。"},
        {"role": "user", "content": "8x + 7 = -23 怎麼解?"},
    ],
    text={
        "format": {
            "type": "json_schema",
            "name": "math_response",
            "strict": True,
            "schema": {
                "type": "object",
                "properties": {
                    "steps": {
                        "type": "array",
                        "items": {
                            "type": "object",
                            "properties": {
                                "explanation": {"type": "string"},
                                "output": {"type": "string"},
                            },
                            "required": ["explanation", "output"],
                            "additionalProperties": False,
                        },
                    },
                    "final_answer": {"type": "string"},
                },
                "required": ["steps", "final_answer"],
                "additionalProperties": False,
            },
        },
    },
)

print(response.output_text)
注意 JSON 文本在 output_text 裏,是字符串,需要自己 json.loads。官方還說:第一次使用某個 schema 會有額外延遲,之後相同 schema 的請求沒有額外延遲。
官方給 schema 的三條建議:鍵名起得清楚直觀;給重要的鍵寫清楚標題和描述;用評測(evals)來決定哪種結構最適合你的場景。
四、schema 的限制
官方說 Structured Outputs 只支持 JSON Schema 的一個子集,要點:
- 支持的類型:字符串、數字、布爾、整數、對象、數組、枚舉、
anyOf; - 根必須是對象,且不能是
anyOf。官方特別提醒,用 Zod 的判別聯合(discriminated union)會在頂層產生anyOf,這樣寫不行; - 所有字段必須
required。想表示可選,把類型寫成["string", "null"]這樣的聯合,模型會對每個字段都給值,沒有就給null; - 每個對象必須
additionalProperties: false; - 規模上限:最多 5000 個對象屬性、最多 10 層嵌套;所有屬性名、定義名、枚舉值的字符總長不超過 120,000;枚舉值總數最多 1000;
- 不支持的關鍵字:
allOf、not、dependentRequired、dependentSchemas、if、then、else; - 輸出裏的鍵順序和 schema 裏的順序一致;
- 支持
$defs定義和遞歸 schema。
如果開了 strict: true 卻傳了不支持的 schema,你會收到錯誤。字符串還能用 pattern 和部分 format(例如 email、date-time、uuid),數字能用 minimum、maximum 等,數組能用 minItems、maxItems,但官方說這些約束對微調模型暫不支持。
五、兩種邊界情況必須處理
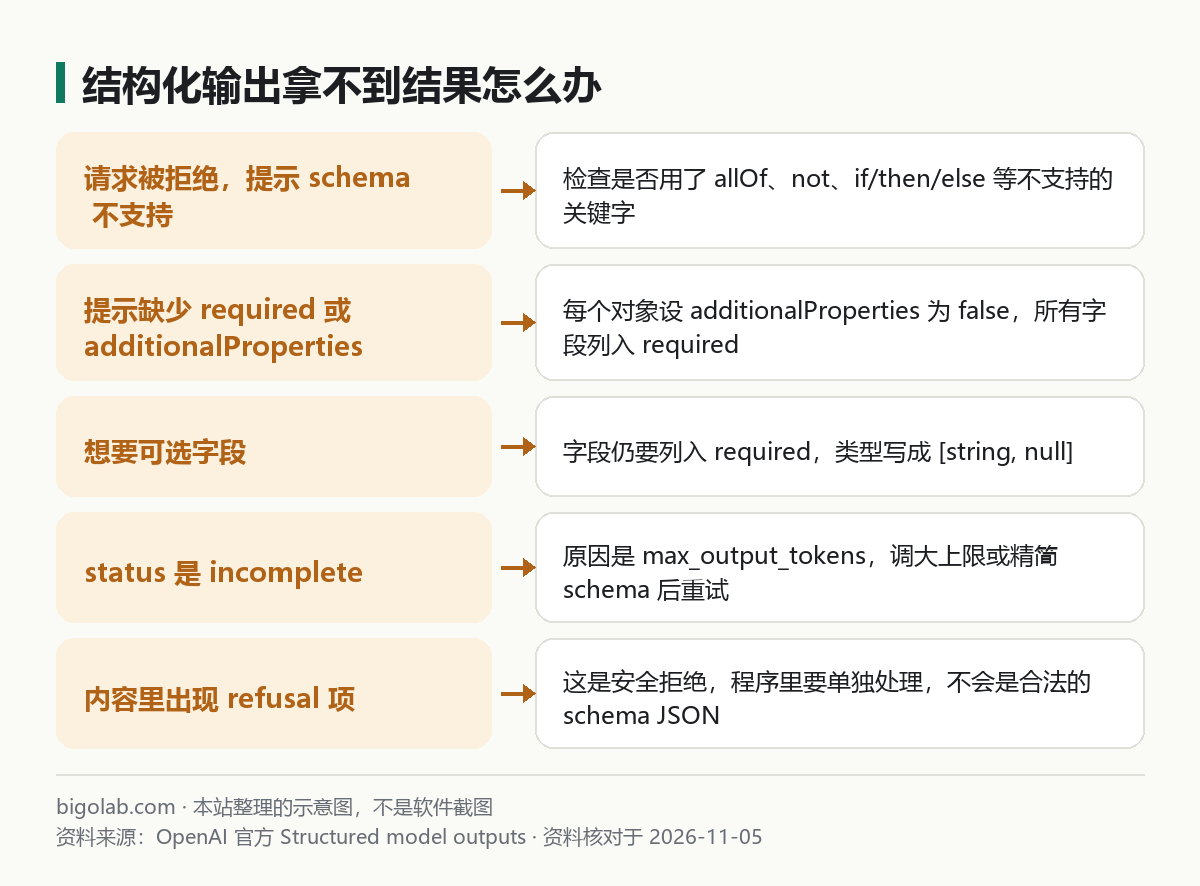
圖:本站根據 OpenAI 官方《Structured model outputs》 整理的示意圖,處理辦法一欄為本站補充
官方強調:模型有時不會生成符合 schema 的有效響應,原因有兩個:拒絕和不完整。官方示例的判斷結構,改寫成 Python 如下:
python
response = client.responses.create(
    model="gpt-6-astra",  # 以官方模型頁當天為準
    input=[{"role": "user", "content": "8x + 7 = -23 怎麼解?"}],
    max_output_tokens=1024,
    text={"format": {"type": "json_schema", "name": "math_response",
                     "strict": True, "schema": schema}},  # schema 同上
)

if (response.status == "incomplete"
        and response.incomplete_details.reason == "max_output_tokens"):
    raise RuntimeError("輸出被截斷,結果不完整")

message = next(i for i in response.output if i.type == "message")
part = message.content[0]
if part.type == "refusal":
    print("模型拒絕:", part.refusal)
elif part.type == "output_text":
print(part.text)- 達到
max_output_tokens時,status是incomplete,JSON 可能是半截的; - 安全拒絕時,內容項的
type是refusal而不是output_text,官方把它稱為“可以用程序檢測的拒絕”。
另外官方還提醒兩件事:一是用戶輸入與 schema 完全不相關時,模型仍會努力湊出符合 schema 的內容,可能編造,所以提示詞裏要寫明“輸入不適用時返回空值或一句固定話”;二是 Structured Outputs 仍然可能出錯,內容錯了就調整指令、在系統指令裏加示例,或把任務拆成更簡單的子任務。
常見問題
Q:必須用 gpt-6-astra 嗎?
不是。官方說 Structured Outputs 在 gpt-4o 起的最新模型上可用,新項目建議從當天官方推薦的模型起步;json_schema 格式需要 gpt-4o-mini、gpt-4o-2024-08-06 及之後的快照。
Q:可以和流式一起用嗎?
可以。官方頁面有 SDK 的 stream 方法示例,會收到文字增量和拒絕增量事件,基礎流式寫法見 /guides/openai-api-streaming。
Q:它會讓請求更貴嗎?
官方這一頁沒有寫額外費用,價格以官方價格頁當天為準,見 /guides/openai-api-price-official-table。schema 本身會佔輸入 token 這一點,是本站的推斷,實際用量請看帳單。
Q:第一個請求很慢?
正常,官方說明首次使用新 schema 需要處理時間。
參考資料
- OpenAI 官方:Structured model outputs — https://developers.openai.com/api/docs/guides/structured-outputs
0 條評論
還沒有評論,來搶沙發~