
本文根據 OpenAI 官方《File inputs》整理,資料核對於 2026-11-05。配圖為本站整理的示意圖,不是介面截圖。代碼裏的模型名取自官方當天示例,請以官方模型頁為準。本站(bigolab.com)不是 OpenAI 官方網站。API 是按用量計費的獨立服務,與 ChatGPT 訂閱分開計算,Key 的獲取見 /guides/openai-api-key。
適用於誰
- 想讓模型總結合同、論文、報表、說明書等文件的開發者;
- 已經跑通第一個請求(見 /guides/openai-api-python-quickstart),但沒傳過文件的人;
- 只會傳圖片、不知道文件怎麼傳的人,圖片的寫法見 /guides/openai-api-image-input。
結論先說
- 文件用
input_file這種輸入項傳,放在content數組裏,和input_text並排。 - 三種傳法:已經上載到 Files API 的
file_id、公開網址file_url、base64 的file_data(要配filename)。 - 用於模型輸入的上載,purpose 填
user_data。 - 單個文件須小於 50 MB,同一請求裏所有文件合計不超過 50 MB。
- PDF 會同時送文字和頁面圖像,所以 token 用量會比純文本高;文件很多、很大時,官方建議改用文件搜尋,而不是整份塞進請求。
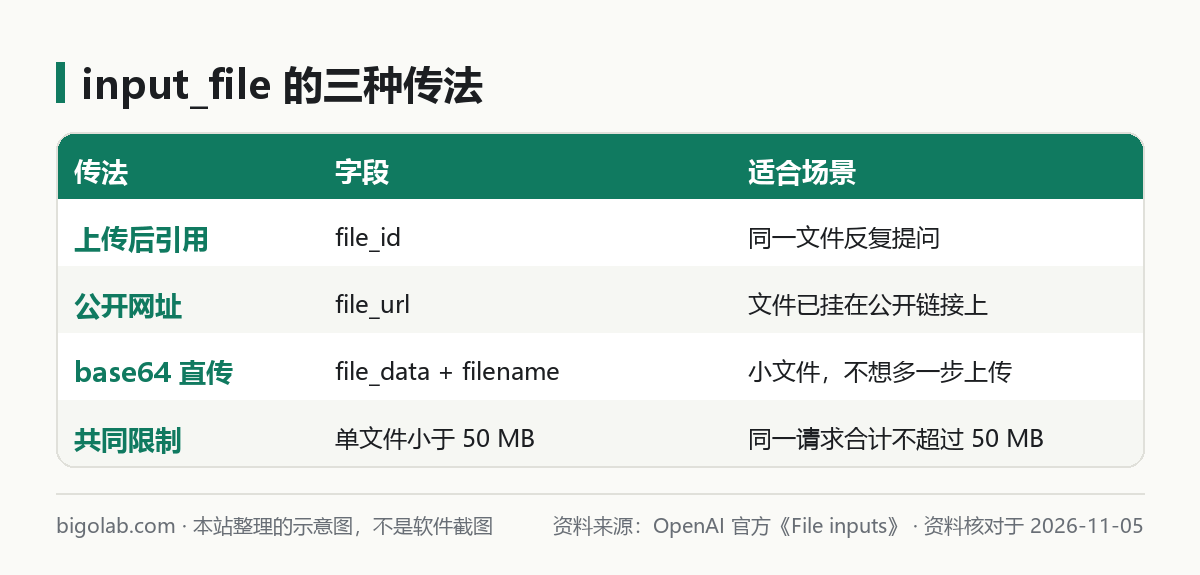
圖:本站根據 OpenAI 官方《File inputs》 整理的示意圖
一、三種傳法對比
官方的對照表可以概括成這樣:
| 傳法 | 字段 | Responses API | Chat Completions |
|---|---|---|---|
| base64 數據 | file_data + filename | 支持各類文件 | 只支持 PDF |
| 已上載的文件 ID | file_id | 支持各類文件 | 只支持 PDF |
| 外部網址 | file_url | 支持各類文件 | 不支持 |
官方的原話意思是:非 PDF 文件的輸入請用 Responses API。如果你一定要在 Chat Completions 裏讀非 PDF 文件的文字,辦法是在自己的程序裏先把內容讀出來,作為 text 內容部件發過去。
三個字段的含義:
file_id:用 Files API 上載後拿到的文件編號;file_url:公開可訪問的文件網址,伺服器能直接拉取;file_data:base64 編碼的文件內容,格式是 data URI,例如data:application/pdf;base64,...,同時要寫filename,例如document.pdf。
二、方式一:先上載,再用 file_id
上載時 purpose 填 user_data。官方說其他受支持的 purpose 也能用,但這個是專門給“當作模型輸入”的文件準備的。
python
from openai import OpenAI

client = OpenAI()

# 1. 上載
uploaded = client.files.create(
    file=open("report.pdf", "rb"),
    purpose="user_data",
)

# 2. 在請求裏引用
response = client.responses.create(
    model="gpt-6-astra",  # 以官方模型頁當天為準
    input=[
        {
            "role": "user",
            "content": [
                {"type": "input_file", "file_id": uploaded.id},
                {"type": "input_text", "text": "請用五句話總結這份文件。"},
            ],
        }
    ],
)
print(response.output_text)
同一份文件要問很多次時,先上載再用 file_id 最省事:不用每次都把整個文件編碼、傳輸一遍。
三、方式二:base64 直接帶上
文件很小、不想多一次上載,可以直接把內容編碼放進請求。別忘了 filename。
python
import base64
from openai import OpenAI

client = OpenAI()

with open("report.pdf", "rb") as f:
    b64 = base64.b64encode(f.read()).decode("utf-8")

response = client.responses.create(
    model="gpt-6-astra",
    input=[
        {
            "role": "user",
            "content": [
                {
                    "type": "input_file",
                    "filename": "report.pdf",
                    "file_data": f"data:application/pdf;base64,{b64}",
                },
                {"type": "input_text", "text": "這份報告的三個主要結論是什麼?"},
            ],
        }
    ],
)
print(response.output_text)
base64 會讓請求體變大,所以要留意前面說的 50 MB 總量限制。
四、方式三:給公開網址 file_url
文件本來就掛在公開網址上,最簡單。下面是 Node.js 寫法,儲存為 .mjs 運行:
javascript
import OpenAI from "openai";

const client = new OpenAI();

const response = await client.responses.create({
  model: "gpt-6-astra", // 以官方模型頁當天為準
  input: [
    {
      role: "user",
      content: [
        { type: "input_file", file_url: "https://example.com/report.pdf" },
        { type: "input_text", text: "請列出這份文件裏的所有日期和金額。" },
      ],
    },
  ],
});
console.log(response.output_text);
網址必須是伺服器能訪問到的公開地址。需要登入才能打開的連結,模型拉不到,這種情況請改用上載。Node 裏上載文件的寫法是 openai.files.create({ file: fs.createReadStream("report.pdf"), purpose: "user_data" }),Node SDK 的基礎用法見 /guides/openai-api-nodejs-quickstart。
五、不同文件,模型實際“看到”什麼
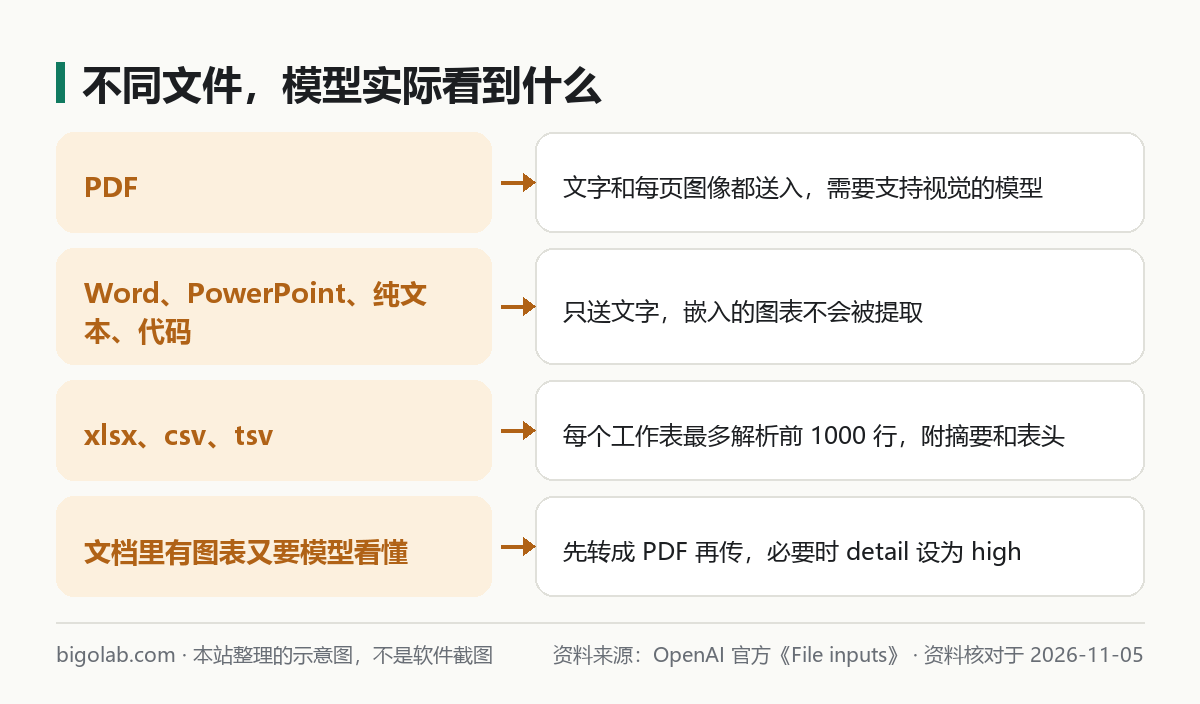
圖:本站根據 OpenAI 官方《File inputs》 整理的示意圖
官方按類型說明了處理方式:
- PDF:文字和每頁的圖像都會送給模型,所以需要支持視覺的模型(官方舉例
gpt-4o及之後的模型); - Word、PowerPoint、純文本、代碼文件等:只送文字,文件裏嵌入的圖片和圖表不會被提取;
- 表格(xlsx、csv、tsv):每個工作表最多解析前 1000 行,並附上模型生成的摘要和表頭資訊。
兩個實用推論:
- 文檔裏有圖表、示意圖而你需要模型看懂,先轉成 PDF 再傳;
- 表格行數很多、要做關聯、彙總、畫圖,官方的建議是用託管 shell 做複雜處理,而不是靠這種輸入方式。
六、detail 參數:控制 PDF 頁面圖像的精細程度
detail 是可選的,隻影響 PDF 頁面圖像,取值 auto、low、high,預設 auto:
low:用更少的輸入 token;high:給密集圖表、小字、示意圖更多細節;auto:官方寫的是在 GPT-5.6 及更新模型上按high,更早的模型按low。
detail 不改變提取出來的文字,文字總是會送入。Chat Completions 不支持這個參數。
七、費用和選擇
PDF 的文字和頁面圖像都進上下文,token 用量會上升。官方的提醒是上線前先看價格和 token 影響。價格以官方價格頁當天為準,參見 /guides/openai-api-price-official-table,粗估辦法見 /guides/openai-api-token-count-estimate。
如果你有一大堆文檔要反覆查詢,整份塞進每個請求既貴又慢。官方在這裏的建議是改用文件搜尋(File Search):先把文檔放進向量庫,由檢索挑出相關片段。這個工具本文不展開。
常見問題
Q:為什麼提示文件太大?
單個文件須小於 50 MB,同一請求內合計不超過 50 MB。拆成幾個請求,或者拆分文件。具體報錯訊息官方頁面沒有逐條列出,錯誤碼的整體排查見 /guides/openai-api-error-codes。
Q:Chat Completions 能傳 Word 文件嗎?
官方表格裏它只支持 PDF。其他類型請用 Responses API,或者自己讀出文字再發。
Q:模型沒看到文檔裏的圖表?
非 PDF 文檔只送文字。先轉成 PDF 再傳,並考慮把 detail 設為 high。
Q:想讓模型邊讀邊流式輸出?
文件輸入和流式可以搭配,流式的寫法見 /guides/openai-api-streaming。
參考資料
- OpenAI 官方:File inputs — https://developers.openai.com/api/docs/guides/file-inputs
0 條評論
還沒有評論,來搶沙發~