
结论先说
- 绝不让 Codex 直接连生产库写并跑脚本,先把「表结构 DDL + 清洗规则 + 脱敏样本」整理成输入契约。敏感数据库连接串必须通过环境策略与权限档案隔离(配置参考 /guides/codex-permission-profiles-block-env-config 与 /guides/codex-shell-environment-policy-filter-secrets),在本地或隔离测试库完成全部验证。
- 合格的数据迁移脚本必须同时具备三道保命机制:干跑模式(
--dry-run)、SQL 级幂等写入与游标断点续跑。干跑负责提前暴露异常行与受影响行数;幂等保证重跑不会翻倍插数;断点续跑让百万级任务中断后从上一批成功位置接着跑。 - 分批拉取一律用主键游标(
WHERE id > last_id ORDER BY id LIMIT N),禁用OFFSET深分页。深分页越往后越慢,且在边迁移边写入的场景下容易漏行或重复扫描;每批控制在 500–2000 行并在单批事务内提交,既稳内存又不长时间锁表。 - 把「异常脏数据分流到死信文件(Dead-Letter)」写进提示词。遇到非法手机号、坏 JSON 或缺失外键时,记录主键与失败原因后继续推进或按阈值中止,绝不静默丢弃数据,也不要因为 1 条坏记录让 50 万行任务反复回滚。
- 在反复迭代清洗规则、补全边界单测并审阅迁移 SQL 差异时,上下文消耗会明显抬升。国内缺少外币卡的开发者可在本站自助开通 ChatGPT Plus 充值 或无 5 小时限额的 ChatGPT Pro 充值,多人数据研发团队可咨询 ChatGPT Business 团队定制。
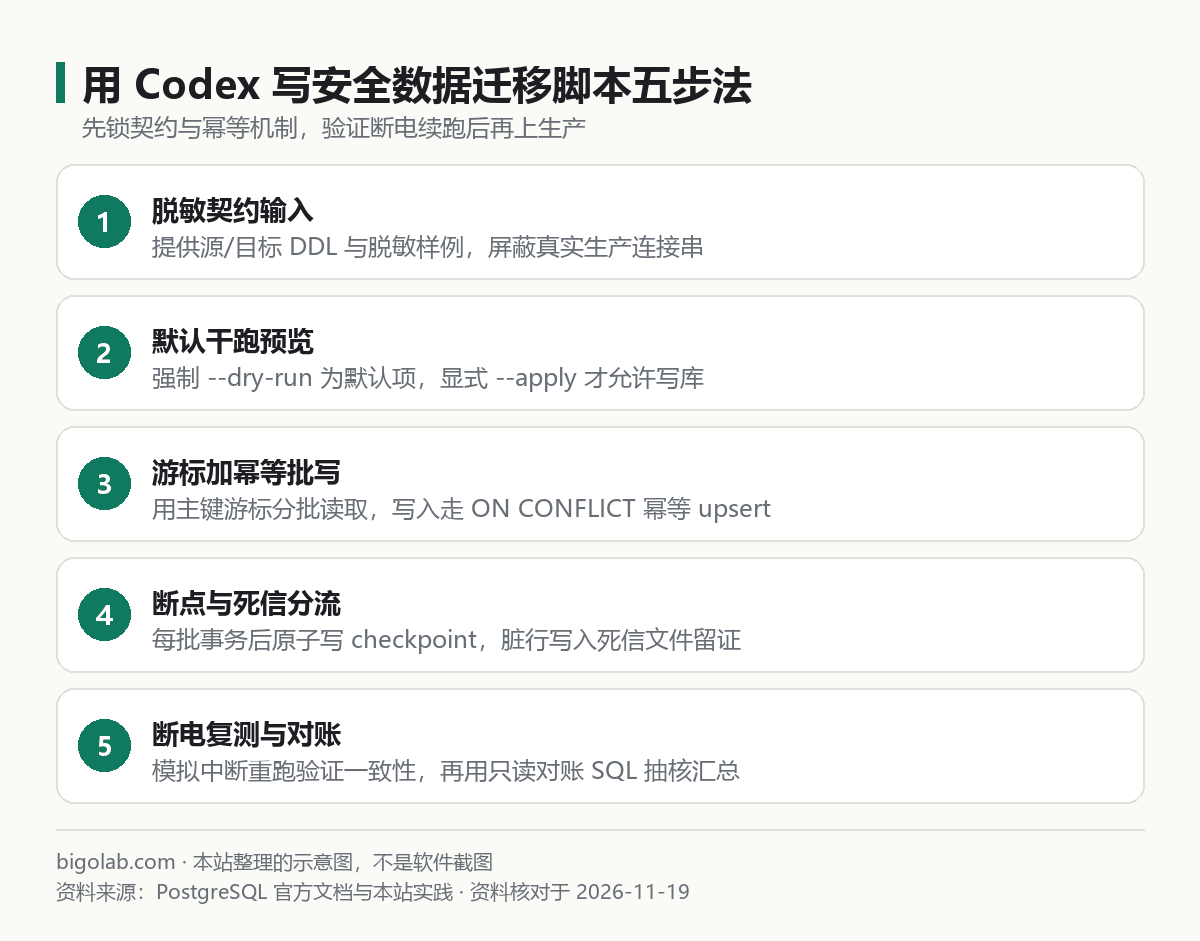
图:本站结合数据迁移工程实践与 PostgreSQL 事务机制整理的流程图
本文根据 OpenAI Codex 官方文档《Codex CLI》《Non-interactive mode》及 PostgreSQL 官方文档《INSERT》《Transactions》整理,资料核对于 2026-11-19。配图为本站整理的示意图,不是界面截图。本站(bigolab.com)不是 OpenAI 官方网站。
适用于谁
- 需要编写一次性或周期性历史数据迁移、字段拆表、脏数据清洗脚本的后端工程师与数据研发;
- 曾让 AI 写出「一把
SELECT *全拉进内存、循环INSERT没加事务与去重」的脚本,跑一半中断后不敢重跑的开发者; - 希望在执行高风险库表变更前,先用脱敏样本做干跑预览和核对报告的技术负责人。
一、先定安全契约:给 Codex 的高可靠脚本生成提示词
直接说「帮我写个 Python 脚本把旧订单表洗到新表」,Codex 往往只会给你一份最简循环演示代码。本站建议先导出源表与目标表的精简 DDL(不含生产数据)和 5 条脱敏样例,用下面这份结构化提示词一次性把架构立稳:
text
请基于 schema/source_orders.sql 和 schema/target_orders.sql 编写一个 Python 数据迁移与清洗脚本 scripts/migrate_orders.py,严格满足以下工程要求:
1. 命令行参数:支持 --dry-run(默认开启,必须显式传 --apply 才真实落库)、--batch-size(默认 1000)、--checkpoint-file、--dead-letter-file、--sleep-ms(批次间隔防打满数据库 IOPS);
2. 分批与断点续跑:按主键自增游标 `WHERE id > %s ORDER BY id ASC LIMIT %s` 读取,禁止使用 OFFSET;每批事务提交成功后,原子写入(临时文件 + rename)checkpoint JSON(记录 last_id、已处理数、跳过数、失败数);
3. 幂等写入:目标库写入必须采用参数化批量 UPSERT(PostgreSQL 用 INSERT ... ON CONFLICT (legacy_order_id) DO UPDATE SET ...,或 MySQL ON DUPLICATE KEY UPDATE),确保同一批次重复执行结果完全一致;
4. 脏数据与重试:清洗函数纯函数化,无法解析的行写入 dead-letter CSV(含原 id 与错误原因);仅对可恢复的网络抖动或死锁错误做指数退避重试(最多 3 次);
5. 干跑校验报告:--dry-run 模式下不提交写事务,输出预计新增/更新行数、清洗规则命中统计与前 10 条异常样本摘要。
同时编写对应的单元测试,覆盖「中途异常中断后重跑续接」「同批次重复运行幂等性」和「脏数据分流」。
核心 SQL 幂等与游标写法核对点
Codex 生成代码后,人工重点核对以下两段核心 SQL 是否写对(不要只看代码能跑):
sql
-- 1. 键集游标分页(稳定且走主键索引,绝不用 OFFSET)
SELECT id, raw_phone, payload_json, updated_at
FROM legacy_orders
WHERE id > %(last_id)s
ORDER BY id ASC
LIMIT %(batch_size)s;

-- 2. PostgreSQL 幂等批写(确保重跑不产生重复记录)
INSERT INTO orders_v2 (legacy_order_id, normalized_phone, amount_cents, migrated_at)
VALUES (%s, %s, %s, NOW())
ON CONFLICT (legacy_order_id) DO UPDATE
SET normalized_phone = EXCLUDED.normalized_phone,
    amount_cents = EXCLUDED.amount_cents,
    migrated_at = EXCLUDED.migrated_at
WHERE orders_v2.normalized_phone IS DISTINCT FROM EXCLUDED.normalized_phone
   OR orders_v2.amount_cents IS DISTINCT FROM EXCLUDED.amount_cents;
注意 ON CONFLICT ... DO UPDATE 末尾加上 WHERE ... IS DISTINCT FROM ... 后,重跑已完全对齐的行时数据库不会产生无意义的死元组与额外 WAL 膨胀,对大表非常友好。
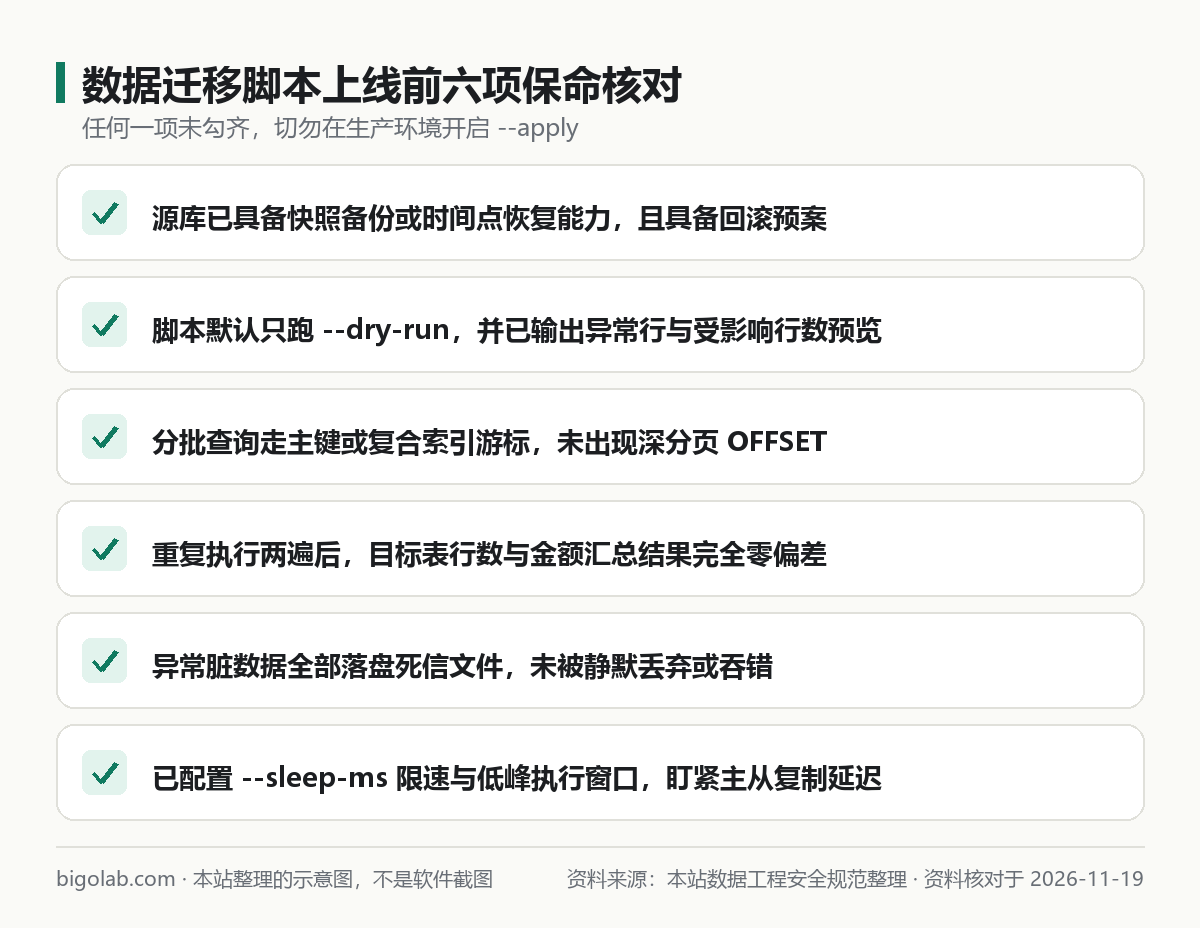
图:本站结合数据库变更安全规范整理的上线前核对示意图
订阅与账号准备提示:处理多表联查迁移、复杂字段映射与全套异常回归测试时,经常需要多轮生成与只读审计(配额规则见 /guides/codex-usage-limits)。高频做数据治理的研发人员可在站内升级 ChatGPT Pro 5x iOS 可覆盖档 或 ChatGPT Pro 5x 信用卡不可覆盖档;新账号首次开通 Codex 如在手机验证步骤受阻,可查看 Codex 注册手机验证服务。
二、先测再跑:让 Codex 补齐「模拟断电重跑」与核对 SQL
写完脚本后,不要只在 3 条正常样例上跑通就上线。让 Codex 基于本地 SQLite 或隔离 PostgreSQL 测试容器补三类关键校验(测试防偷懒原则见 /guides/codex-generate-unit-tests-playwright-e2e-avoid-fake-mocks):
- 断电续跑测试:人为在第 2 批中间抛一次连接异常,确认 checkpoint 仍停在第 1 批末尾;移除异常后重跑,验证最终目标表总行数与无中断跑完完全一致。
- 双跑幂等测试:把全量迁移脚本连续执行两遍,断言目标表行数、关键金额汇总(
SUM(amount_cents))与哈希摘要在两遍之间零变化。 - 迁移后对账 SQL(Reconciliation):让 Codex 同步生成一段只读对账脚本,自动比对源表与目标表的「总行数 − 死信行数」、关键指标加总(金额/积分)以及随机抽样 100 条记录的逐字段差异。
若需要把数据核对脚本挂进定时或预发流水线,务必采用只读与无痕方式调用 codex exec --ephemeral --sandbox read-only 审阅对账报告(流水线规范参考 /guides/codex-exec-full-auto-ephemeral-ci-pipeline-guide)。
常见问题
问:源表没有单调自增整数主键,用的是 UUID 主键怎么办?
答:千万不要直接对随机 UUID 做普通分页后期待按时间增量。可以让 Codex 改成基于 (created_at, id) 复合键集游标分页(如 WHERE (created_at, id) > (%s, %s) ORDER BY created_at, id LIMIT %s),并提前在测试库核实源表是否存在对应的复合索引。
问:干跑校验通过了,在生产环境真正跑几百万行数据时还需要注意什么?
答:先做库表备份或确认时间点恢复(PITR)可用;其次用小批次加 --sleep-ms 限速,避开业务高峰并盯紧主从复制延迟(Replication Lag)与连接池水位;最后务必先在生产只抽前 1000 行试跑对账,确认无误再放开全量。
问:国内没有外币信用卡,或者公司研发团队需要开增值税发票报销,怎么开通适合写工程脚本的 Codex 订阅?
答:可通过本站 AI 会员充值总览 按需选购 ChatGPT Plus 充值、ChatGPT Plus 自助卡密 或更高配额的 ChatGPT Pro 充值,支持支付宝、微信支付及 AlipayHK,提供卡密自助兑换(无需交出账号密码)与客服协助,并支持开具增值税发票;多人团队也可咨询 Business 团队定制方案。实时价格以商品页展示为准,售后执行掉订阅按剩余天数折退、封号不在质保范围规则。
相关教程
- 用 Codex 生成单元测试与 Playwright E2E:避免虚假 Mock 指南
- Codex 权限档案防读 .env 与敏感配置文件实战
- Codex shell_environment_policy 过滤敏感环境变量防泄密指南
- Codex codex exec --full-auto 迁移与 --ephemeral 无痕 CI 流水线指南
- Codex 额度与使用限制:Plus / Pro 能用多少与怎么查
参考资料
- OpenAI Codex 官方文档:Codex CLI — https://learn.chatgpt.com/docs/codex/cli
- OpenAI Codex 官方文档:Non-interactive mode — https://learn.chatgpt.com/docs/non-interactive-mode
- PostgreSQL 官方文档:INSERT(ON CONFLICT 幂等写入)— https://www.postgresql.org/docs/current/sql-insert.html
- PostgreSQL 官方文档:Transactions — https://www.postgresql.org/docs/current/tutorial-transactions.html
0 条评论
还没有评论,来抢沙发~