
照着 Browser Use 入门安装与首个浏览器智能体教程 跑通演示脚本后,很多研发团队想拿它自动巡检自家测试环境后台、批量导出 SaaS 报表或验证前端下单链路。
但从玩具 Demo 迈向真实生产脚本,横在面前的有三道硬门槛:第一,绝对不能把测试账号的真实密码明文塞进 task 字符串发给云端大模型;第二,抓完网页数据怎么无缝回调你本地的 Python 入库函数或拿回干净的 JSON 对象;第三,万一网页弹窗遮挡,怎么防止智能体原地死磕三十步把 Token 烧光。下面用一套完整的加固代码逐个击破。
AI 全栈开发订阅配套入口:在本地部署与联调开源 AI 框架时,搭配固定月费的终端编程智能体与旗舰推理订阅能大幅缩短排错时间。国内无境外信用卡可在本站通过支付宝、微信支付或 AlipayHK 免密自助开通 Claude Code 订阅、ChatGPT Plus / Pro 或查看 AI 会员充值总览。
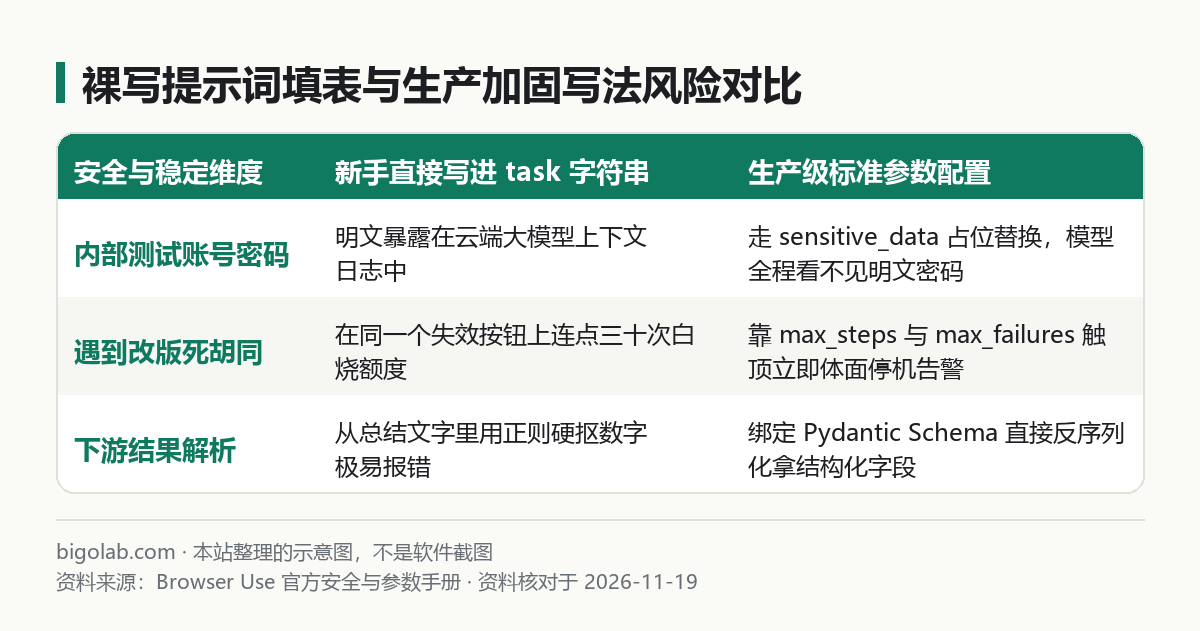
一、sensitive_data:让云端大模型全程看不见真实密码
新手最容易犯的安全事故,就是直接写 task="打开后台输入账号 admin、密码 P@ssw0rd123 登录"——这样你的明文密码会随着每一轮提示词被完整发往外部模型接口。
Browser Use 原生提供了 sensitive_data(敏感数据本地映射字典):你只需在提示词里写占位变量名(如 x_user、x_pass),云端模型推理时只看到占位符并输出“往密码框填入 <secret>x_pass</secret>”,直到最后一步由你本机运行的代码在本地内存里替换成真实密码敲进输入框,配合 use_vision=False(登录页填表阶段可关掉截图上传防密码框回显外泄)安全度拉满。
二、完整加固代码:脱敏填表 + @tools.action 自定义动作 + 强类型输出
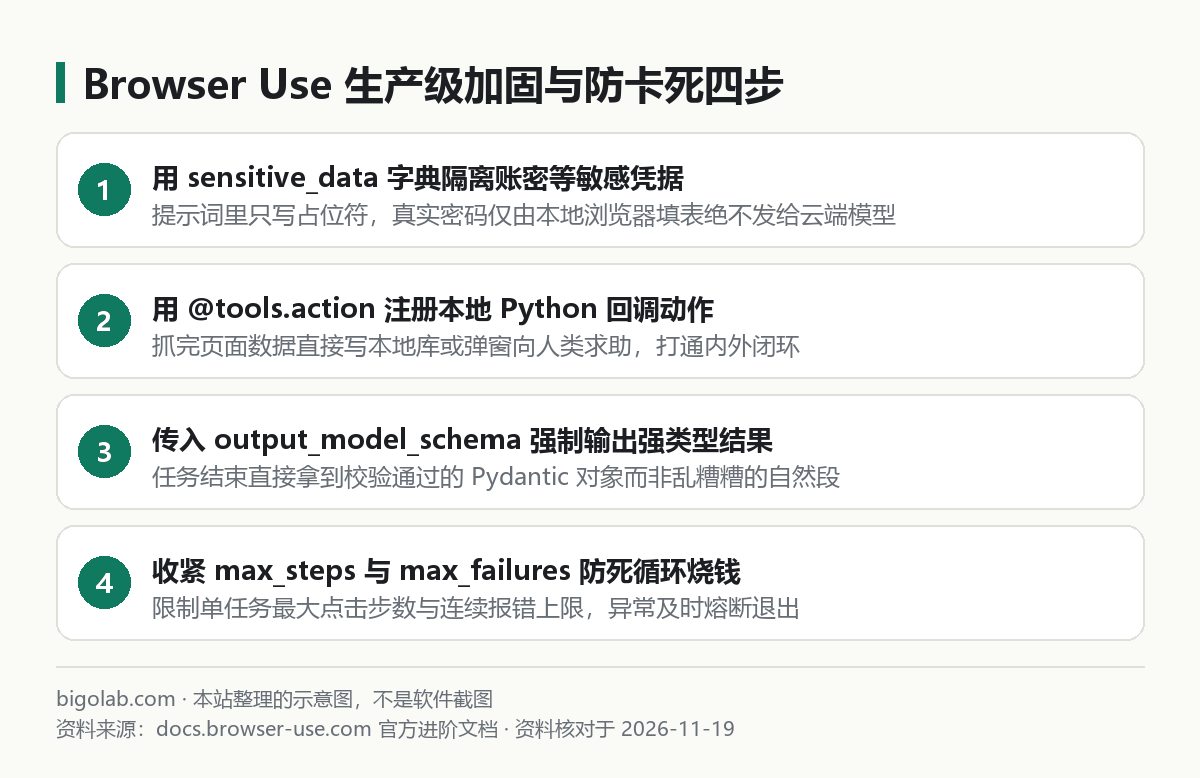
下面这份完整 Python 脚本把敏感凭据隔离、自定义本地动作(Tools)、Pydantic 结构化返回值以及步数与连续失败熔断全部组装在了一起:
python
import asyncio
import os
from pydantic import BaseModel
from browser_use import Agent, Browser, ChatAnthropic, Tools, ActionResult

# 1. 定义任务结束时必须返回的强类型结构(原理同 Pydantic AI 结构化校验)
class DashboardMetrics(BaseModel):
    active_users: int
    pending_tickets: int
    system_healthy: bool

# 2. 注册自定义本地 Python 动作:让浏览器智能体随时回调你的内部逻辑
tools = Tools(output_model=DashboardMetrics)

@tools.action("当页面出现异常红色告警横幅时,发送内部通知给值班工程师")
async def notify_oncall(alert_text: str) -> ActionResult:
    print(f"[本地告警回调已触发] 捕获页面异常:{alert_text}")
    return ActionResult(extracted_content="已成功记录告警并通知值班人员")

async def run_inspection():
    # 3. 准备敏感凭据字典:从本地环境变量读取,绝不明文拼入提示词
    secrets = {
        "https://admin.staging.example.com": {
            "stg_user": os.environ["STAGING_ADMIN_USER"],
            "stg_pass": os.environ["STAGING_ADMIN_PASS"],
        }
    }

    browser = Browser(headless=True)
    llm = ChatAnthropic(model="claude-sonnet-4-5", temperature=0.0)

    agent = Agent(
        task=(
            "访问 https://admin.staging.example.com ,使用账号 stg_user 和密码 stg_pass 登录测试后台。"
            "进入概览看板提取今日活跃用户数与待处理工单数;若顶部有红色告警条请先调用通知工具,最后按指定结构输出结果。"
        ),
        llm=llm,
        browser=browser,
        tools=tools,
        sensitive_data=secrets, # 按域名严格绑定的敏感占位字典
        max_failures=3,         # 连续 3 次动作报错立即熔断止损,不死磕
        max_actions_per_step=4, # 允许同一轮把“输账号+输密码+点登录”打包批量执行省费用
    )

    # 4. 硬卡全局最大步数上限 max_steps=15,严防意外跳转陷入死循环
    history = await agent.run(max_steps=15)
    raw_json = history.final_result()
    if raw_json:
        metrics = DashboardMetrics.model_validate_json(raw_json)
        print("巡检结构化结果:", metrics)

if __name__ == "__main__":
asyncio.run(run_inspection())研发团队订阅与高配额省心方案:调试复杂多步智能体循环、RAG 切片策略与 CI 评测流水线非常消耗单日 Token。个人主力开发推荐免上号兑换 Claude Pro iOS 自助卡密 或 5 倍额度的 Claude Max 5x,多人研发团队协同亦可联系客服定制 ChatGPT Business 团队版。
三、省一半 Token 与防卡死的四个关键参数细节
由于浏览器智能体每走一步都要读取精简 DOM 树(开启视觉时还要附带网页截图),单次任务的上下文开销远高于纯文本问答。调优下面四个细节能让稳定性和账单同时改善:
- 务必给
sensitive_data套上域名限定键名:注意上面代码里字典外层包了"https://admin.staging.example.com": { ... }。这样就算网页上藏着恶意第三方跳转链接把浏览器拐到了外部钓鱼域名,Browser Use 检测到当前 URL 域名不匹配,会当场拒绝填入真实密码。 - 善用
max_actions_per_step合并连贯小动作:面对包含五六个输入框的常规表单,允许模型在单次推理里一口气规划好“填姓名 -> 填邮箱 -> 勾选协议 -> 点提交”四步动作连续跑完,比每填一个框就重新截一次图调一次大模型快三倍、省一大半开销。 - 分清何时用本地独立配置目录(
user_data_dir)复用登录态:对于已经手动登录好的复杂后台,不要直接挂载你平时办公正在开着的系统主 Chrome 目录(两个进程同时读写同一个 Profile 极易引发文件锁冲突报错);更稳妥的做法是单独指定一个专用目录如user_data_dir="./bot_chrome_profile",首次以有头模式(headless=False)手动登好保存 Cookie,后续定时巡检再切无头模式静默复用。 - 纯静态内容采集别杀鸡用牛刀:如果目标网页根本不需要多步点按钮填表,只是想把几十篇公开网页转成干净文本入库,改用 Crawl4AI 异步并发抓取框架 会省掉百分之九十以上的模型调用费;而复杂的纯后端数据校验编排则可搭配 Pydantic AI 框架 协同处理。
日常编写自动化端到端巡检脚本与调试前端选择器逻辑时,配合官方固定额度的编程订阅工具效率极高。需要开通海外直连开发订阅的同学,可前往查看贝果研究社 Claude Code 订阅与配置方案或 ChatGPT Plus 自助充值专页。
常见问题
巡检过程中如果意外撞上人机验证码(CAPTCHA)或者二次短信确认,应该怎么优雅处理?
切记:严禁尝试用任何自动化脚本或视觉模型去破解、绕过人机验证码门禁。针对自家测试环境,正道是在测试服后台给自动化巡检账号或内网 IP 配置免验证码白名单;针对个人本地辅助填表场景,可以写一个 @tools.action("遇到人工验证或支付确认时暂停等待人类接管") 函数,在终端发出提示音并 input("请人工在浏览器窗口完成核验后按回车继续..."),人手点完再交还给智能体收尾。
怎么回放排查昨天半夜无头模式(headless=True)跑挂的那一步到底点偏到了哪儿?
在初始化 Agent 时传入 save_conversation_path="./logs/run_trace" 或开启内置的 GIF 录屏参数(generate_gif=True)。跑完后目录下会自动生成一张按步骤标清高亮点击框的完整操作动图,一眼就能看清是弹窗没关掉还是测试服接口超时白屏。
搭好开源框架后,国内没有外币信用卡怎么开通主力编程与大模型订阅?
可在 本站 AI 会员充值中心 使用支付宝、微信支付或 AlipayHK 自助选购卡密,支持免交密码兑换 Claude Code(Pro / Max)、ChatGPT Plus 与 ChatGPT Pro,并支持开具增值税发票;实时价格与售后边界(封号不在质保范围)以对应商品页说明为准。
小结
- 涉及登录账号密码等敏感字段一律走按域名锁定的
sensitive_data字典,绝不把明文凭据塞进task提示词。 - 用
Tools(output_model=...)与@tools.action打通本地 Python 告警入库函数并拿回经过 Pydantic 校验的强类型结果。 - 生产运行必须同时卡死
agent.run(max_steps=...)与max_failures=3,复用登录态时优先创建独立的专用user_data_dir配置文件夹避免锁冲突。
0 条评论
还没有评论,来抢沙发~