
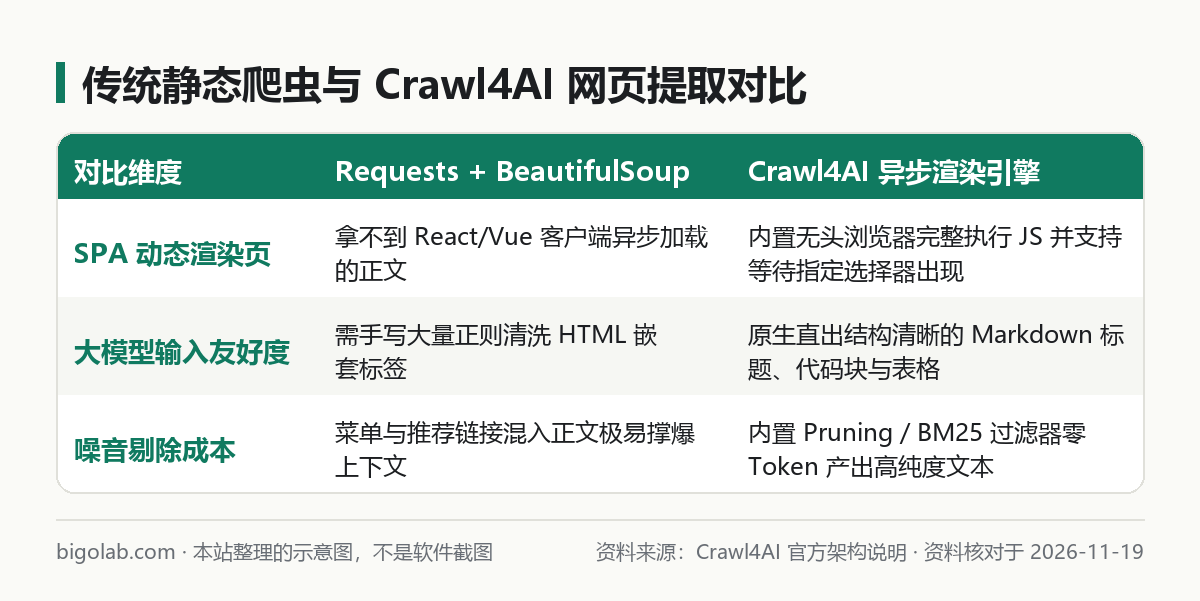
给私有知识库(例如 RAGFlow 或 Dify 知识库)采集外部技术文档、竞品帮助中心或行业资讯时,传统 requests + BeautifulSoup 老组合越来越力不从心:一方面现代单页应用(SPA)全是客户端 JavaScript 异步渲染,静态请求抓回来只有空壳;另一方面就算拿 Playwright 取到了完整 HTML,里面八成字数都是顶部巨大下拉菜单、侧边推荐链接和页脚版权声明,原样喂给大模型白白烧掉一大半上下文额度。
专门面向大模型与智能体数据管道设计的开源 Python 框架 Crawl4AI,把“无头浏览器并发渲染 + 智能噪音剪枝 + 原生结构化 Markdown 生成”打包成极简的几行异步代码。下面带你从零跑通最核心的清洗流水线。
AI 全栈开发订阅配套入口:在本地部署与联调开源 AI 框架时,搭配固定月费的终端编程智能体与旗舰推理订阅能大幅缩短排错时间。国内无境外信用卡可在本站通过支付宝、微信支付或 AlipayHK 免密自助开通 Claude Code 订阅、ChatGPT Plus / Pro 或查看 AI 会员充值总览。
一、两行命令安装与初始化浏览器内核
在 Python 3.10 及以上虚拟环境中安装主包,并执行内置初始化向导自动拉取无头 Chromium 浏览器依赖:
bash
pip install -U crawl4ai
crawl4ai-setup
如果在无图形界面的 Ubuntu 云服务器上部署,跑完 crawl4ai-setup 后还可以顺手执行一句 crawl4ai-doctor,它会自动做一次自检,确认系统底层字体库与沙箱依赖全部齐备。
二、核心实战代码:用 PruningContentFilter 榨出纯净 fit_markdown
很多新手第一次跑 Crawl4AI 只打印了默认的原始 Markdown,发现顶部菜单链接还是被转成了几十行列表。真正的省钱精髓在于配置 PruningContentFilter(密度剪枝过滤器) 并读取 fit_markdown——它完全不消耗半点大模型 API 额度,纯靠本地算法计算 DOM 节点的文本密度与超链接占比,精准砍掉“字少链接多”的导航栏噪音块。
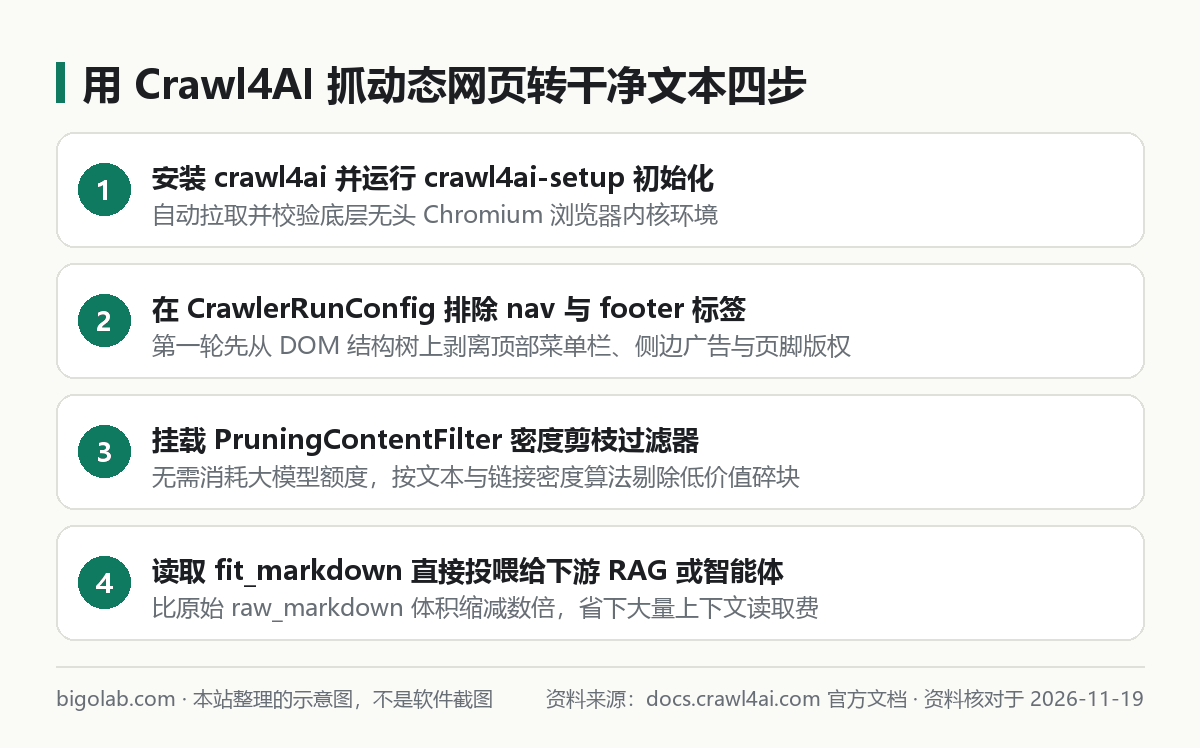
保存下面这段完整异步脚本为 clean_crawl.py 直接运行:
python
import asyncio
from crawl4ai import AsyncWebCrawler, BrowserConfig, CrawlerRunConfig, CacheMode
from crawl4ai.content_filter_strategy import PruningContentFilter
from crawl4ai.markdown_generation_strategy import DefaultMarkdownGenerator

async def fetch_clean_doc(target_url: str):
    # 1. 配置无头浏览器参数(调试时可将 headless 设为 False 观察渲染过程)
    browser_cfg = BrowserConfig(headless=True, verbose=False)

    # 2. 定义无 LLM 开销的动态密度剪枝过滤器
    prune_filter = PruningContentFilter(
        threshold=0.45,           # 剪枝阈值:越高越严格,常规技术文档 0.4~0.5 最均衡
        threshold_type="dynamic", # 根据页面标签类型与链接占比动态打分
        min_word_threshold=5      # 自动丢弃不足 5 个词的零碎按钮提示文本
    )

    # 3. 组装单次抓取运行配置:先剔除语义噪音标签,再执行 Markdown 清洗生成
    run_cfg = CrawlerRunConfig(
        cache_mode=CacheMode.BYPASS,
        excluded_tags=["nav", "footer", "aside", "header"],
        markdown_generator=DefaultMarkdownGenerator(content_filter=prune_filter),
        wait_until="networkidle"  # 等待前端异步接口数据加载稳定后再提取
    )

    async with AsyncWebCrawler(config=browser_cfg) as crawler:
        result = await crawler.arun(url=target_url, config=run_cfg)
        if not result.success:
            raise RuntimeError(f"抓取失败:{result.error_message}")

        md_obj = result.markdown_v2 if getattr(result, "markdown_v2", None) else result.markdown
        print(f"原始文本长度:{len(md_obj.raw_markdown)} -> 剪枝后纯净长度:{len(md_obj.fit_markdown)}")
        return md_obj.fit_markdown

if __name__ == "__main__":
    clean_text = asyncio.run(fetch_clean_doc("https://docs.python.org/3/whatsnew/3.13.html"))
    print(clean_text[:800])
跑完对比长度你会直观看到:一份原本长达四万字符的带导航技术文档,经过 excluded_tags 标签剔除加 PruningContentFilter 剪枝后,浓缩出的 fit_markdown 往往只剩下一万多字符的纯干货正文、完整代码块与标准 Markdown 表格,直接切片入库或喂给大模型总结省钱又精准。
研发团队订阅与高配额省心方案:调试复杂多步智能体循环、RAG 切片策略与 CI 评测流水线非常消耗单日 Token。个人主力开发推荐免上号兑换 Claude Pro iOS 自助卡密 或 5 倍额度的 Claude Max 5x,多人研发团队协同亦可联系客服定制 ChatGPT Business 团队版。
三、进阶实战技巧:带查询词的 BM25 过滤与结构化抽取
除了通用的密度剪枝,面对长篇巨制网页或电商列表页,还有两个极其好用的内建武器:
- 只保留与特定问题相关的段落(
BM25ContentFilter):如果你只需要从一篇五万字的年度财报网页里捞出“研发费用投入”相关段落,把过滤器换成BM25ContentFilter(user_query="研发费用 算力基础设施"),它会在本地算完相关性得分,只把命中主题的高分段落拼进fit_markdown。 - 零大模型开销按 CSS 选择器直接抽 JSON(
JsonCssExtractionStrategy):对于结构高度规整的新闻列表、商品卡片或开源仓库榜单,无需每页都调昂贵大模型硬抽字段,只需写好一份包含标题、价格、详情链接 CSS 选择器的规则字典传给extraction_strategy,一次抓取就能直接拿到干干净净的 JSON 数组。 - 跟视觉浏览器智能体划清分工边界:如果你的任务是“批量把几百个公开帮助文档洗成干净 Markdown”,用 Crawl4AI 异步并发
arun_many()速度快一个数量级;但如果你需要让 AI 自己看着屏幕填写复杂多步表单、点弹窗交互,则更适合交给 Browser Use 浏览器操作智能体 来驱动。
日常编写数据清洗管道与调试复杂选择器规则时,搭配趁手的终端编程智能体能省掉大量手试 DOM 结构的时间。需要开通海外官方开发订阅的工程师,可前往查看贝果研究社 Claude Code 订阅与配置方案或全站 AI 开发者订阅自助导航。
常见问题
抓取单页应用时,正文明明在浏览器里看得到,抓回来为什么还是空白?
部分重前端框架在 networkidle 之后还会花几百毫秒做本地组件挂载渲染。遇到这种情况,不要盲目加死睡眠等待,直接在 CrawlerRunConfig 里传入 wait_for="css:article.main-content"(填正文容器的真实 CSS 选择器),让爬虫精准等到目标正文元素真正渲染上屏的那一刻再动手提取。
批量并发抓几百个网页时需要注意什么合规底线?
务必严格遵守目标站点的 robots.txt 协议与服务条款,不要用来绕过付费墙、登录鉴权或反爬验证码门禁;在调用批量异步接口 arun_many 时,配合内置的速率限制与并发信号量控制单域名请求间隔,避免给对方文档服务器造成异常流量压力。
搭好开源框架后,国内没有外币信用卡怎么开通主力编程与大模型订阅?
可在 本站 AI 会员充值中心 使用支付宝、微信支付或 AlipayHK 自助选购卡密,支持免交密码兑换 Claude Code(Pro / Max)、ChatGPT Plus 与 ChatGPT Pro,并支持开具增值税发票;实时价格与售后边界(封号不在质保范围)以对应商品页说明为准。
小结
- 安装
crawl4ai后运行crawl4ai-setup一键配齐无头浏览器内核,轻松搞定动态 JS 渲染页面。 - 组合使用
excluded_tags与PruningContentFilter,零大模型 API 成本输出高信噪比的fit_markdown。 - 动态慢加载页面用
wait_for="css:选择器"精准守候渲染完成,规整列表页优先用JsonCssExtractionStrategy直接提取结构化 JSON。
0 条评论
还没有评论,来抢沙发~