
在企业内部搭建私有知识库时,很多团队先试了常规的按固定字数(如每 500 字一块)硬切方案,结果一上传财务 PDF 报表、招投标技术标书或带复杂公式的双栏手册,问答准确率就断崖式下跌——表头和第三十行数据被硬生生切成两段,大模型拿到的全是没头没尾的残缺碎片。
由 InfiniFlow 开源的 RAGFlow 之所以在 GitHub 上热度居高不下,核心卖点可用一句话概括:“Quality in, quality out(进得干净,答得才准)”。它底层内置了专门训练过的版面识别与表格结构重建引擎(DeepDoc),并且允许人类在网页上亲眼检查并微调每一页 PDF 的切分框。如果你之前对比过 Dify 私有化 Docker 部署 与 常规知识库分段检索调优,遇到高难度排版文档时完全可以把 RAGFlow 作为专业解析底座搭起来。
AI 全栈开发订阅配套入口:在本地部署与联调开源 AI 框架时,搭配固定月费的终端编程智能体与旗舰推理订阅能大幅缩短排错时间。国内无境外信用卡可在本站通过支付宝、微信支付或 AlipayHK 免密自助开通 Claude Code 订阅、ChatGPT Plus / Pro 或查看 AI 会员充值总览。
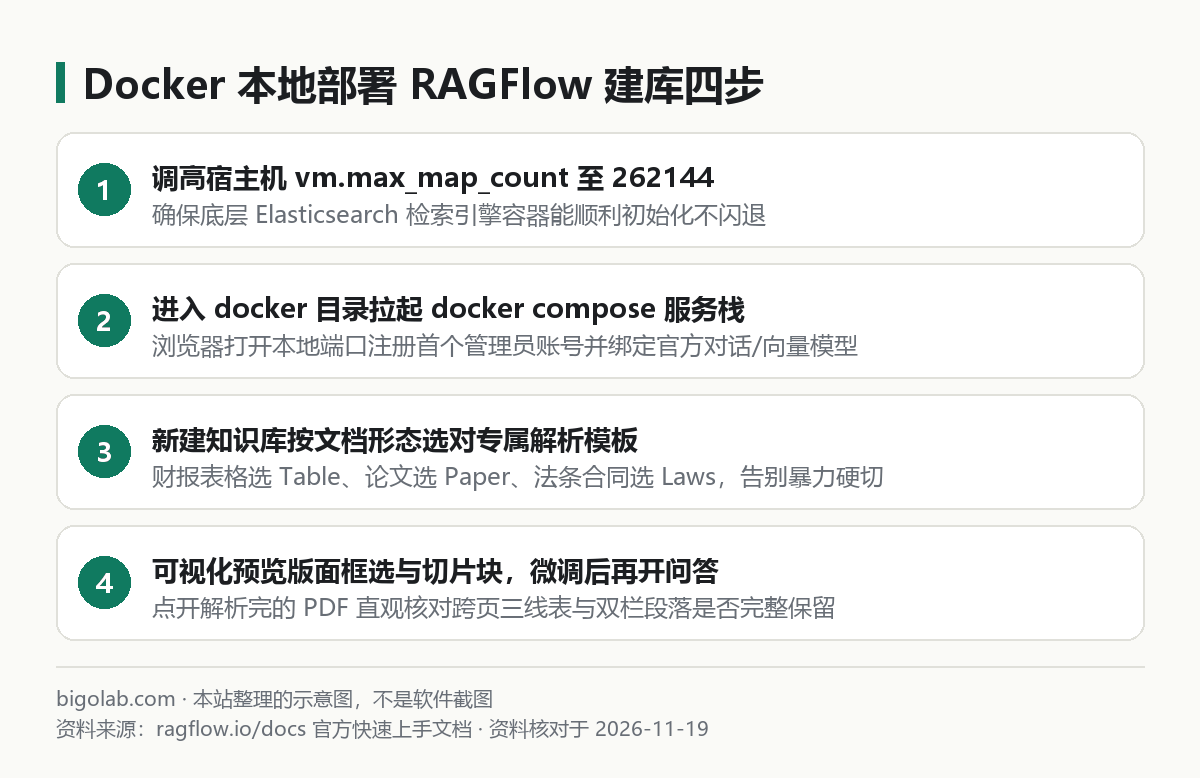
一、Docker 本地部署:启动前必改一个内核参数
准备一台至少 4 核 CPU、16 GB 内存、50 GB 可用磁盘 的 Linux 服务器或开启了 WSL2 的 Windows / macOS 开发机。动手拉镜像前,第一件事是检查宿主机虚拟内存映射上限——因为 RAGFlow 默认依赖 Elasticsearch 存储全文与向量索引,参数过小会导致容器反复重启起不来。
1. 调高 vm.max_map_count 至 262144
在 Linux 终端(或 Windows 的 WSL2 发行版终端)执行以下命令:
bash
# 查看当前值,若小于 262144 则临时调高
sysctl vm.max_map_count
sudo sysctl -w vm.max_map_count=262144

# 写入 /etc/sysctl.conf 确保重启机器后永久生效
echo "vm.max_map_count=262144" | sudo tee -a /etc/sysctl.conf
2. 拉取仓库并启动服务栈
确认 Docker 与 Docker Compose 版本正常后,克隆官方仓库并一键后台启动:
bash
git clone https://github.com/infiniflow/ragflow.git
cd ragflow/docker

# 拉取官方预置轻量镜像并在后台拉起整套服务
docker compose -f docker-compose.yml up -d

# 观察核心后端容器日志,看到服务监听提示即代表初始化就绪
docker logs -f ragflow-server
看到终端刷出启动成功标志后,打开浏览器访问 http://localhost(默认 80 端口),第一位注册邮箱的用户会自动成为系统管理员。进入右上角 Model Providers(模型提供方) 页面,既可以填入 OpenAI、Anthropic、Google Gemini 等官方云端 API Key,也可以直连内网机器上跑着的 Ollama 本地对话与嵌入模型。
二、选对解析切片模板(Chunking Methods)少走九成弯路
在顶部点击 Knowledge Base(知识库) 新建资料库时,最核心的配置项就是 Chunk Method(切片解析方法)。千万不要所有文件都偷懒选默认的通用模式,按你的真实业务文档对号入座:
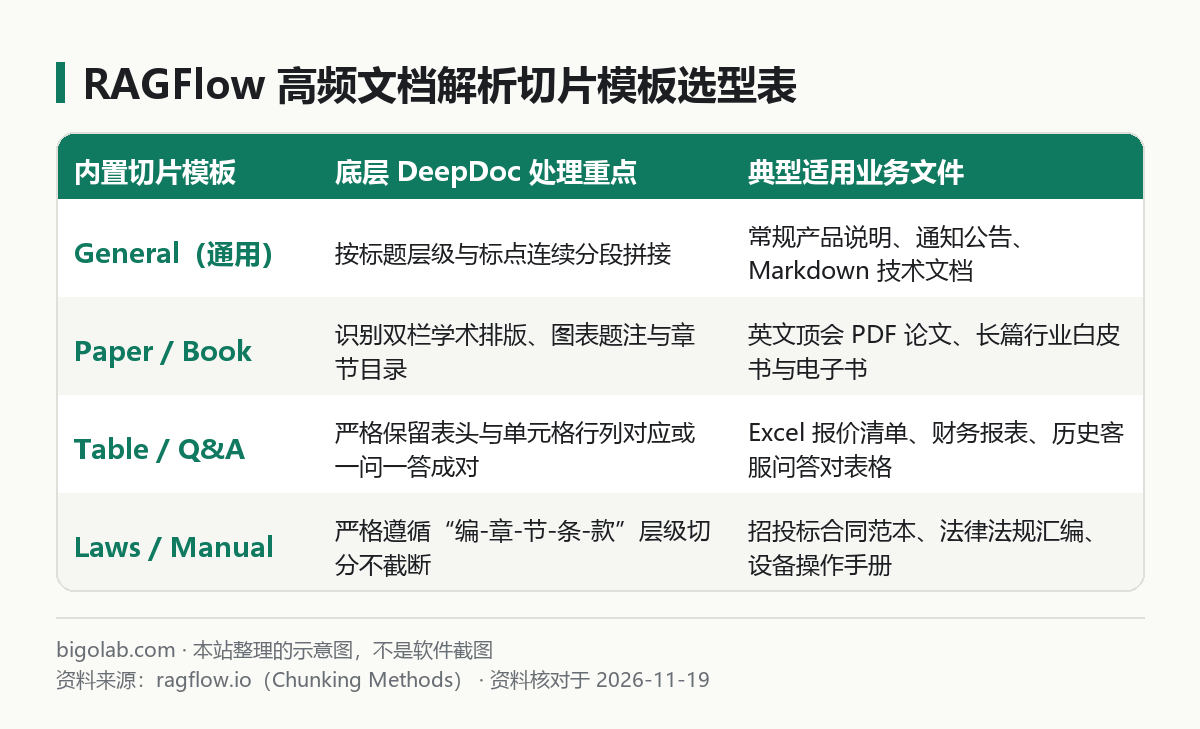
如果一个部门既有 Word 规章制度,又有一堆 Excel 历史报价单,最稳的做法是拆成两个不同模板的知识库分别解析,最后在创建对话助手(Chat Assistant)时把这两个知识库同时勾选关联进来联合检索。
研发团队订阅与高配额省心方案:调试复杂多步智能体循环、RAG 切片策略与 CI 评测流水线非常消耗单日 Token。个人主力开发推荐免上号兑换 Claude Pro iOS 自助卡密 或 5 倍额度的 Claude Max 5x,多人研发团队协同亦可联系客服定制 ChatGPT Business 团队版。
三、可视化版面审校与混合检索调优
上传完 PDF 点击右侧播放小按钮触发解析后,由于 DeepDoc 需要逐页做视觉版面检测与表格行列还原,耗时比纯文本提取稍慢一些(配备 GPU 加速镜像可显著提速)。解析绿灯完成后,点进文件名就能看到 RAGFlow 最惊艳的双栏对照审校视图:
- 左看原件框选,右改切片正文:左侧 PDF 原页面上会用彩色方框标出模型识别出的正文段、表格区与图片题注;右侧列出切好的每一个文本块。发现某一条关键免责条款被切漏了,直接在右侧双击编辑补充,或者手动新增一条高频关键词(Keywords)提权。
- 开启“向量语义 + 关键词全文”多路召回与重排(Rerank):在聊天助手检索配置中,RAGFlow 默认结合稠密向量相似度与稀疏全文精确匹配(专治产品型号
XJ-902B这类纯向量搜不准的编号),强烈建议在模型设置里顺手配好一个 Rerank 重排模型,把最贴切的前 5 段顶到最前面再喂给大模型作答。
在本地调试复杂的 RAG 清洗脚本或编写下游知识库接口代码时,很多后端工程师还会搭配强力编程智能体与主力对话订阅辅助排障。需要开通海外正规开发订阅的同学,可前往查看贝果研究社 Claude Code 订阅与配置方案或 ChatGPT Plus 自助充值专页。
常见问题
上传一份 80 页的扫描版合同一直卡在解析进度条不动怎么办?
首先运行 docker stats 检查是不是宿主机 16GB 内存已经被 Elasticsearch 和视觉解析进程吃满触发了系统 OOM 杀进程;其次,默认轻量版镜像(Slim)为了减小下载体积未打包部分本地大体积嵌入模型,请确认你已经在后台模型设置里正确配通了可用的 Embedding 向量接口。对于成百上千页的重度 OCR 场景,建议切换使用 docker-compose-gpu.yml 调用显卡算力加速版面识别。
RAGFlow 建好的知识库能给 Dify 或我们自己写的 Python 后端调用吗?
完全可以。在 RAGFlow 右上角个人设置里生成一枚专属 API Key,它不仅提供原生 HTTP RESTful 检索与对话接口,还提供了兼容 Dify 外部知识库 API 规范的接入端点。这样你就可以用 RAGFlow 专心啃硬骨头 PDF 解析,再把干净检索结果无缝接进现有的智能体工作流。
搭好开源框架后,国内没有外币信用卡怎么开通主力编程与大模型订阅?
可在 本站 AI 会员充值中心 使用支付宝、微信支付或 AlipayHK 自助选购卡密,支持免交密码兑换 Claude Code(Pro / Max)、ChatGPT Plus 与 ChatGPT Pro,并支持开具增值税发票;实时价格与售后边界(封号不在质保范围)以对应商品页说明为准。
小结
- 用 Docker 部署 RAGFlow 前,务必先将宿主机
vm.max_map_count调至262144防止底层检索引擎启动失败。 - 告别一刀切硬分段,按文件真实形态精准选用 Paper、Laws、Table 或 Q&A 专属解析模板。
- 解析完成后花两分钟点进可视化双栏视图抽查跨页表格还原质量,并搭配多路混合检索加 Rerank 模型稳住回答准确度。
0 条评论
还没有评论,来抢沙发~