
跑通了 Vercel AI SDK 入门安装与 generateText 基础对话之后,一旦你在 Next.js 后端路由里用 streamText 给模型挂上工具(Tools),十有八九会撞上同一个新手困惑:“模型明明成功调了查天气函数、也拿到了返回的温度 JSON,为什么前端聊天框就停在那儿不说话了,没有把温度组织成自然语言回答出来?”
原因非常简单:默认情况下,streamText 只执行单步(1 Step)推理——模型吐出工具调用指令并执行完函数后,本轮生成即宣告结束。想要让它把工具返回结果自动喂回给大模型继续推理(甚至连调三四个工具再总结),必须显式配置多步循环条件。下面把多步流式控制与官方 @ai-sdk/mcp 接入一次讲透。
AI 全栈开发订阅配套入口:在本地部署与联调开源 AI 框架时,搭配固定月费的终端编程智能体与旗舰推理订阅能大幅缩短排错时间。国内无境外信用卡可在本站通过支付宝、微信支付或 AlipayHK 免密自助开通 Claude Code 订阅、ChatGPT Plus / Pro 或查看 AI 会员充值总览。
一、看清接口升级:stopWhen: stepCountIs(n) 与 @ai-sdk/mcp
如果你搜到的是半年前的老博客,很可能会看到 maxSteps: 5 或者从主包里导入实验性的 experimental_createMCPClient。在当前官方标准规范中,这两处都已经演进为更清晰、模块化的正式写法:
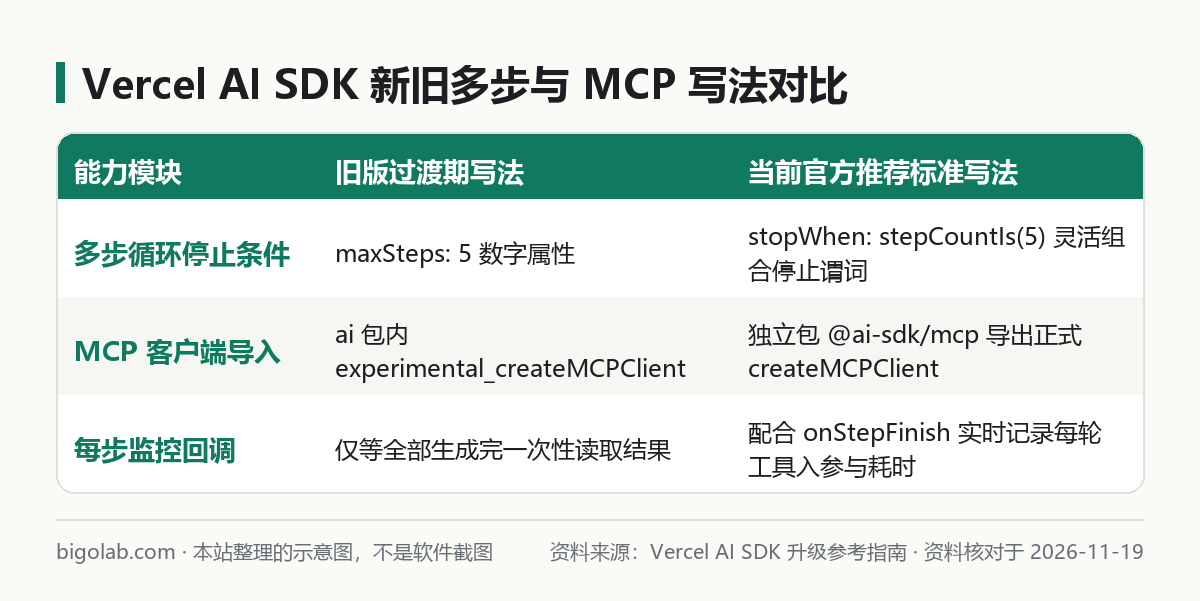
先在你的 TypeScript / Next.js 项目里装齐核心包、官方模型提供方包以及独立的 MCP 客户端包:
bash
npm install ai @ai-sdk/anthropic @ai-sdk/mcp zod二、完整实战代码:streamText 自动多步调 MCP 与本地工具
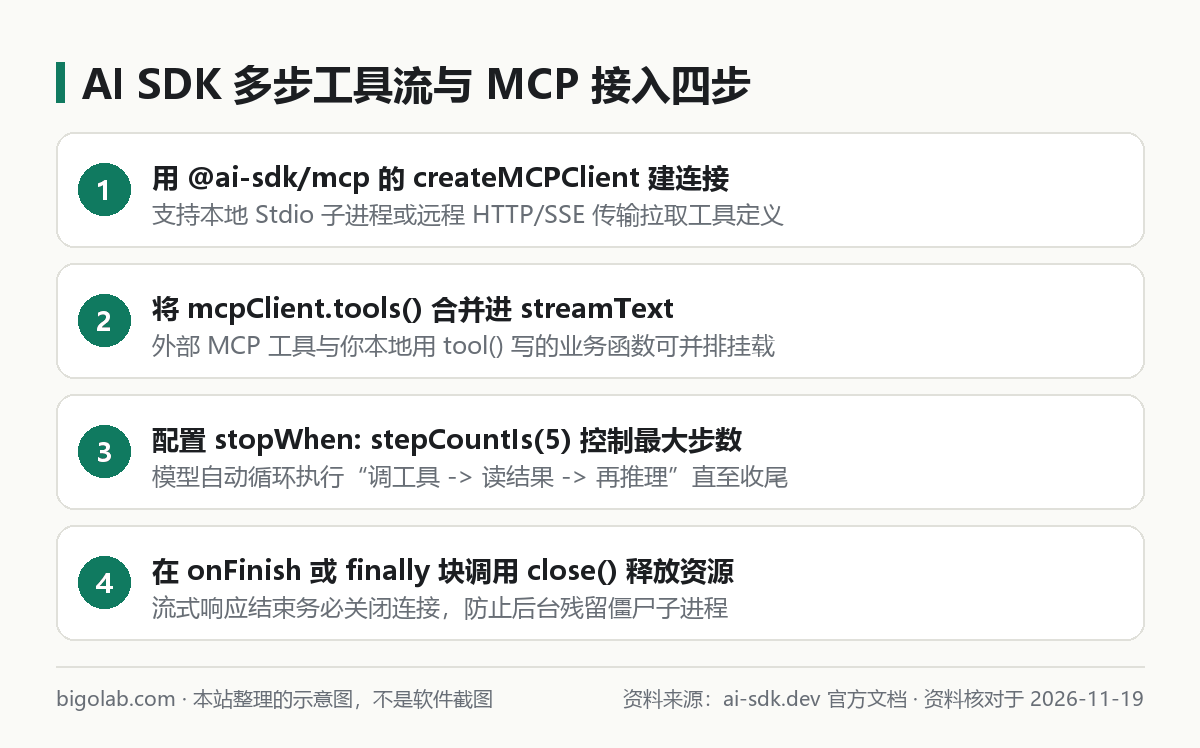
下面是一份可直接放入 Next.js App Router(app/api/chat/route.ts)的生产级路由模板。它同时接入了一个远程 HTTP MCP 服务与一个本地 Zod 校验工具,并在流式传输彻底收尾时安全关闭连接:
typescript
import { anthropic } from '@ai-sdk/anthropic';
import { createMCPClient } from '@ai-sdk/mcp';
import { streamText, stepCountIs, tool } from 'ai';
import { z } from 'zod';

export async function POST(req: Request) {
  const { messages } = await req.json();

  // 1. 连接团队内部远程 HTTP/SSE MCP 服务(亦支持 StdioMCPTransport 拉起本地进程)
  const mcpClient = await createMCPClient({
    transport: {
      type: 'sse',
      url: 'https://mcp.internal.example.com/sse',
      headers: {
        Authorization: `Bearer ${process.env.INTERNAL_MCP_TOKEN}`,
      },
    },
  });

  // 2. 自动发现并拉取远程 MCP 暴露的全部工具定义
  const mcpTools = await mcpClient.tools();

  // 3. 启动多步流式智能体循环,将外部 MCP 工具与本地业务工具合并挂载
  const result = streamText({
    model: anthropic('claude-sonnet-4-5'),
    messages,
    tools: {
      ...mcpTools,
      calculateDiscount: tool({
        description: '根据订单原价与会员等级计算折后应付比例',
        parameters: z.object({
          tier: z.enum(['GOLD', 'SILVER']),
        }),
        execute: async ({ tier }) => ({ ratio: tier === 'GOLD' ? 0.85 : 0.95 }),
      }),
    },
    // 关键开关:允许最多连续执行 5 轮“模型决策 -> 调工具 -> 结果喂回模型”循环
    stopWhen: stepCountIs(5),
    onStepFinish({ stepType, toolCalls, usage }) {
      console.log(`[Step ${stepType}] 调用工具数: ${toolCalls.length}, 本步 Token: ${usage.totalTokens}`);
    },
    onFinish: async () => {
      // 关键防泄漏动作:等整个流发送完毕后再关闭 MCP 连接
      await mcpClient.close();
    },
  });

  return result.toUIMessageStreamResponse();
}研发团队订阅与高配额省心方案:调试复杂多步智能体循环、RAG 切片策略与 CI 评测流水线非常消耗单日 Token。个人主力开发推荐免上号兑换 Claude Pro iOS 自助卡密 或 5 倍额度的 Claude Max 5x,多人研发团队协同亦可联系客服定制 ChatGPT Business 团队版。
三、全栈开发最容易踩爆的三个线上大坑
把这套流式多步代码推上生产环境前,请逐项核对下面三个细节:
- 千万别在
return语句外面的finally里提前调mcpClient.close()(这是streamText和同步generateText最大的区别):
因为 streamText 是非阻塞立即返回流响应对象的,当你 return 的那一毫秒,真正的第 2、第 3 步工具调用还没跑完。如果你套了 try ... finally { await mcpClient.close() },流刚发出去第一帧 MCP 通道就被你亲手掐断了,第 2 步调工具必报连接已关闭。在流式场景下,一律把 await mcpClient.close() 放进 onFinish 与 onError 回调里执行。
- 给 MCP 工具加 Schema 显式白名单收敛体积:
如果远程服务一口气暴露了四十多个工具(就像我们在 LangGraph 接入 MCP 服务 或排查 远程 HTTP MCP 鉴权问题 时常见的重型服务),全量塞进每次聊天会拖慢首字延迟。mcpClient.tools({ schemas: { ... } }) 支持只挑选当前业务真正用到的那三四个工具并附带静态类型推导。
- 合理卡住
stepCountIs上限防死循环:
普通查库问答设 stepCountIs(3) 到 stepCountIs(5) 绰绰有余;复杂研究型智能体也尽量不要超过 10 步,并在 onStepFinish 里打好结构化审计日志监控单次对话累计消耗。
日常用 TypeScript 全栈打磨前后端流式交互界面时,配合强力的终端编程智能体能省去大量查类型签名的时间。需要开通海外官方开发订阅的工程师,可前往查看贝果研究社 Claude Code 订阅与配置方案或 ChatGPT Plus 自助充值专页。
常见问题
在 Vercel Serverless 函数或无服务器环境跑本地 StdioMCPTransport 为什么会报错?
无服务器云函数(Serverless Functions)是受限的短暂只读沙盒,既没有预装全局 npx 缓存目录,也不允许常驻后台子进程。在 Serverless 生产部署时,请一律将 MCP 服务独立部署并改用基于网络传输的 HTTP / SSE 远程连接模式,本地开发调试阶段再用 StdioMCPTransport。
前端 useChat 怎么把模型中间调用工具的加载过程优雅画出来?
新版 AI SDK 返回的消息结构采用统一的 parts(消息分片数组) 设计。你在 React 组件遍历 message.parts 时,遇到 part.type 属于工具调用分片即可根据状态渲染“正在查询内部订单库...”骨架卡片,等工具执行完流式吐出最终 text 分片时自然衔接正文,无需手写复杂的自定义事件解析。
如果某一个危险写操作工具(比如删除订单)不想让多步循环自动执行,能中途停下来等前端点确认吗?
完全可以。在定义这个高危 tool 时,故意省略不写 execute 服务端执行函数(只保留 description 与 parameters)。当 streamText 走到需要调用该工具的那一步时,因为没有服务端自动执行体,多步循环会自然停在该节点并把工具参数推给前端;前端弹出二次确认框等用户点击“同意删除”后,再调用 addToolResult 把确认结果发回后端接着往下走,兼顾流畅体验与人工审批门禁。
搭好开源框架后,国内没有外币信用卡怎么开通主力编程与大模型订阅?
可在 本站 AI 会员充值中心 使用支付宝、微信支付或 AlipayHK 自助选购卡密,支持免交密码兑换 Claude Code(Pro / Max)、ChatGPT Plus 与 ChatGPT Pro,并支持开具增值税发票;实时价格与售后边界(封号不在质保范围)以对应商品页说明为准。
小结
- 在
streamText中加上stopWhen: stepCountIs(5),模型才能在拿到工具返回结果后自动继续推理并流式输出自然语言总结。 - 统一从正式包
@ai-sdk/mcp导入createMCPClient,即可把外部远程或本地 MCP 工具与自有 Zod 工具无缝混编。 - 流式接口中务必在
onFinish回调内调用mcpClient.close(),切勿在同步finally块中过早掐断尚未跑完的多步流。
0 条评论
还没有评论,来抢沙发~