
本文根据 Claude Code 官方文档《Connect Claude Code to tools via MCP》《Best practices for Claude Code》《Choose a permission mode》《Common workflows》整理,资料核对于 2026-11-05。配图为本站整理的示意图,不是界面截图。本站(bigolab.com)不是 Anthropic 官方网站。
适用于谁
- 想让 Claude Code 帮忙写 REST 接口、数据模型、迁移脚本的后端新手或全栈开发者;
- 想让它直接看表结构、查数据来调试的人;
- 担心它读到
.env、误改迁移文件或误动数据库的人。
结论先说
- 查数据库用 MCP 服务器,官方给的示例是 PostgreSQL 的 DBHub,并明确要求连接串里用只读用户,这样 Claude 跑的查询改不了数据。
- 本机开发库和脱敏数据优先。官方没有禁止连生产库,但本站建议别连:提示注入风险官方也提醒过,连接任何服务器前要确认你信任它。
.env用拒绝规则(deny)挡住,官方说拒绝规则在每种权限模式下都生效,包括自动模式和bypassPermissions。- 「绝不能动」的目录用钩子:官方的例子就是用
PreToolUse钩子阻止对migrations/的编辑。 - 测试需要的环境变量写进 CLAUDE.md,这是官方点名的「Claude 读代码看不出来」的信息之一。
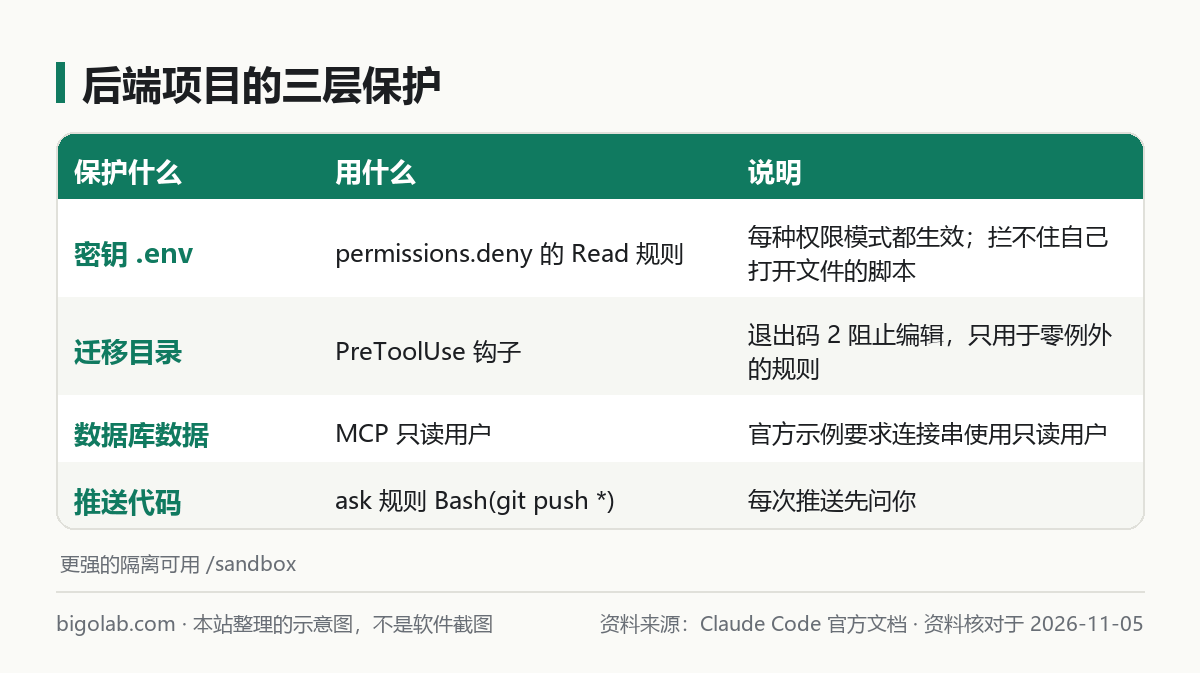
图:本站根据 Claude Code 官方文档:Best practices 整理的示意图
第一步:先把规矩写进 CLAUDE.md
官方说,CLAUDE.md 只写 Claude 读代码得不到的东西,比如集成测试需要哪个环境变量、哪个目录看似没用其实在用、哪些改动需要迁移评审。官方的示例风格是三段:命令、约定、坑。
提示词 1:整理后端项目的 CLAUDE.md
text
请阅读项目,更新 CLAUDE.md,只保留 Claude 读代码不容易发现的信息:
1)安装、启动、跑全部测试、跑单个测试文件、运行迁移的确切命令;
2)接口的约定:路由放哪里、请求体校验放哪里、统一的错误返回写法;
3)数据库相关的坑:测试需要的环境变量名(只写变量名,不要写值)、哪些表不能直接改、迁移怎么评审;
4)不允许修改的目录。
总长度不超过 80 行,先把修改后的全文给我看。
第二步:挡住密钥
在 .claude/settings.json 里写权限规则。官方的示例是:
json
{
  "permissions": {
    "allow": ["Bash(pnpm tsc --noEmit)"],
    "ask": ["Bash(git push *)"],
    "deny": ["Read(./.env)", "Read(./.env.local)", "Read(./secrets/**)"]
  }
}官方解释了边界:Read 拒绝规则能拦住 cat .env 这样的常见读文件命令,但拦不住一个自己打开该文件的脚本。如果要在操作系统层面限制文件和网络,可以在会话里输入 /sandbox 打开沙箱,它会读取你的 Read 拒绝规则。涉及密钥的整体原则见 /guides/ai-coding-security-secrets-permissions,沙箱见 /guides/claude-code-sandbox-security。
迁移目录属于「零例外」的规则,官方的做法是钩子:它甚至给了提示词 write a hook that blocks edits to the migrations folder,生成后用 /hooks 查看结果。钩子的写法见 /guides/claude-code-hooks。注意官方的提醒:钩子只用于确实没有例外的规则,偏好类的放 CLAUDE.md 就好。
第三步:连数据库看表结构
官方 MCP 页面给出的 PostgreSQL 示例如下,其中用户名密码要换成只读用户的:
bash
claude mcp add --transport stdio db -- npx -y @bytebase/dbhub \
  --dsn "postgresql://readonly:密码@主机:5432/库名"
添加后在会话里输入 /mcp,看 db 这一行有没有勾。官方的提问示例包括「Show me the schema for the orders table」。MCP 的基本用法见 /guides/claude-code-mcp-setup。
有几点要自己把关(这些是建议,不是官方逐条规定):连接串里有密码,别把带密码的配置提交进 Git;用本机或测试库;官方提醒已连接的 MCP 服务器会把工具名和说明放进上下文,不用的可以在 /mcp 里关掉。
提示词 2:用只读账号了解数据模型
text
通过 db 这个 MCP 服务器,只做查询,不要执行任何会修改数据或表结构的语句。
请列出与「订单」相关的表,说明每张表的字段、主键、外键和索引,并画出表之间的关系。
指出你觉得设计上有风险的地方(例如缺索引、缺约束),但先只讨论,不要改任何文件。
第四步:写接口,每次带检查
官方在通用工作流里强调:描述要具体,比如用 @ 引用现有文件让它照着风格写,并写明「不要引入新库」。后端接口建议先让它按现有一个接口的模式来写。
提示词 3:照现有接口写新接口
text
请参考 @src/api/orders.ts 的写法,新增「按用户查询订单列表」的接口:支持分页、按状态过滤;请求参数用项目已有的校验方式校验;不要引入新依赖。
先在计划模式下给我方案,包括:路由、参数、返回结构、需要的索引或迁移。我批准后再动手。
实现后补测试:覆盖正常、参数错误、没有数据、越权访问这四种情况,并运行【测试命令】直到通过。
如果规则只对某一部分代码有效,官方建议放进 .claude/rules/ 并用 paths: 限定,例如只对 src/api/**/*.ts 生效。官方的示例规则是请求体必须用现有 schema 校验、每个新接口都要在 openapi.yaml 里登记。
第五步:迁移和数据修改要有人把关
提示词 4:写迁移,但先不执行
text
我要给 orders 表加一个 status_updated_at 字段。
请只生成迁移文件,不要执行迁移。同时说明:1)这个迁移是否可回滚,回滚怎么写;2)对已有数据有什么影响;3)上线前我需要做的检查。
不要修改已有的迁移文件。
提示词 5:对照规格审查
text
请用子智能体审查当前改动:1)新增的接口是否都做了登录和权限检查;2)是否存在拼接 SQL 的写法;3)日志和错误信息有没有泄露敏感信息;4)迁移是否可以回滚。
只报告影响正确性或安全的问题,跳过风格问题,没有就写「未发现」。
关于 /code-review,见 /guides/claude-code-code-review-security-review-commands。
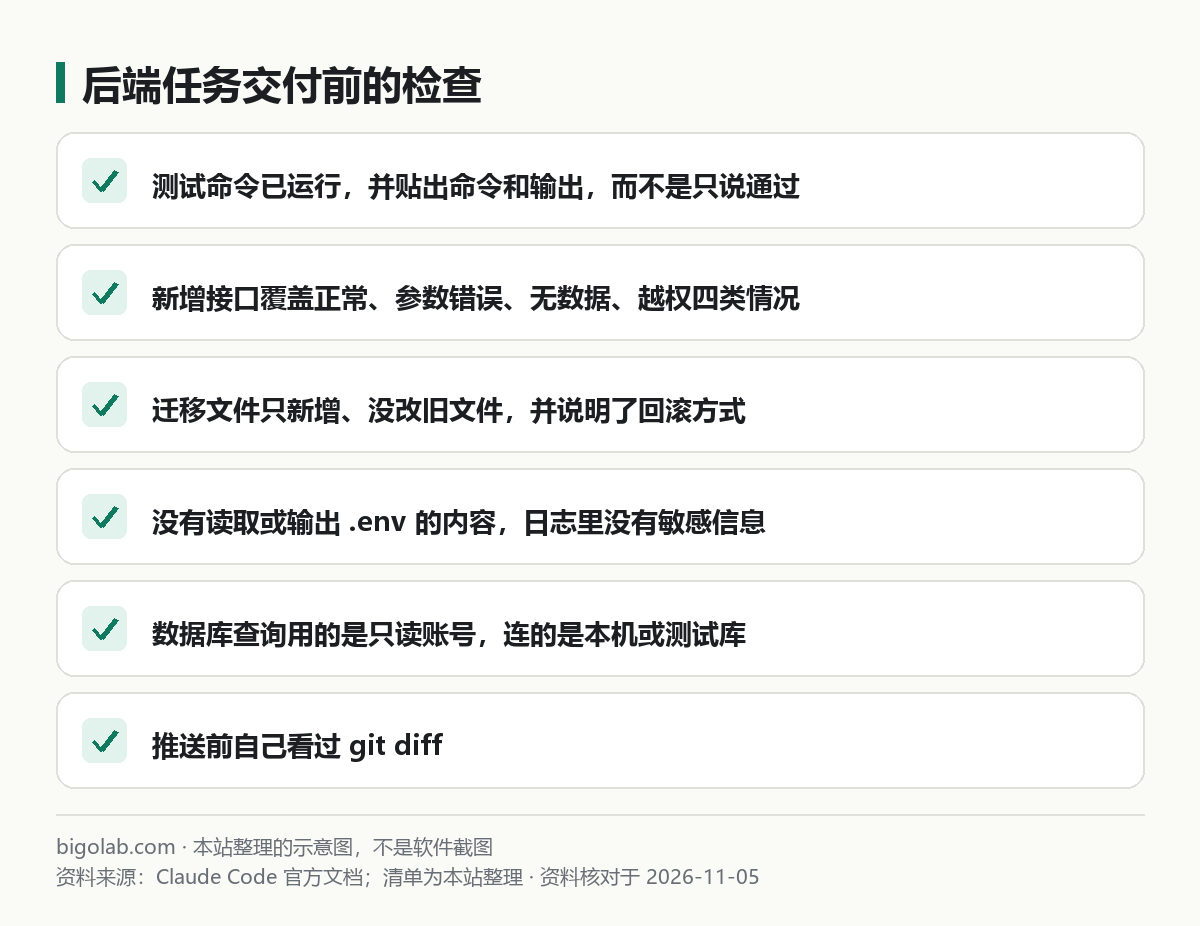
图:本站根据官方文档整理的示意图
排查接口问题时怎么交代信息
官方在修复缺陷的写法里建议:告诉 Claude 复现问题的命令、报错的堆栈,以及问题是偶发还是必现。后端排错同样适用。你可以这样描述:请求的方法和地址、请求体示例(去掉真实用户数据)、期望的返回、实际的返回和状态码、日志里的报错原文。有了这些,Claude 往往能直接定位到处理函数,再通过只读查询对照数据库里的数据。如果涉及多个服务,先让它画出请求经过的步骤,再逐段验证,而不是一上来就改代码。线上日志里常含有用户信息,贴给任何外部服务之前先脱敏。
常见问题
Q:能直接让它改线上数据库吗?
不建议。官方示例强调只读用户,改数据应由你自己评审后执行。
Q:每次运行命令都要确认,太慢?
官方有 acceptEdits 等权限模式,详见 /guides/claude-code-permission-modes,但对数据库、推送这类动作建议保持询问。
订阅和额度
后端开发的会话通常较长,建议按功能分会话。订阅选择见 /chongzhi/claude-code,价格和额度以官方页面当前显示为准。
相关教程
- /guides/claude-code-mcp-setup:MCP 怎么配
- /guides/claude-code-hooks:钩子
- /guides/ai-coding-security-secrets-permissions:AI 编码的密钥与权限
参考资料
- Claude Code 文档:Connect Claude Code to tools via MCP — https://code.claude.com/docs/en/mcp
- Claude Code 文档:Best practices for Claude Code — https://code.claude.com/docs/en/best-practices
- Claude Code 文档:Choose a permission mode — https://code.claude.com/docs/en/permission-modes
- Claude Code 文档:Common workflows — https://code.claude.com/docs/en/common-workflows
0 条评论
还没有评论,来抢沙发~