
結論先說
- 不要讓 ChatGPT 憑空「猜搜尋量」,正確分工是「外部 SEO 工具出真實數據 + ChatGPT 做意圖聚類與規劃」:大語言模型無法實時獲取精確月搜尋量與競爭難度,先把真實詞表導出為
.csv再上載給 ChatGPT 用 Python 分析。 - 關鍵詞聚類必須按「搜尋意圖 + 承接頁面類型」雙重歸組,避免站內同類頁面自相殘殺(Keyword Cannibalization):把同屬一個核心訴求的變體詞合併進同一落地頁,一個主詞配 3 到 5 個次級長尾詞。
- 寫 TDK 嚴禁堆砌逗號詞串,核心詞靠前且每頁唯一:遵循 Google 標題連結指南,英文 Title 控制在約 50–60 字符、中文控制在約 25–30 字,Description 負責用具體價值和行動鉤子拉高點擊率。
- Schema 結構化數據統一生成 JSON-LD 格式,且字段內容必須與頁面可見正文 100% 一致:嚴禁編造虛假星級評分、虛構庫存或塞入頁面里根本沒寫的問答;上線前務必過一遍官方富媒體測試工具。
- 上載數千行詞庫 CSV 跑 Python 聚類、批量導出 TDK 規劃表並生成多套 JSON-LD 代碼,對文件解析與代碼沙盒消耗較快:國內無外幣卡用戶可通過本站 ChatGPT Plus 自助充值 或 ChatGPT Plus 會員直充 獲得穩定的批量表格分析與代碼生成配額。
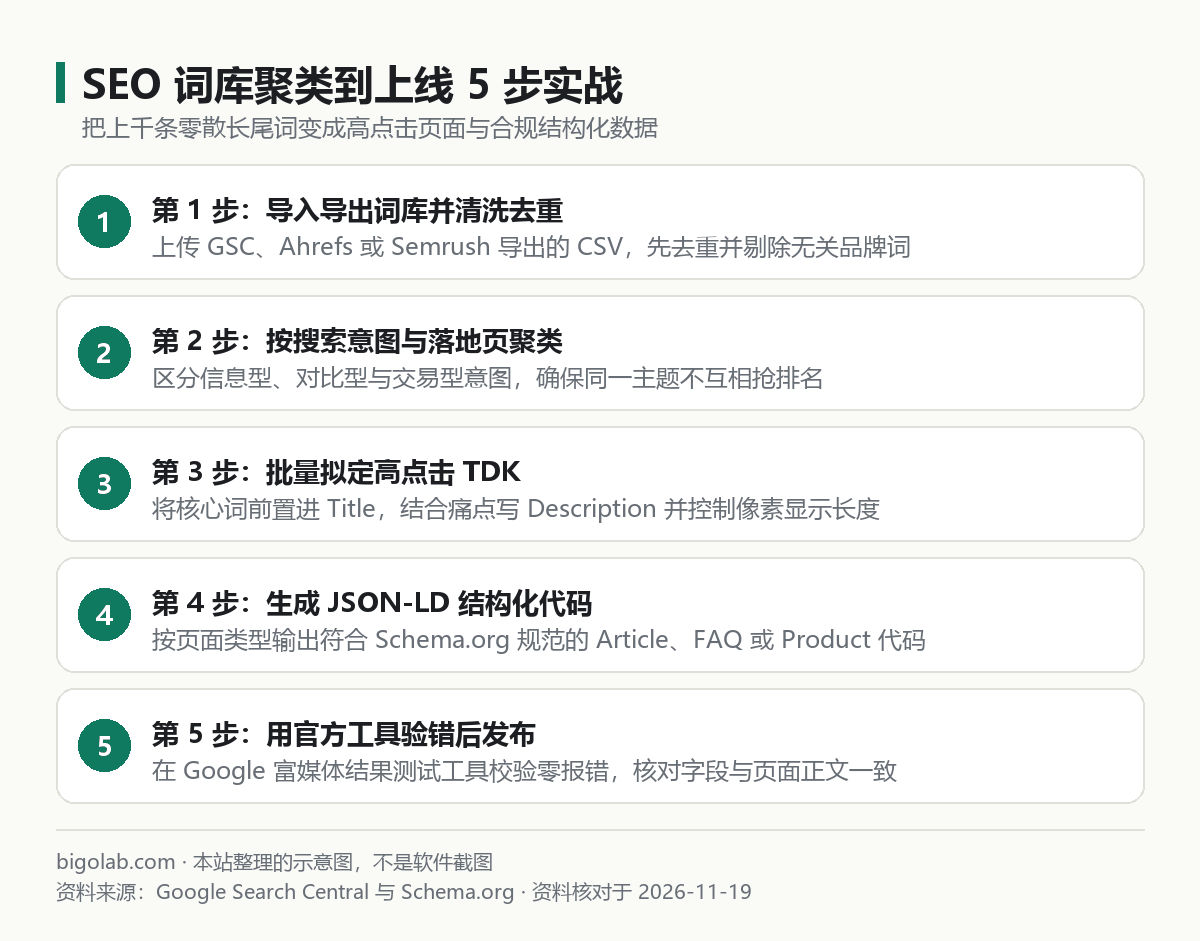
圖:本站根據 Google Search Central 與 Schema.org 整理的示意圖
本文根據 Google Search Central《Intro to Structured Data Markup》《Influencing your title links in search results》及 Schema.org《Getting Started》整理,資料核對於 2026-11-19。配圖為本站整理的示意圖,不是介面截圖。本站(bigolab.com)不是 OpenAI 官方網站。
適用於誰
- 跨境獨立站(Shopify / WooCommerce / Next.js)運營與站長,手頭從 Google Search Console、Semrush 或 Ahrefs 導出了上千條關鍵詞表,卻不知道怎麼合理拆分成專題頁與網誌選題的人;
- 內容營銷與 SEO 編輯,每週要批量起草幾十個頁面的標題(Title)、元描述(Description)和 URL Slug,希望既符合搜尋意圖又能提升自然點擊率的人;
- 不熟悉前端代碼的獨立站維護者,想為商品頁、教學頁和麵包屑導航添加規範的 Schema JSON-LD 代碼,但又怕手寫漏掉逗號或字段導致富媒體檢驗報錯的人。
一、第一步:上載關鍵詞 CSV,按搜尋意圖批量聚類防內耗
從工具導出 keywords_raw.csv(通常含關鍵詞、月搜尋量、難度 KD、當前排名等列)後直接上載給 ChatGPT,結合 ChatGPT 分析 Excel 數據實戰 的思路,讓 Python 先清洗再做語義聚類:
text
我上載了一份站內與競品關鍵詞詞庫 `keywords_raw.csv`(含字段:Keyword、Monthly_Volume、KD)。
我的站點定位是:【例如:面向北美買家的便攜式咖啡機獨立站與衝煮教學網誌】。

請先用 Python 去除完全重複詞、統一小寫並過濾掉明顯無關的品牌詞,然後按以下規則完成關鍵詞聚類並導出可下載的 `seo_keyword_clusters.xlsx`:
1. 將共享同一核心搜尋意圖、適合由「同一個落地頁」承接的詞歸為同一個 Cluster(每組指定 1 個搜尋量或代表性最高的 Primary Keyword 與若干 Secondary Keywords);
2. 為每個 Cluster 標註:
   - 搜尋意圖(Informational 資訊型 / Commercial 評測對比型 / Transactional 交易購買型)
   - 建議承接頁面類型(產品集合頁 / 單品詳情頁 / 對比評測文 / 實操教學文)
   - 建議英文短連結 URL Slug(全小寫連字符,不含無意義停用詞)
   - 組內總月搜尋量彙總與優先級(P0 高意圖低競爭 / P1 / P2)
3. 單獨增加一個 Sheet2「需排除或合併警示」,指出哪些詞容易與現有頁面發生主題重疊內耗。
導出 .xlsx 後若需同步到團隊排期表,可參考 ChatGPT 表格無損導入 Excel 方法。長期運營多個站點時,可以把品牌調性、禁用詞與站內已有 URL 清單放進專屬項目(見 ChatGPT Projects 項目功能教學),避免模型重複產出已寫過的選題。
二、第二步:批量撰寫符合搜尋規範的高點擊 TDK
現代搜尋引擎早已不靠 <meta name="keywords"> 排名(多數場景留空或僅用於內部標籤管理即可),真正影響收錄理解與自然點擊率(CTR)的是 <title>、<meta name="description"> 和頁面 <h1>。把聚類好的 P0 主題貼給 ChatGPT,執行這條 TDK 批量撰寫指令:
text
請根據下面這批頁面規劃(每行含:頁面類型|主關鍵詞|輔助詞|核心賣點與差異化),為每一頁撰寫高質素 SEO TDK 方案,輸出 Markdown 表格:
[在此粘貼 5 到 10 行規劃清單]

硬性規範:
1. Title(`<title>`):主關鍵詞盡量靠前自然出現,避免機械堆砌和重複品牌套話;中文嚴格控制在 24–30 字(英文 50–60 字符),且每頁結構必須有明顯區分;
2. Description(`<meta name="description">`):中文 70–85 字(英文 140–155 字符),講清「讀者點進來能拿到什麼具體清單、模板或價格/對比結論」,自然融入 1 個輔助詞,切忌空洞口號;
3. H1 主標題:與 `<title>` 主題一致但更適合頁面內自然閱讀,不必照抄品牌後綴;
4. 為每個高價值頁面額外提供 2 組備選 Title 角度(如「數字清單型」vs「避坑對比型」),方便後續在 GSC 觀察點擊率做迭代測試。額度與訂閱提示:做完整站百級頁面的關鍵詞聚類、分批撰寫 TDK 並反覆調試 JSON-LD 模板,單靠免費版很容易在半途遇到文件分析上限或降級到輕量化模型。國內無外幣卡用戶可通過本站 ChatGPT Plus 充值指南 或免交密碼的 ChatGPT Plus 卡密兌換 解鎖充足額度;跨境電商運營團隊多人共用詞庫與內容規劃規範,建議直接開通 ChatGPT Business 團隊版。
三、第三步:一鍵生成合規的 Schema JSON-LD 結構化數據
Google 搜尋中心官方推薦使用 JSON-LD 格式,通過 <script type="application/ld+json"> 嵌入頁面。手寫嵌套花括號極易漏逗號或拼錯 Schema.org 屬性名,直接把頁面真實資訊餵給 ChatGPT 生成並讓它先做 JSON 語法校驗(代碼核對技巧可結合 用 ChatGPT 寫代碼與預覽運行教學):
text
請為以下網頁生成完全符合 Schema.org 與 Google Search Central 規範的 JSON-LD 結構化數據腳本(輸出可直接放入 `<head>` 的完整 `<script type="application/ld+json">` 代碼塊):

頁面資訊(僅使用下方真實資訊,嚴禁編造任何未提供的評分、價格或評論數):
- 頁面類型:【Article 網誌教學 / Product 獨立站商品頁】
- 頁面 URL:https://example.com/guides/portable-espresso-guide
- 主標題:便攜式意式咖啡機選購與戶外萃取指南
- 摘要描述:對比 3 類戶外便攜咖啡機壓力結構與維護要點
- 作者姓名與作者頁 URL:Lin Chen / https://example.com/authors/lin-chen
- 發佈與更新日期(ISO 8601):2026-11-10 / 2026-11-19
- 封面圖 URL:https://example.com/images/espresso-cover.jpg
- 麵包屑路徑:首頁 -> 衝煮指南 -> 便攜咖啡機選購指南

要求:
1. 使用 `@graph` 將 `Article`(或 `Product`)與 `BreadcrumbList` 合併在同一個乾淨的 JSON-LD 塊中;
2. 所有日期嚴格帶時區偏移或標準 ISO 格式,圖片與連結均使用絕對 URL;
3. 用內置 Python `json.loads()` 校驗語法完全合法,並在代碼塊下方列出「上線前需替換的佔位字段檢查清單」。
如果全站需要批量給幾十篇文章生成結構化模板,可結合 ChatGPT 任務拆分與省額度技巧,先讓模型寫一段通用的 Jinja / Liquid / Next.js 動態模板代碼,一次配置全站複用,比手動逐篇粘貼省事得多。
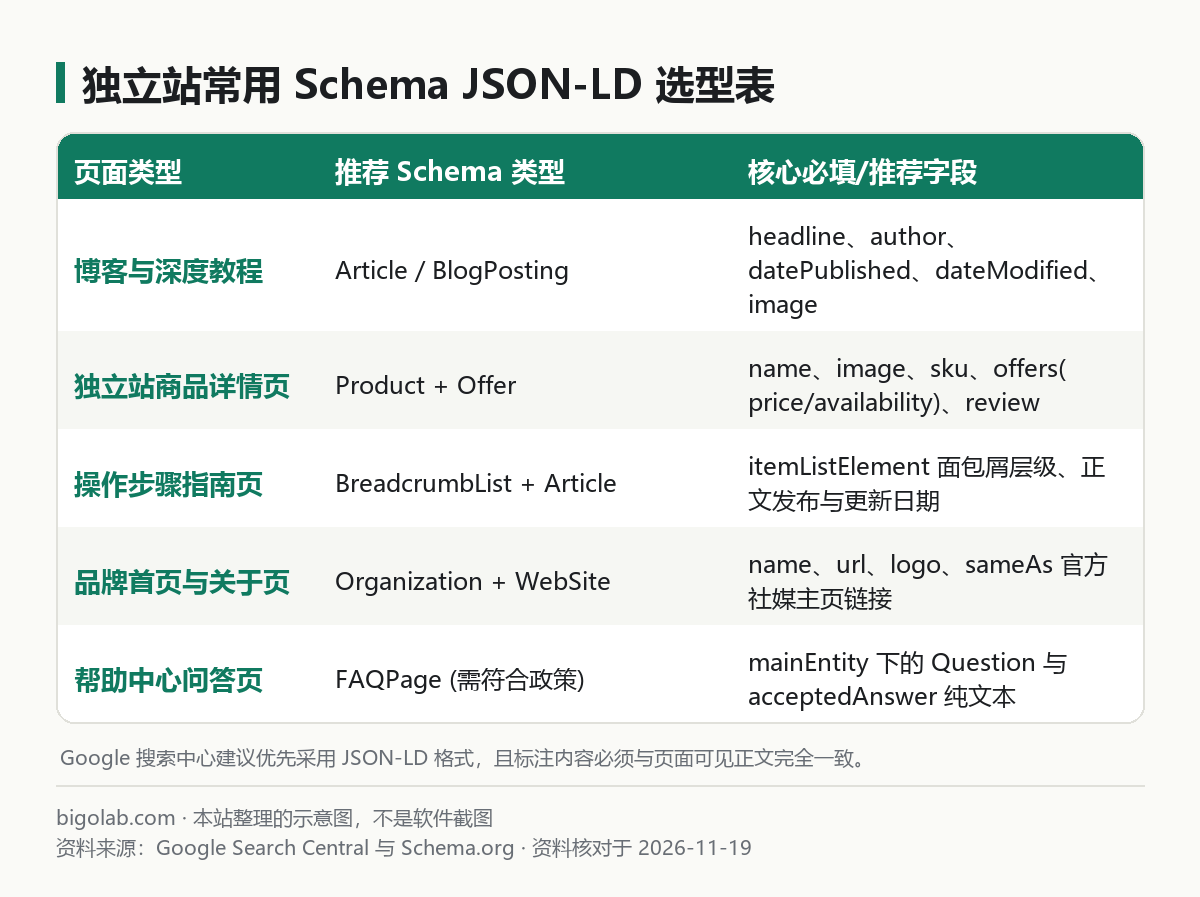
圖:本站根據 Google Search Central 與 Schema.org 整理的示意圖
常見問題
問:為什麼我寫好了 <title>,但 Google 搜尋結果頁裏展示的標題還是被自動改寫了?
答:根據 Google 官方標題連結說明,系統會綜合評估 <title>、<h1>、頁面顯眼大字和外部錨文本。如果 <title> 過長被截斷、塞滿重複關鍵詞、或與頁面 <h1> 嚴重不符,就更容易被改寫。保持 <title> 精煉準確並與 <h1> 高度一致,能顯著降低被改寫概率。
問:ChatGPT 生成的 JSON-LD 代碼直接貼進網站就能拿富媒體展示嗎?
答:語法合法只是第一步。上線前必須把代碼或測試連結放進 Google 官方 Rich Results Test(富媒體結果測試)和 Schema Markup Validator 檢驗零 Error,同時確保標註裏的價格、庫存、作者與正文肉眼可見資訊完全一致;即便完全合規,是否展示富媒體卡片仍由搜尋引擎算法結合站點質素決定。
問:可以讓 ChatGPT 直接替我生成全站 100 篇網誌全文並自動發佈嗎?
答:不建議純靠模板批量鋪設無增量資訊的文章。ChatGPT 最適合承擔「詞庫聚類、大綱結構設計、競品缺口梳理、TDK 打磨與 JSON-LD 生成」,正文環節必須注入你的真實產品對比數據、原創實拍圖、一線踩坑經驗與專業審核,長期排名才能穩住。
問:國內沒有外幣卡,怎麼穩定開通 ChatGPT Plus / Pro 或團隊版以解鎖多文件上載與高階模型?
答:可通過本站 AI 會員充值總覽 進入 ChatGPT Plus 充值頁 或直接下單 ChatGPT Plus 會員直充,獲得充足的 CSV 詞庫 Python 聚類分析與結構化代碼生成額度;管理多語種大型獨立站矩陣的重度 SEO 從業者,也可以升級 ChatGPT Pro 充值方案。支持支付寶、微信支付及 AlipayHK。實時價格以頁面展示為準;訂閱期內若掉訂閱按剩餘天數折退,因違反官方條款導致的封號不在質保範圍內。
相關教學
- ChatGPT 分析 Excel 數據:上載表格、清洗、透視與出圖(附可複製提問)
- ChatGPT 生成的表格複製到 Excel 串行、公式變純文本怎麼辦:直接生成 .xlsx 文件與無損粘貼方法
- 用 ChatGPT 寫代碼怎麼用:代碼塊的複製、編輯、預覽、運行 Python,報錯了怎麼辦
- ChatGPT Work(工作模式)怎麼用最省額度:任務拆分、中途糾偏與成品文檔/PPT/表格實戰
- ChatGPT 項目功能有什麼用、怎麼用(Projects 使用教學)
參考資料
- Google Search Central:Intro to Structured Data Markup — https://developers.google.com/search/docs/appearance/structured-data/intro-structured-data
- Google Search Central:Influencing your title links in search results — https://developers.google.com/search/docs/appearance/title-link
- Schema.org:Getting Started with schema.org — https://schema.org/docs/gs.html
0 條評論
還沒有評論,來搶沙發~