
結論先說
- 聊十幾輪就忘規矩不是偶然 Bug,而是「注意力稀釋 + 窗口滑出」的必然結果:普通聊天框裏的第一條消息只是普通曆史文本;隨着中間插進十幾輪問答、長文檔和修改指令,模型對最近幾輪的權重遠高於開頭,早期規則就會逐步失效;一旦總字數超出當前套餐上下文上限,開頭設定甚至會被徹底截斷(不同套餐上下文長度說明見 /guides/chatgpt-context-length-limits)。
- 最治本的招數是把鐵律搬出聊天框,放進 Projects 指令或自定義指令:寫入 Projects(項目) 專屬指令或 Custom Instructions 的規矩,每一輪都會以高優先級系統指令載入,不會因為多聊了二十輪就被擠出記憶。
- 不要在同一條對話裏死磕幾十輪,每 8–10 輪做一次「交接快照」換新窗:讓模型把已定規則和當前成果壓縮成 300 字狀態摘要,帶去全新對話第一條繼續幹活,效果比硬拖一條百輪長線程穩得多。
- 發現跑偏立刻「編輯上一條提問」,別順着錯誤連罵五輪:你在下面連續補五句「不對、不要這樣寫」,只會把錯誤示範和負面指令全塞進上下文,把模型越帶越糊塗。
- 需要更大上下文窗口、Projects 項目空間與更強長指令遵循模型的升級入口:免費版在上下文容量與高階推理配額上限制較緊,國內免外幣卡可通過本站用支付寶、微信支付或 AlipayHK 開通 ChatGPT Plus(Plus 自助充值卡密)或超大上下文與高配額的 ChatGPT Pro。
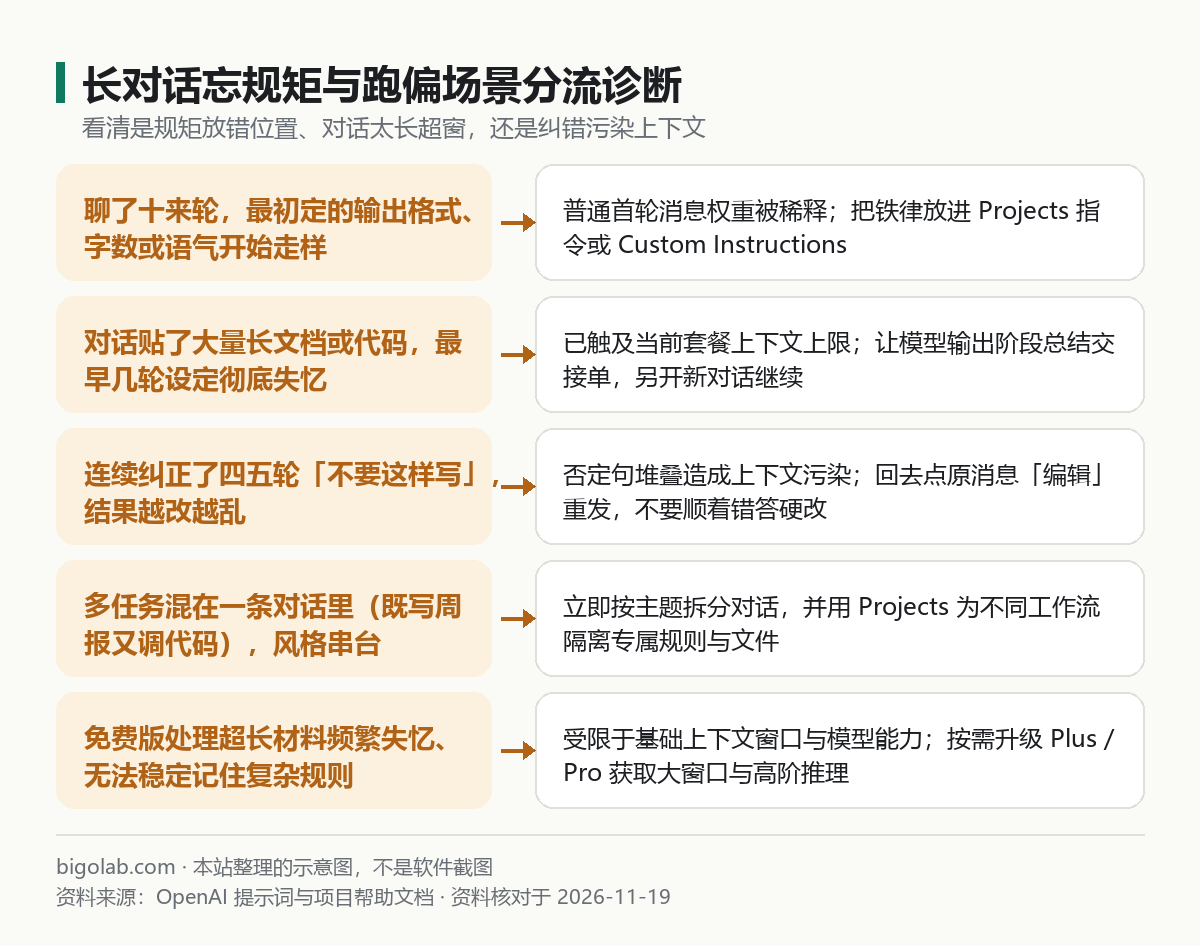
圖:本站根據 OpenAI 提示詞與項目文檔 整理的分流診斷圖
本文根據 OpenAI 幫助中心《Prompt engineering best practices for ChatGPT》《ChatGPT Custom Instructions》《Projects in ChatGPT》《Memory FAQ》整理,資料核對於 2026-11-19。配圖為本站整理的示意圖,不是介面截圖。本站(bigolab.com)不是 OpenAI 官方網站。
適用於誰
- 在對話開頭仔細規定了「不準用翻譯腔、固定分三列輸出、不要編造數據」,聊了十幾輪之後發現 ChatGPT 徹底拋在腦後的職場與寫作者;
- 用同一條對話連續改代碼、改方案或寫連載小說,越往後越答非所問、把前面已經敲定的設定改丟的用戶;
- 想知道這是免費版上下文太短還是自己提示詞用法不對,希望讓長任務始終穩穩聽話的高頻用戶。
一、為什麼 ChatGPT 聊到後面就會「失憶」和跑偏
把大模型的對話想象成一塊固定面積的白板:每聊一輪,白板上就會多寫一屏文字。當白板越寫越滿,兩個機制會同時拖垮最開始定下的規矩:
- 近因權重壓過早期約束:模型在生成下一句話時,更容易被最近兩三輪的語氣、結構和例子牽着走。如果第 1 輪要求「極簡幹練」,但第 8 輪你貼了一大段囉嗦的會議紀要,第 9 輪的輸出風格就會不自覺被紀要帶偏;
- 多輪返工製造「上下文污染」:連續要求修改 A 版、B 版、C 版後,歷史對話裏同時躺着多套互相矛盾的草稿,模型在檢索前文時極易把已經作廢的舊要求重新撿回來;
- 超過上下文窗口上限觸發硬截斷:特別是塞進了多份長 PDF、Excel 或整段代碼庫後,token 消耗極快,系統為保證還能繼續對話,只能把最早那幾輪包含核心規矩的文本裁掉。
二、4 招長對話防跑偏實戰技巧
下面四招既可以單獨用,也可以組合起來跑複雜項目。
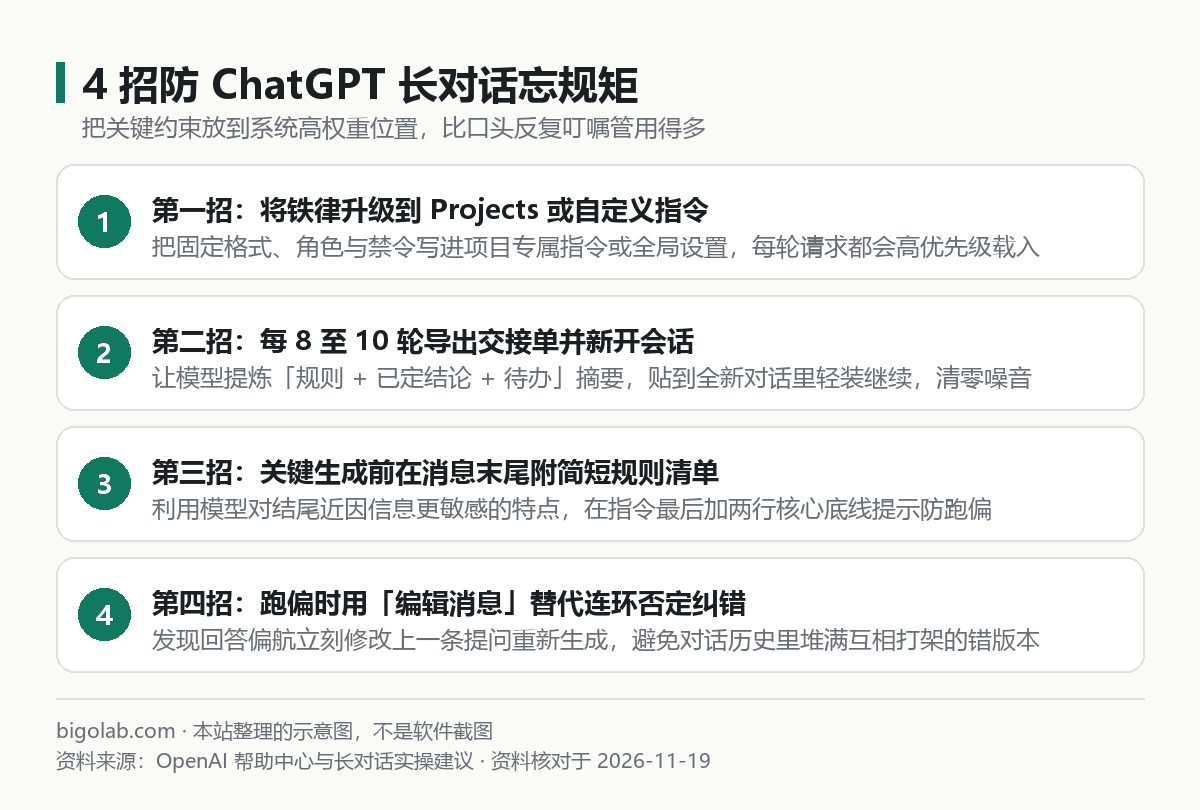
圖:本站根據 OpenAI 幫助中心文檔與高頻長對話實戰整理的步驟圖
1. 第一招:把鐵律抬升到 Projects 指令或自定義指令
如果你要連續幾天圍繞同一個產品、論文或客戶寫幾十條對話,千萬別把規則只發在普通對話框第一條。直接新建一個 Project(項目),把角色設定、禁止事項、術語表和範文填進「項目指令(Project Instructions)」,並將參考資料上載到項目文件區(完整用法見 /guides/chatgpt-projects)。如果是全帳號通用的偏好(如始終用中文、先給結論再分點),則直接寫入 Custom Instructions(配置教學見 /guides/chatgpt-custom-instructions)。
2. 第二招:每 8–10 輪導出「狀態交接單」,果斷新開對話
當一條對話已經完成了大綱確認、初稿寫作或幾輪需求變更,別繼續往下硬疊。直接發下面這段交接模板:
text
請將我們截至目前的合作壓縮為一份 400 字以內的「任務交接單」,必須包含:
1. 不可違背的硬規則(語氣、格式、禁用項);
2. 已經確認鎖定的核心結論與參數;
3. 下一步唯一待辦任務。
不要保留已經作廢的舊草稿。拿到這份乾淨交接單後,直接點左上角開一條全新對話把它貼進去繼續幹活,上下文瞬間回到巔峰狀態。
3. 第三招:關鍵輸出前,在消息最末尾掛一行「微型規則錨點」
當你終於聊到最核心的一步(比如要輸出最終交付稿或關鍵代碼),哪怕前面已經說過規矩,也建議在本次消息最後順手附上一行 30 字的底線提醒,例如:「底線覆核:嚴格用 3 列 Markdown 表格輸出,不編造未提供數字,總字數控制在 600 字內」。把硬約束放在當前提示詞末尾,能直接利用模型的近因注意力把格式牢牢鎖死。
4. 第四招:發現跑偏立刻「編輯消息」分叉,拒絕連環否定
一旦發現某輪輸出違背了核心規則,不要在下面接着回「你又忘了,我剛才說了不要用英文……」。直接把滑鼠移到你上一條提問處點擊編輯(Edit),把漏說的條件補進去重新生成——這樣錯誤回答會徹底從當前分支抹掉,不會留在上下文裏繼續誘導模型犯錯。
開通與排障提示:長文項目、代碼架構推演與多文件對比非常吃上下文窗口和指令遵循穩定性。國內免外幣卡升級可選購本站 Plus 信用卡通道卡密 或 Plus 卡密自助兌換,解鎖 Projects 與更大上下文;需要超長上下文與最高配額推理的用戶可升級 Pro 5x 空白號檔。
三、三類持久化規則工具怎麼選
| 工具位置 | 生效範圍 | 最適合放什麼內容 |
|---|---|---|
| Custom Instructions(自定義指令) | 全帳號所有新對話 | 個人職業背景、固定語言、通用排版偏好 |
| Projects(項目指令 + 項目文件) | 單個項目內所有對話 | 某本書大綱、固定品牌調性、項目術語表與規範 |
| Memory(跨對話記憶) | 由模型自動或手動記住的關鍵事實 | 常用技術棧、個人長期目標、常住城市等碎片事實 |
如果頻繁撞到高階模型消息次數限制導致被迫回退到輕量模型,也會明顯感覺「突然變笨忘規矩」,對應週期重置與模型切換機制可看 /guides/chatgpt-reached-limit-of-messages-reset-upgrade。
常見問題
問:打開了「記憶(Memory)」功能,為什麼同一條長對話裏它還是會忘規矩?
答:Memory 偏向記錄跨對話的個人長期事實(例如你是前端工程師、喜歡簡潔回覆),不會自動把你單條臨時對話裏臨時定下的十幾條複雜格式要求全部持久化。想讓某一專項任務從頭到尾嚴守規矩,Projects 專屬指令遠比依賴自動 Memory 靠譜。
問:在對話中間突然發現模型回答質素斷崖下降、完全不守規矩,是什麼原因?
答:除了上下文太長被稀釋之外,最常見的原因是你的當前高階模型(例如主力推理模型)額度剛好用完,系統在後台悄悄自動降級成了基礎輕量模型。滑鼠懸停在回答底部查看當前實際生成模型名稱即可核實。
問:國內沒有外幣卡,或者升級 Pro 遇阻、擔心外幣卡扣費異常,怎麼安全開通 ChatGPT Plus / Pro / Business?
答:可直接進入本站 AI 會員充值總覽,支持支付寶、微信支付與 AlipayHK 獲取卡密自助兌換 ChatGPT Plus 或高配額 ChatGPT Pro,團隊共享項目與統一報銷可選 ChatGPT Business 團隊方案。全程免交帳號密碼,支持開具國內增值稅發票(標價不含稅,另付 6% 稅費);實時價格與售後邊界(訂閱期內非自身原因掉訂閱按剩餘天數折退,封號不在質保範圍)以對應商品頁展示為準。
相關教學
- ChatGPT 上下文長度限制詳解:各套餐窗口大小與超長處理方法
- ChatGPT 自定義指令(Custom Instructions)完整配置教學
- ChatGPT Projects(項目文件夾)怎麼用:統一管理指令、對話與文件
- ChatGPT 提示已達消息上限怎麼辦:額度重置週期與升級建議
0 條評論
還沒有評論,來搶沙發~