
結論先說
- 絕不讓 Codex 直接連生產庫寫並跑腳本,先把「表結構 DDL + 清洗規則 + 脫敏樣本」整理成輸入契約。敏感數據庫連接串必須通過環境策略與權限檔案隔離(配置參考 /guides/codex-permission-profiles-block-env-config 與 /guides/codex-shell-environment-policy-filter-secrets),在本地或隔離測試庫完成全部驗證。
- 合格的數據遷移腳本必須同時具備三道保命機制:幹跑模式(
--dry-run)、SQL 級冪等寫入與遊標斷點續跑。幹跑負責提前暴露異常行與受影響行數;冪等保證重跑不會翻倍插數;斷點續跑讓百萬級任務中斷後從上一批成功位置接着跑。 - 分批拉取一律用主鍵遊標(
WHERE id > last_id ORDER BY id LIMIT N),禁用OFFSET深分頁。深分頁越往後越慢,且在邊遷移邊寫入的場景下容易漏行或重複掃描;每批控制在 500–2000 行並在單批事務內提交,既穩內存又不長時間鎖表。 - 把「異常髒數據分流到死信文件(Dead-Letter)」寫進提示詞。遇到非法手機號、壞 JSON 或缺失外鍵時,記錄主鍵與失敗原因後繼續推進或按閾值中止,絕不靜默丟棄數據,也不要因為 1 條壞記錄讓 50 萬行任務反覆回滾。
- 在反覆迭代清洗規則、補全邊界單測並審閱遷移 SQL 差異時,上下文消耗會明顯抬升。國內缺少外幣卡的開發者可在本站自助開通 ChatGPT Plus 充值 或無 5 小時限額的 ChatGPT Pro 充值,多人數據研發團隊可諮詢 ChatGPT Business 團隊定製。
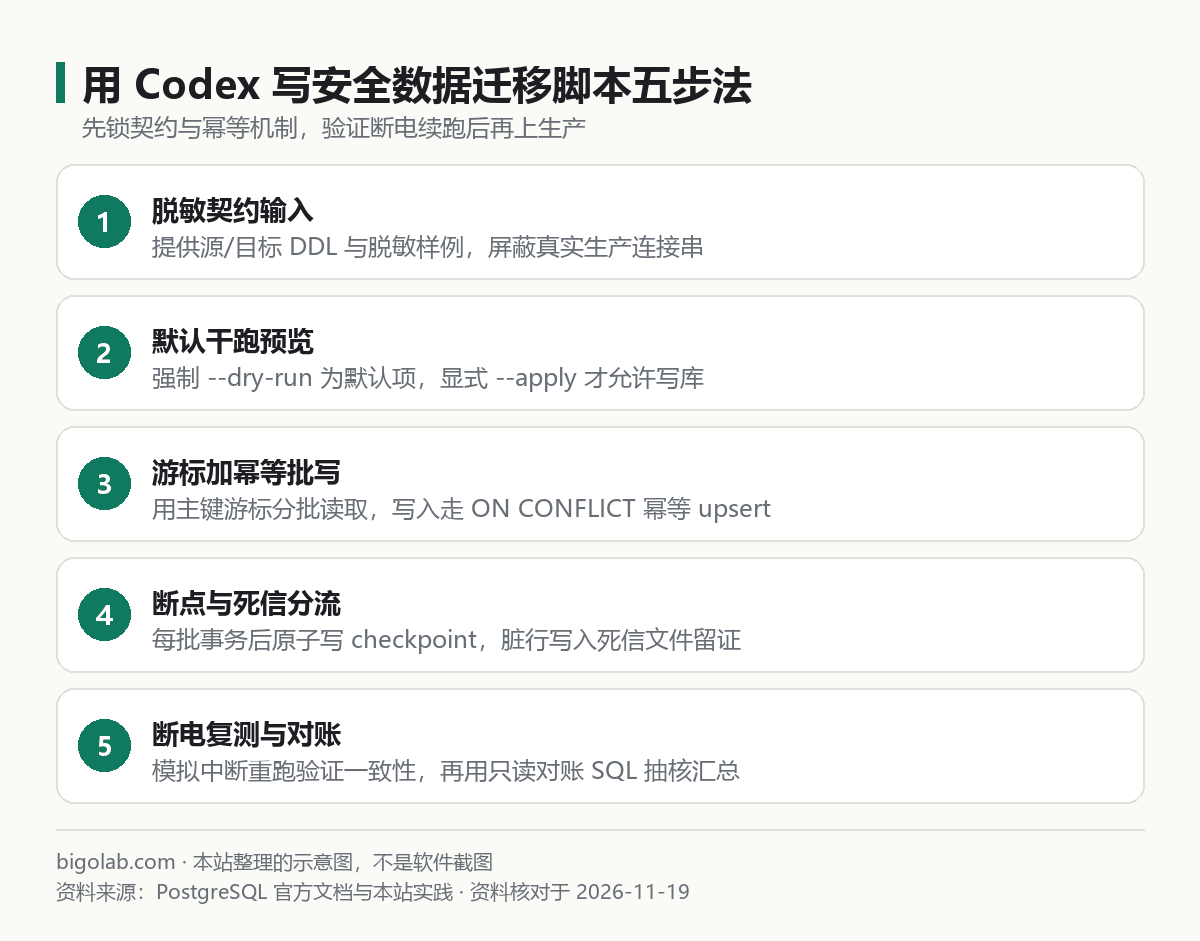
圖:本站結合數據遷移工程實踐與 PostgreSQL 事務機制整理的流程圖
本文根據 OpenAI Codex 官方文檔《Codex CLI》《Non-interactive mode》及 PostgreSQL 官方文檔《INSERT》《Transactions》整理,資料核對於 2026-11-19。配圖為本站整理的示意圖,不是介面截圖。本站(bigolab.com)不是 OpenAI 官方網站。
適用於誰
- 需要編寫一次性或週期性歷史數據遷移、字段拆表、髒數據清洗腳本的後端工程師與數據研發;
- 曾讓 AI 寫出「一把
SELECT *全拉進內存、循環INSERT沒加事務與去重」的腳本,跑一半中斷後不敢重跑的開發者; - 希望在執行高風險庫表變更前,先用脫敏樣本做幹跑預覽和核對報告的技術負責人。
一、先定安全契約:給 Codex 的高可靠腳本生成提示詞
直接說「幫我寫個 Python 腳本把舊訂單表洗到新表」,Codex 往往只會給你一份最簡循環演示代碼。本站建議先導出源表與目標表的精簡 DDL(不含生產數據)和 5 條脫敏樣例,用下面這份結構化提示詞一次性把架構立穩:
text
請基於 schema/source_orders.sql 和 schema/target_orders.sql 編寫一個 Python 數據遷移與清洗腳本 scripts/migrate_orders.py,嚴格滿足以下工程要求:
1. 命令行參數:支持 --dry-run(預設開啟,必須顯式傳 --apply 才真實落庫)、--batch-size(預設 1000)、--checkpoint-file、--dead-letter-file、--sleep-ms(批次間隔防打滿數據庫 IOPS);
2. 分批與斷點續跑:按主鍵自增遊標 `WHERE id > %s ORDER BY id ASC LIMIT %s` 讀取,禁止使用 OFFSET;每批事務提交成功後,原子寫入(臨時文件 + rename)checkpoint JSON(記錄 last_id、已處理數、跳過數、失敗數);
3. 冪等寫入:目標庫寫入必須採用參數化批量 UPSERT(PostgreSQL 用 INSERT ... ON CONFLICT (legacy_order_id) DO UPDATE SET ...,或 MySQL ON DUPLICATE KEY UPDATE),確保同一批次重複執行結果完全一致;
4. 髒數據與重試:清洗函數純函數化,無法解析的行寫入 dead-letter CSV(含原 id 與錯誤原因);僅對可恢復的網絡抖動或死鎖錯誤做指數退避重試(最多 3 次);
5. 幹跑校驗報告:--dry-run 模式下不提交寫事務,輸出預計新增/更新行數、清洗規則命中統計與前 10 條異常樣本摘要。
同時編寫對應的單元測試,覆蓋「中途異常中斷後重跑續接」「同批次重複運行冪等性」和「髒數據分流」。
核心 SQL 冪等與遊標寫法核對點
Codex 生成代碼後,人工重點核對以下兩段核心 SQL 是否寫對(不要只看代碼能跑):
sql
-- 1. 鍵集遊標分頁(穩定且走主鍵索引,絕不用 OFFSET)
SELECT id, raw_phone, payload_json, updated_at
FROM legacy_orders
WHERE id > %(last_id)s
ORDER BY id ASC
LIMIT %(batch_size)s;

-- 2. PostgreSQL 冪等批寫(確保重跑不產生重複記錄)
INSERT INTO orders_v2 (legacy_order_id, normalized_phone, amount_cents, migrated_at)
VALUES (%s, %s, %s, NOW())
ON CONFLICT (legacy_order_id) DO UPDATE
SET normalized_phone = EXCLUDED.normalized_phone,
    amount_cents = EXCLUDED.amount_cents,
    migrated_at = EXCLUDED.migrated_at
WHERE orders_v2.normalized_phone IS DISTINCT FROM EXCLUDED.normalized_phone
   OR orders_v2.amount_cents IS DISTINCT FROM EXCLUDED.amount_cents;
注意 ON CONFLICT ... DO UPDATE 末尾加上 WHERE ... IS DISTINCT FROM ... 後,重跑已完全對齊的行時數據庫不會產生無意義的死元組與額外 WAL 膨脹,對大表非常友好。
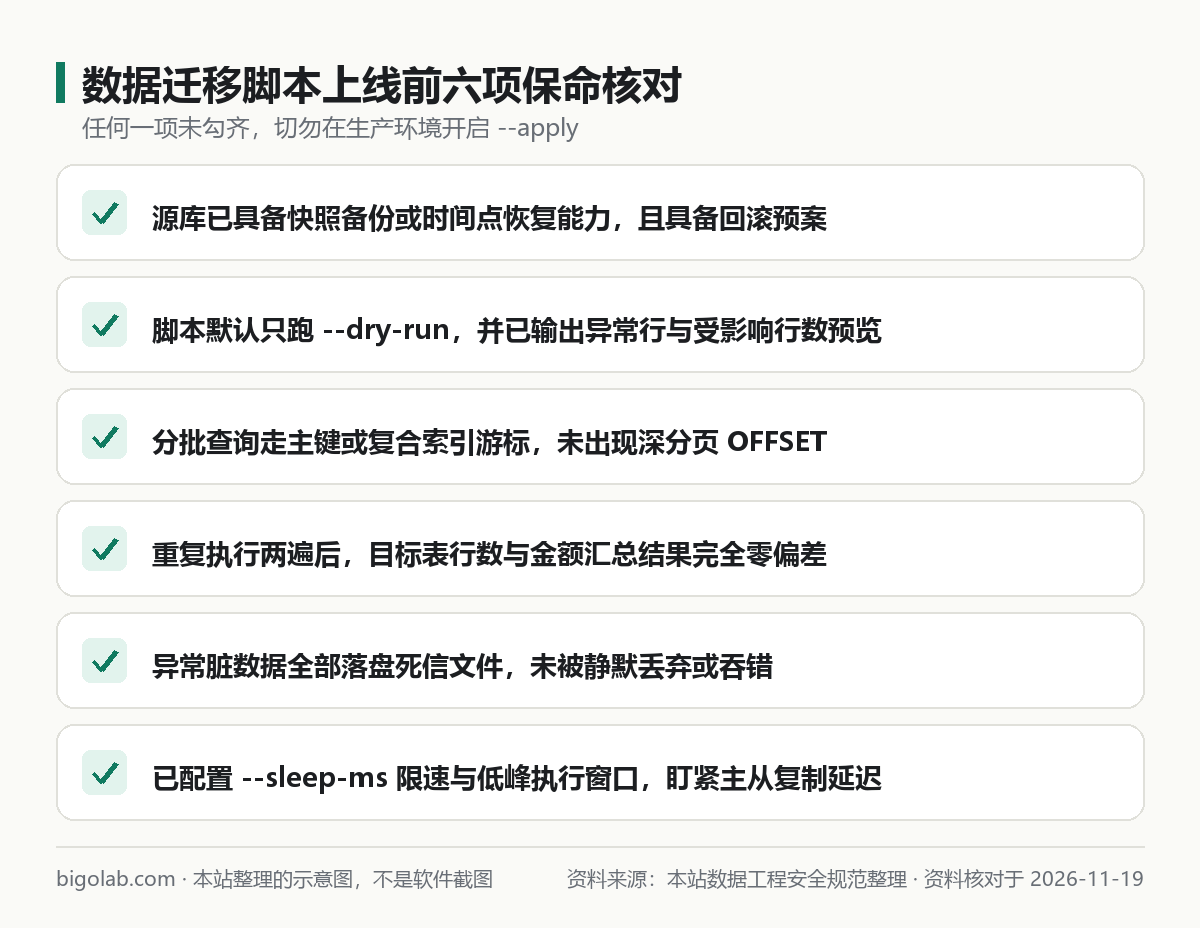
圖:本站結合數據庫變更安全規範整理的上線前核對示意圖
訂閱與帳號準備提示:處理多表聯查遷移、複雜字段映射與全套異常回歸測試時,經常需要多輪生成與只讀審計(配額規則見 /guides/codex-usage-limits)。高頻做數據治理的研發人員可在站內升級 ChatGPT Pro 5x iOS 可覆蓋檔 或 ChatGPT Pro 5x 信用卡不可覆蓋檔;新帳號首次開通 Codex 如在手機驗證步驟受阻,可查看 Codex 註冊手機驗證服務。
二、先測再跑:讓 Codex 補齊「模擬斷電重跑」與核對 SQL
寫完腳本後,不要只在 3 條正常樣例上跑通就上線。讓 Codex 基於本地 SQLite 或隔離 PostgreSQL 測試容器補三類關鍵校驗(測試防偷懶原則見 /guides/codex-generate-unit-tests-playwright-e2e-avoid-fake-mocks):
- 斷電續跑測試:人為在第 2 批中間拋一次連接異常,確認 checkpoint 仍停在第 1 批末尾;移除異常後重跑,驗證最終目標表總行數與無中斷跑完完全一致。
- 雙跑冪等測試:把全量遷移腳本連續執行兩遍,斷言目標表行數、關鍵金額彙總(
SUM(amount_cents))與哈希摘要在兩遍之間零變化。 - 遷移後對帳 SQL(Reconciliation):讓 Codex 同步生成一段只讀對帳腳本,自動比對源表與目標表的「總行數 − 死信行數」、關鍵指標加總(金額/積分)以及隨機抽樣 100 條記錄的逐字段差異。
若需要把數據核對腳本掛進定時或預發流水線,務必採用只讀與無痕方式調用 codex exec --ephemeral --sandbox read-only 審閱對帳報告(流水線規範參考 /guides/codex-exec-full-auto-ephemeral-ci-pipeline-guide)。
常見問題
問:源表沒有單調自增整數主鍵,用的是 UUID 主鍵怎麼辦?
答:千萬不要直接對隨機 UUID 做普通分頁後期待按時間增量。可以讓 Codex 改成基於 (created_at, id) 複合鍵集遊標分頁(如 WHERE (created_at, id) > (%s, %s) ORDER BY created_at, id LIMIT %s),並提前在測試庫核實源表是否存在對應的複合索引。
問:幹跑校驗通過了,在生產環境真正跑幾百萬行數據時還需要注意什麼?
答:先做庫表備份或確認時間點恢復(PITR)可用;其次用小批次加 --sleep-ms 限速,避開業務高峰並盯緊主從複製延遲(Replication Lag)與連接池水位;最後務必先在生產只抽前 1000 行試跑對帳,確認無誤再放開全量。
問:國內沒有外幣信用卡,或者公司研發團隊需要開增值稅發票報銷,怎麼開通適合寫工程腳本的 Codex 訂閱?
答:可通過本站 AI 會員充值總覽 按需選購 ChatGPT Plus 充值、ChatGPT Plus 自助卡密 或更高配額的 ChatGPT Pro 充值,支持支付寶、微信支付及 AlipayHK,提供卡密自助兌換(無需交出帳號密碼)與客服協助,並支持開具增值稅發票;多人團隊也可諮詢 Business 團隊定製方案。實時價格以商品頁展示為準,售後執行掉訂閱按剩餘天數折退、封號不在質保範圍規則。
相關教學
- 用 Codex 生成單元測試與 Playwright E2E:避免虛假 Mock 指南
- Codex 權限檔案防讀 .env 與敏感配置文件實戰
- Codex shell_environment_policy 過濾敏感環境變量防泄密指南
- Codex codex exec --full-auto 遷移與 --ephemeral 無痕 CI 流水線指南
- Codex 額度與使用限制:Plus / Pro 能用多少與怎麼查
參考資料
- OpenAI Codex 官方文檔:Codex CLI — https://learn.chatgpt.com/docs/codex/cli
- OpenAI Codex 官方文檔:Non-interactive mode — https://learn.chatgpt.com/docs/non-interactive-mode
- PostgreSQL 官方文檔:INSERT(ON CONFLICT 冪等寫入)— https://www.postgresql.org/docs/current/sql-insert.html
- PostgreSQL 官方文檔:Transactions — https://www.postgresql.org/docs/current/tutorial-transactions.html
0 條評論
還沒有評論,來搶沙發~