
結論先說
- 上下文爆窗的頭號元兇往往不是業務源碼,而是鎖文件、產物目錄和整屏終端輸出。一個幾兆的
package-lock.json、一份打包後的dist/*.js或一次打印數萬行的單測日誌,只要被工具原樣讀進上下文,一兩步就能吃掉大半窗口並顯著拖慢推理。 - 用
.gitignore管未入庫大目錄,用.ignore擋已入庫鎖文件。Codex 底層檢索依賴ripgrep等工具時預設尊重.gitignore,確保node_modules/、dist/、.next/、target/已正確寫入.gitignore;而必須提交到 Git 的package-lock.json、yarn.lock等文件,可在項目根放一個.ignore文件讓搜尋工具自動跳過(本站建議)。 - 在
config.toml裏設好tool_output_token_limit與model_auto_compact_token_limit硬閘門。即使模型偶爾執行了輸出很長的命令,限制單次工具返回 Token 上限也能防止一次失誤直接把整場會話撐爆。 - 在
AGENTS.md明文寫死「禁止全量讀取鎖文件與編譯產物」。規則說明加硬性權限/截斷限制雙管齊下,能把日常任務消耗的上下文壓低一大截。 - 在大型倉庫持續做多輪重構與測試,合理優化上下文之餘也需備好充足訂閱檔位。國內若無外幣卡,可在本站自助開通 ChatGPT Plus 或高配額 ChatGPT Pro,團隊多人部署也可了解 ChatGPT Business 團隊定製。
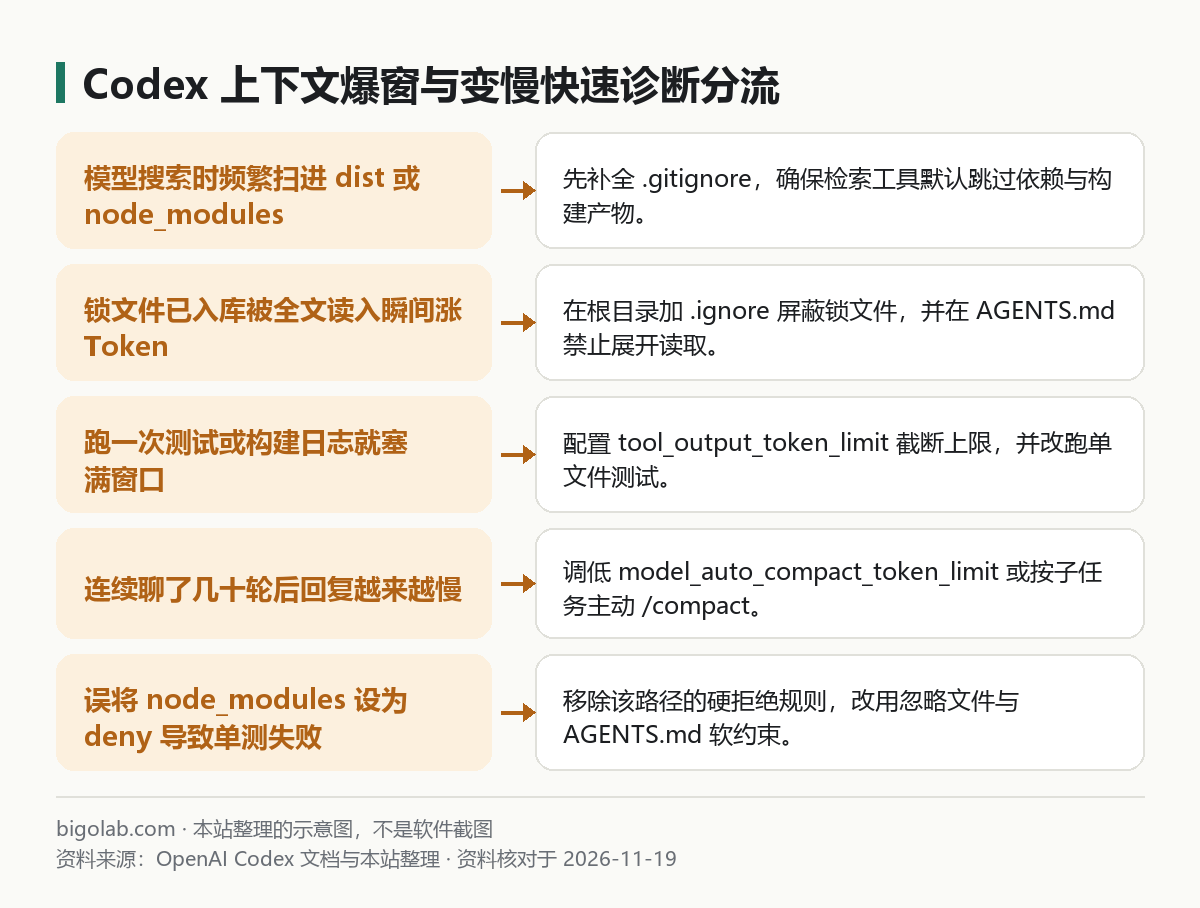
圖:本站根據 OpenAI Codex 官方文檔:Configuration Reference 整理的示意圖
本文根據 OpenAI Codex 官方文檔《Configuration Reference》《Custom instructions with AGENTS.md》整理,資料核對於 2026-11-19。配圖為本站整理的示意圖,不是介面截圖。本站(bigolab.com)不是 OpenAI 官方網站。
適用於誰
- 在前端、Node.js、Rust 或大型 Monorepo 項目裏跑 Codex,經常幾輪對話就遇到上下文爆窗、頻繁自動壓縮或明顯變慢的開發者;
- 發現模型檢索或閱讀文件時把
package-lock.json、pnpm-lock.yaml、dist/、coverage/或海量測試日誌灌進對話,導致額度消耗飛快的用戶; - 希望系統化落地「忽略規則 +
config.toml硬上限 + 提示詞收口」三層瘦身策略的研發團隊。
一、三層防爆窗實戰配置:從根源擋住垃圾 Token
想把大型倉庫裏的 Codex 響應速度和額度利用率拉滿(綜合省額策略可同步參考 /guides/codex-save-usage-quota-model-reasoning-context-tips),推薦按下面三層順序落地。
第 1 層:倉庫忽略文件(.gitignore + .ignore)
首先確認 .gitignore 完整覆蓋了所有依賴和構建緩存目錄(如 node_modules/、dist/、build/、.next/、.nuxt/、coverage/、target/、__pycache__/)。
真正的難點在於 鎖文件與靜態資源:package-lock.json、pnpm-lock.yaml、yarn.lock、Cargo.lock、.min.js、.map 往往因為工程需要已經提交進了 Git,不能寫進 .gitignore。這時可以在倉庫根目錄新建一個輕量 .ignore 文件(ripgrep 預設會自動識別 .ignore 並跳過其中的路徑,且不影響 Git 追蹤,屬於本站建議):
gitignore
# 讓檢索工具跳過已入庫的巨型鎖文件與壓縮產物
package-lock.json
pnpm-lock.yaml
yarn.lock
Cargo.lock
poetry.lock
**/*.min.js
**/*.min.css
**/*.map
**/__snapshots__/**
第 2 層:config.toml 配置 Token 截斷閘門與目錄隔離
打開 ~/.codex/config.toml(或受信任項目的 .codex/config.toml),配置單次工具輸出上限與自動壓縮閾值;如果希望從沙箱文件系統層面硬隔離某些不需要模型觸碰的超大數據或產物目錄,還可以結合新版 Permission Profiles(詳見 /guides/codex-permission-profiles-block-env-config):
toml
#:schema https://developers.openai.com/codex/config-schema.json

# 限制單次命令或工具輸出寫入上下文的 Token 上限,防巨型日誌瞬間撐爆窗口
tool_output_token_limit = 12000

# 適當提前自動壓縮觸發閾值,避免上下文滾雪球拖慢每輪推理(需小於模型總窗口)
model_auto_compact_token_limit = 64000

# 保持項目說明文件總讀取上限精簡(預設 32768 字節)
project_doc_max_bytes = 32768
若某些極大數據目錄(例如 datasets/、logs/、本地導出 dumps/)完全不需要 Codex 查看,也可在具名權限配置中將其設為 "deny":
toml
[permissions.slim-dev]
extends = ":workspace"

[permissions.slim-dev.filesystem.":workspace_roots"]
"**/node_modules/**" = "deny"
"**/dist/**" = "deny"
"**/logs/**" = "deny"
注意:如果你希望沙箱內執行的 npm test 正常讀取 node_modules,請不要在文件系統層把 node_modules 設為 "deny",否則測試進程自己也會找不到依賴;這種情況下請用 .gitignore + AGENTS.md 軟約束代替硬拒絕。
第 3 層:在 AGENTS.md 寫清搜尋與日誌節流規範
把下面幾條精簡規則放進項目根目錄 AGENTS.md(讀取機制見 /guides/codex-agents-md-how-it-reads),模型就會主動避開高開銷操作:
markdown
## 上下文與檢索約束
- 禁止讀取或全文打印 `node_modules/`、`dist/`、`coverage/` 及 `package-lock.json`、`pnpm-lock.yaml`、`yarn.lock` 等鎖文件。
- 排查依賴版本時僅讀取 `package.json` 或用精準關鍵字過濾,不要整文件展開。
- 運行測試或構建時優先只跑當前變更對應的單個測試文件,並使用精簡輸出參數(如 `--silent` 或只截取末尾失敗堆棧)。訂閱與帳號準備提示:即使做好了大目錄忽略,超大規模 Monorepo 與開啟超大上下文窗口(參考 /guides/codex-app-context-window-1m-setting)依然對帳戶配額提出更高要求(額度說明見 /guides/codex-usage-limits)。如果高頻觸頂,可在本站升級 ChatGPT Pro 充值 或 ChatGPT Pro 5x iOS 可覆蓋檔;新註冊帳號卡在手機號驗證步驟時,可查看 Codex 註冊手機驗證服務。
二、日常提速省額的六項自查清單(本站建議)
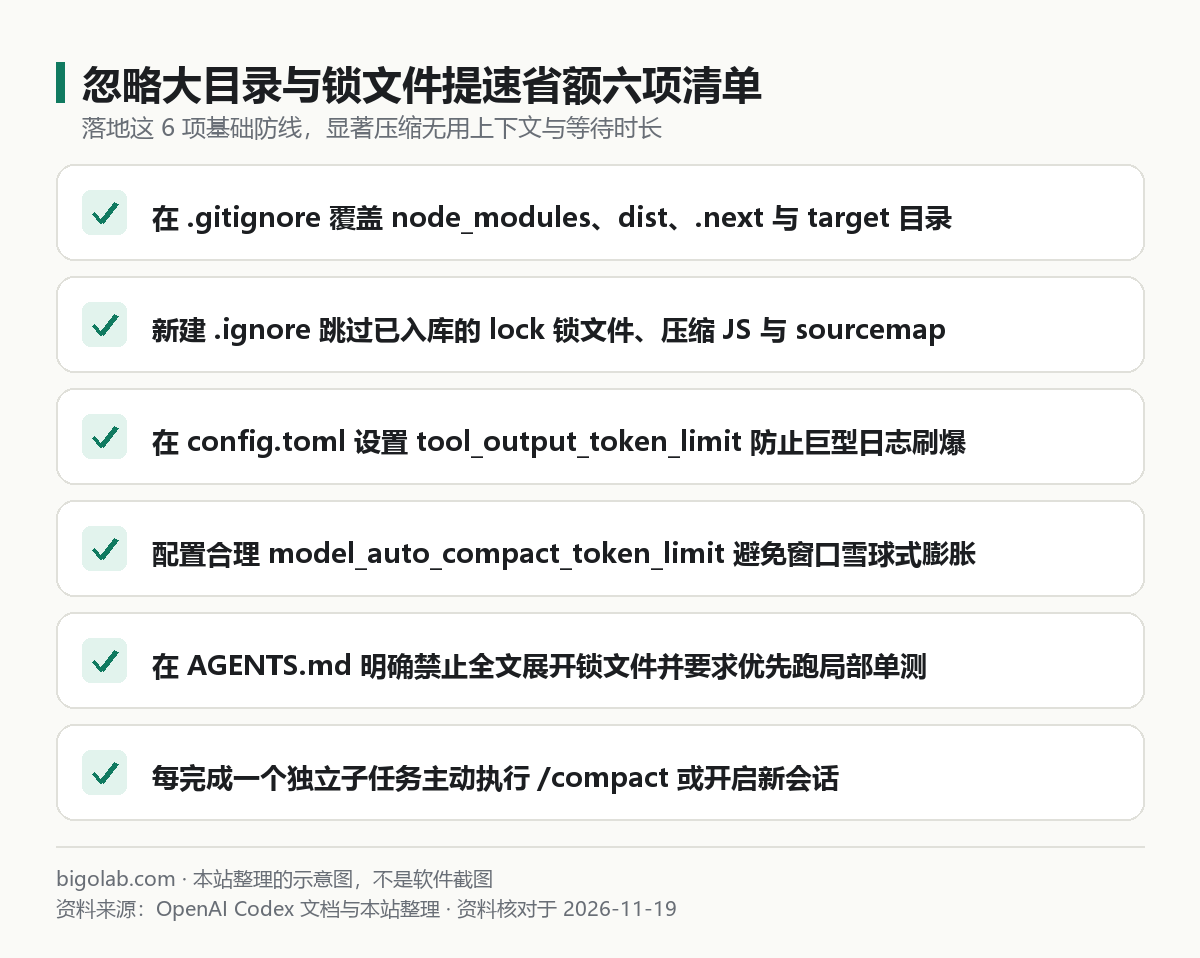
圖:本站根據 OpenAI Codex 官方文檔:AGENTS.md 整理的示意圖
日常提問時,把以下四個操作養成習慣,體驗提升最立竿見影:
- 提問先縮小目錄範圍:與其說「搜一下整個倉庫哪裏用了訂單狀態」,不如直接指明「僅在
src/modules/order/下排查訂單狀態枚舉」。 - 改完一個子任務主動
/compact或新開會話:不要把毫無關聯的三個需求塞進同一條几百輪的老會話裏(壓縮與回滾技巧見 /guides/codex-cli-diff-compact-rewind-rollback-guide)。 - 測試失敗只喂關鍵堆棧:讓 Codex 跑全套 E2E 測試往往吐出幾千行日誌,在提示詞里約定「只運行變更相關的單個 spec 並聚焦失敗斷言」能省下大量輸入 Token。
- 切勿直接把整份數據庫導出或線上原始日誌文件塞進倉庫根:大體積文本文件即使不改代碼,也極易被模糊搜尋意外掃中。
常見問題
問:為什麼把 node_modules 寫進權限配置文件的 "deny" 後,npm test 反而報錯找不到模組了?
答:Permission Profiles 的文件系統 "deny" 作用於整個沙箱進程樹,Node.js 運行測試時同樣無法讀取被拒絕的 node_modules。需要運行前端依賴的倉庫,應通過 .gitignore、.ignore 和 AGENTS.md 防止模型主動去讀,僅對真正不需要代碼進程訪問的離線大目錄(如 archives/、raw-dumps/)使用 "deny"。
問:把 tool_output_token_limit 調小之後,報錯堆棧被截斷看不全怎麼辦?
答:不要把它壓得過低(例如幾百 Token);本站建議設定在 8000 到 16000 左右,既能容下常規報錯堆棧和單測結果,又能有效擋住幾萬行的巨型輸出把整場上下文瞬間撐爆。
問:國內沒有外幣信用卡,或者公司研發團隊需要開增值稅發票報銷,怎麼開通能跑 Codex 的訂閱?
答:可在本站 AI 會員充值總覽 按需選購 ChatGPT Plus、ChatGPT Plus 官網直充 或高配額的 ChatGPT Pro,團隊多人統一部署可直接查看 ChatGPT Business 團隊定製。支持支付寶、微信支付與 AlipayHK,自助兌換無需交出帳號密碼,並可開具增值稅發票;實時價格以商品頁展示為準,售後執行掉訂閱按剩餘天數折退、封號不在質保範圍的政策。
相關教學
- Codex 節省額度的模型、推理檔位與上下文實用技巧
- Codex CLI /diff、/compact 與回滾操作完全指南
- Codex App 1M 超大上下文窗口配置說明
- Codex Permission Profiles 權限配置文件:屏蔽 .env 與最小權限實戰
參考資料
- OpenAI Developers 文檔:Codex Configuration Reference — https://developers.openai.com/codex/config-reference
- OpenAI Developers 文檔:Custom instructions with AGENTS.md — https://developers.openai.com/codex/guides/agents-md
- OpenAI Codex 官方文檔:Configuration Reference — https://learn.chatgpt.com/docs/config-file/config-reference
- OpenAI Codex GitHub 倉庫 — https://github.com/openai/codex
0 條評論
還沒有評論,來搶沙發~