
結論先說
- 用
persistence = "none"立即停止歷史落盤。在~/.codex/config.toml中增加[history]配置段並寫上persistence = "none",Codex 將不再向本地history.jsonl追加輸入與交互歷史記錄。 - 保留歷史但怕無限膨脹,用
max_bytes設硬上限。預設persistence = "save-all"且不設體積封頂;只要加上max_bytes = 10485760(10 MB),文件超限時 Codex 會自動淘汰最舊條目。 - 關閉
[history]不會自動抹掉已經存在的舊記錄。修改persistence = "none"隻影響後續新寫入,之前已落盤的history.jsonl仍留在磁盤上,敏感環境下必須手動清理歷史文件。 - 注意區分輸入歷史與完整會話歸檔。
[history]管轄的是history.jsonl本地歷史記錄;如果同時需要避免單次自動化任務留下會話恢復文件,應配合codex exec --ephemeral與定期會話清理策略。 - 在多項目裏穩定開展日常開發與合規審計需匹配合適會員檔位。國內若無外幣支付手段,可在本站自助開通 ChatGPT Plus 或配額更充裕的 ChatGPT Pro,團隊統一採購也可查看 ChatGPT Business 團隊定製。
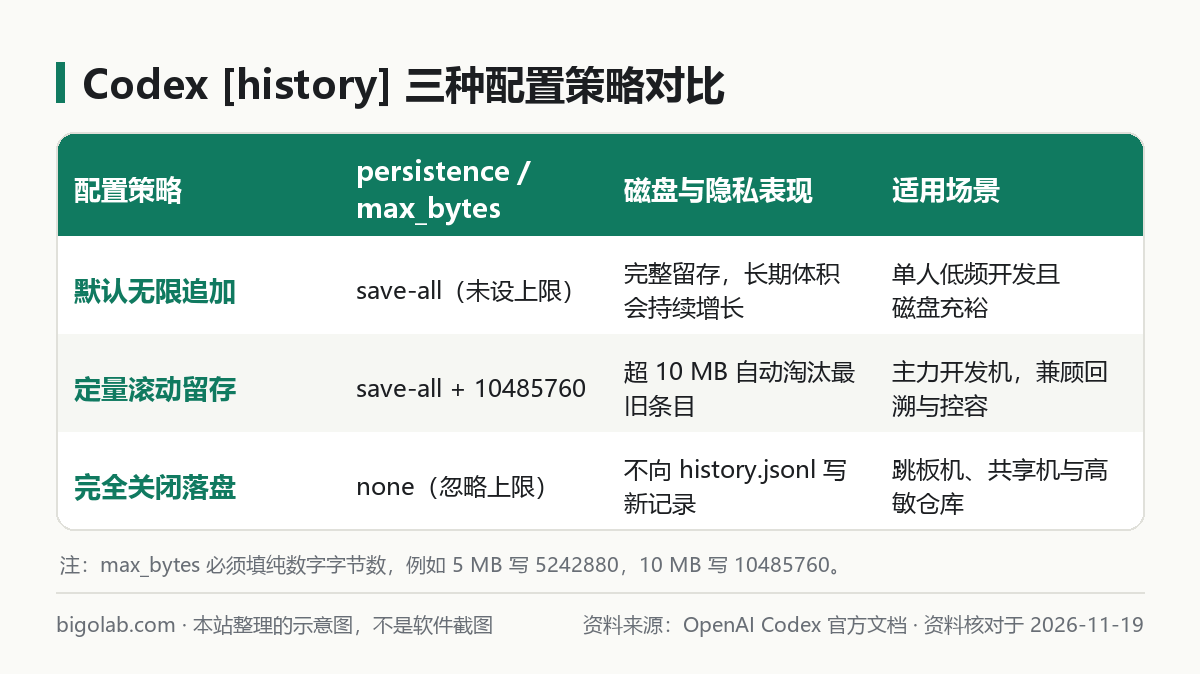
圖:本站根據 OpenAI Codex 官方文檔:Configuration Reference 整理的示意圖
本文根據 OpenAI Codex 官方文檔《Configuration Reference》整理,資料核對於 2026-11-19。配圖為本站整理的示意圖,不是介面截圖。本站(bigolab.com)不是 OpenAI 官方網站。
適用於誰
- 在多人共用開發機、遠程跳板機或客戶現場終端上跑 Codex,希望徹底關閉本地歷史落盤避免泄露提示詞的開發者;
- 長期高頻使用 Codex CLI,發現
~/.codex/history.jsonl持續增長、拖慢歷史檢索或佔用磁盤的用戶; - 需要為團隊制定統一日誌留存上限與本地數據最小化規範的研發負責人。
一、[history] 配置段字段詳解與適用場景
預設情況下,Codex CLI 會在 $CODEX_HOME(未單獨設定環境變量時為 ~/.codex,Windows 為 %USERPROFILE%\.codex)中寫入 history.jsonl,用來儲存提示詞輸入歷史,方便你在交互終端按上下方向鍵回溯或複用之前的指令(CODEX_HOME 隔離方法見 /guides/codex-cli-config-override-and-codex-home-isolation)。
在 config.toml 中,[history] 表提供兩個核心字段:
persistence:字符串枚舉,可選"save-all"(預設值,正常記錄本地歷史)或"none"(關閉歷史落盤,不向history.jsonl追加新條目);max_bytes:可選正整數,單位為字節(Byte)。當persistence = "save-all"且設定了max_bytes時,每次追加導致文件體積超過閾值,Codex 會自動丟棄最老的記錄並壓縮文件,確保磁盤佔用始終受控。
如果你的機器上經常粘貼包含業務 SQL、內網接口結構、排障堆棧的提示詞,又不想讓同機其他帳號或備份軟件掃走這些內容,就應該主動配置 [history],而不是一直沿用「無限追加」的預設狀態。
二、三套可直接複製的 config.toml 配置模板
打開 ~/.codex/config.toml(完整結構可參考 /guides/codex-config-toml-complete-guide),按自己的使用場景選擇對應寫法。
模板 1:個人主力開發機,保留歷史並限制在 10 MB 以內(本站建議)
日常開發既想保留方向鍵回溯歷史,又不想半年後文件漲到幾十兆,可以給 max_bytes 設一個合理閾值(例如 5 MB = 5242880,10 MB = 10485760):
toml
#:schema https://developers.openai.com/codex/config-schema.json

[history]
persistence = "save-all"
max_bytes = 10485760
模板 2:共享伺服器 / 高敏項目,徹底關閉歷史落盤
在跳板機、公共測試機或涉密項目目錄下,直接關閉持久化寫入:
toml
[history]
persistence = "none"
如果是臨時只對某一次會話禁止落盤,也可以通過命令行參數即時覆寫,不必改動全局配置:
bash
codex -c 'history.persistence="none"'
模板 3:配合 Profile 按項目切換留存策略
平時普通項目照常記錄,一進敏感倉庫就切到無痕配置檔:
toml
[history]
persistence = "save-all"
max_bytes = 10485760

[profiles.no-trace]
# 僅在使用 --profile no-trace 時關閉本地歷史落盤
[profiles.no-trace.history]
persistence = "none"訂閱與帳號準備提示:在長時間重構或批量巡檢代碼時,高頻多輪交互更容易觸達窗口配額(額度規則參考 /guides/codex-usage-limits)。若日常工作對持續響應要求高,可在本站升級 ChatGPT Pro 充值 或選擇 ChatGPT Pro 5x iOS 可覆蓋檔;新註冊 OpenAI 帳號在手機驗證環節受阻時,也可參考 Codex 註冊手機驗證服務。
三、關閉落盤後的私隱補漏清單(本站建議)
很多開發者以為改完 persistence = "none" 本地就徹底「零痕跡」了,實際排查時常常漏掉以下四個環節:
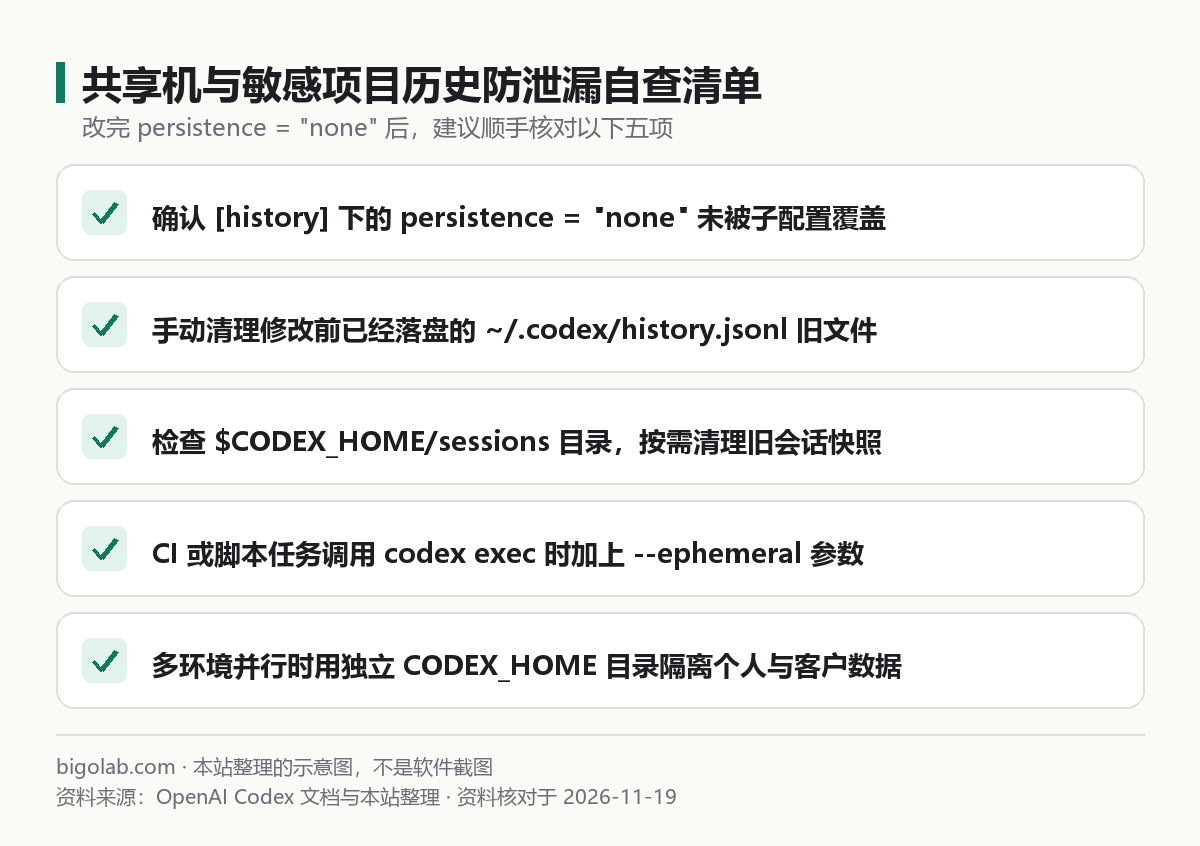
圖:本站根據 OpenAI Codex 官方文檔:Configuration Reference 整理的示意圖
- 手動清除舊
history.jsonl:把persistence改成"none"只會阻止新增記錄,不會刪掉已有文件。請在確認不再需要歷史記錄後手動刪除~/.codex/history.jsonl(若自定義過CODEX_HOME,需前往對應目錄清理)。 - 同步檢查會話恢復目錄:Codex 用於
codex resume的會話快照通常儲存在$CODEX_HOME/sessions/下。涉及敏感內容時,需要了解會話分支管理與清理機制(詳見 /guides/codex-fork-session-branching-parallel-guide 與 /guides/codex-tui-auto-recap-session-history-cleanup-guide)。 - CI 與腳本任務加
--ephemeral:在自動化流水線或無狀態容器裏調用codex exec時,建議配合--ephemeral參數運行(CI 流水線配置見 /guides/codex-exec-full-auto-ephemeral-ci-pipeline-guide),避免把大量一次性日誌會話堆滿工作節點磁盤。 - 不要把
max_bytes設得過小:如果把max_bytes設成幾百字節,單條長提示詞就會頻繁觸發截斷淘汰,失去保留歷史的意義;本站建議普通個人開發至少設定在 2 MB 到 10 MB 之間。
常見問題
問:設了 persistence = "none" 之後,還能在同一輪還沒退出的終端對話裏繼續追問嗎?
答:完全可以。[history] 控制的是本地磁盤上的歷史記錄持久化落盤,不影響當前活躍會話在內存裏的多輪上下文連續對話。
問:max_bytes 可以寫 "10MB" 這種帶單位的字符串嗎?
答:不行。max_bytes 在配置 Schema 中是整數類型,單位固定為字節,必須直接寫數字(例如 5 MB 寫 5242880,10 MB 寫 10485760),帶單位引號會導致 TOML 解析報錯。
問:國內沒有外幣信用卡,或者公司研發團隊需要開增值稅發票報銷,怎麼開通能跑 Codex 的訂閱?
答:可在本站 AI 會員充值總覽 按需選購 ChatGPT Plus、ChatGPT Plus 官網直充 或高配額的 ChatGPT Pro,團隊批量採購可直接查看 ChatGPT Business 團隊定製。支持支付寶、微信支付與 AlipayHK,自助兌換無需交出帳號密碼,並可開具增值稅發票;實時價格以商品頁展示為準,售後執行掉訂閱按剩餘天數折退、封號不在質保範圍的政策。
相關教學
- Codex TUI 自動回顧與本地會話歷史清理指南
- Codex exec 全自動與 --ephemeral 無狀態 CI 流水線指南
- Codex CLI 參數覆寫(-c)與 CODEX_HOME 多環境隔離教學
- Codex config.toml 配置文件完整指南
參考資料
- OpenAI Developers 文檔:Codex Configuration Reference — https://developers.openai.com/codex/config-reference
- OpenAI Codex 官方文檔:Configuration Reference — https://learn.chatgpt.com/docs/config-file/config-reference
- OpenAI Codex GitHub 倉庫 — https://github.com/openai/codex
0 條評論
還沒有評論,來搶沙發~