
結論先說
- 分叉(Fork)是把當前會話克隆出一條新支線,原主線完整凍結保留。與繼續在原記錄上追加的
codex resume不同,分叉會生成全新的SESSION_ID,無論新支線怎麼試錯,都不會污染原來的父會話。 - 終端外和會話內都有分叉入口。在正在聊的 TUI 窗口裏直接輸入
/fork就能就地分叉;在終端命令行則可以運行codex fork <SESSION_ID>精確分叉指定歷史線程,或用codex fork --last快速分叉最近一次會話。 - 要並行改代碼,必須隔離磁盤工作區。普通
/fork只隔離對話上下文,兩個會話仍指向同一份本地目錄;只有疊加--worktree啟動獨立託管 Git 工作樹(或手動建git worktree),才能讓兩套改法真正並行互不覆蓋。 - 用
--worktree分叉時建議顯式傳入SESSION_ID。不同 CLI 版本對--last與--worktree組合支持存在差異,直接指定會話編號或通過交互選擇器指定最穩妥。 - 同時跑多條分叉支線會線性增加模型調用次數與上下文消耗。國內若無外幣銀行卡或支付受阻,可在本站自助開通 ChatGPT Plus 或額度更充裕的 ChatGPT Pro,團隊多席位採購可了解 ChatGPT Business 團隊定製。
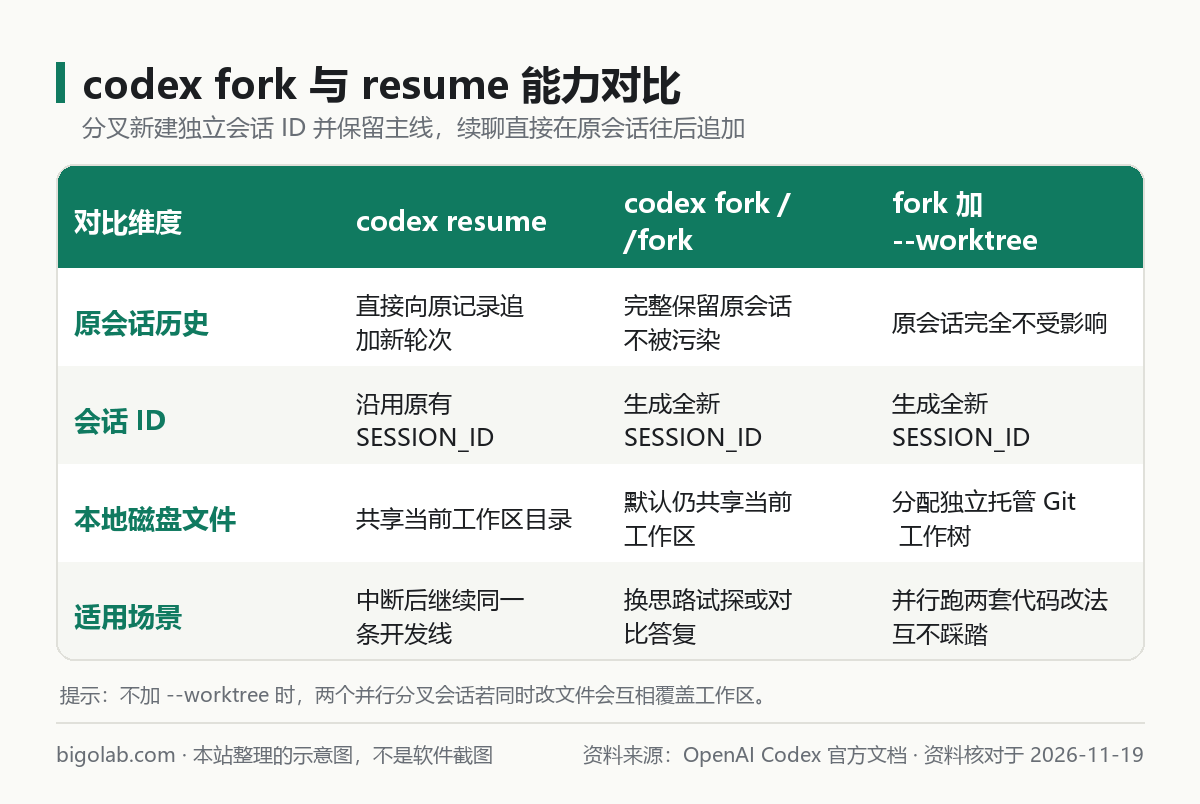
圖:本站根據 OpenAI Codex 官方文檔:Command line options 整理的示意圖
本文根據 OpenAI Codex 官方文檔《Command line options》《Slash Commands》《Codex CLI》整理,資料核對於 2026-11-19。配圖為本站整理的示意圖,不是介面截圖。本站(bigolab.com)不是 OpenAI 官方網站。
適用於誰
- 剛花了不少輪次讓 Codex 讀懂複雜業務模組,接下來有兩種實現思路想分別試探,又不想重新從零喂背景的開發者;
- 擔心在主會話裏做高風險重構或排查假說會把整段對話帶偏、污染原有清晰上下文的工程師;
- 希望在本地並行開啟兩個隔離目錄讓 Codex 同時寫方案 A 和方案 B,最後對比代碼差異與測試結果擇優合入的人。
一、/fork 與 codex fork 四種核心用法速查
在 Codex CLI 中(全部常用子命令可見 /guides/codex-cli-commands-cheatsheet),會話分叉分為「會話內觸發」和「命令行啟動」兩條路徑,按當前所在位置選用即可:
bash
# 1. 打開交互式歷史會話選擇器,挑一條會話分叉
codex fork

# 2. 直接分叉最近一次結束的會話(跳過選擇器)
codex fork --last

# 3. 精確指定某條歷史會話的 ID 進行分叉
codex fork <SESSION_ID>

# 4. 指定會話 ID 並在獨立託管 Git worktree 中啟動分叉(適合並行改代碼)
codex fork <SESSION_ID> --worktree
如果此時正處於交互式終端介面(TUI)裏,不需要先退出進程,直接在輸入框敲:
text
/fork
Codex 會立即基於當前這一輪之前沉澱的全部上下文克隆出一個新線程並切入新會話,原線程仍然靜靜留在歷史記錄裏。後續想清理實驗完廢棄的分支會話,可按 /guides/codex-delete-archive-chats 歸檔或刪除。
二、實戰工作流:不污染主線,並行試跑方案 A 與方案 B
假設你的服務需要改造緩存層,既可以考慮「本地進程內 LRU 緩存」,也可以考慮「Redis 旁路緩存」。按照本站建議的四步法,可以讓兩條方案共享前期調研成果、同時互不打架:
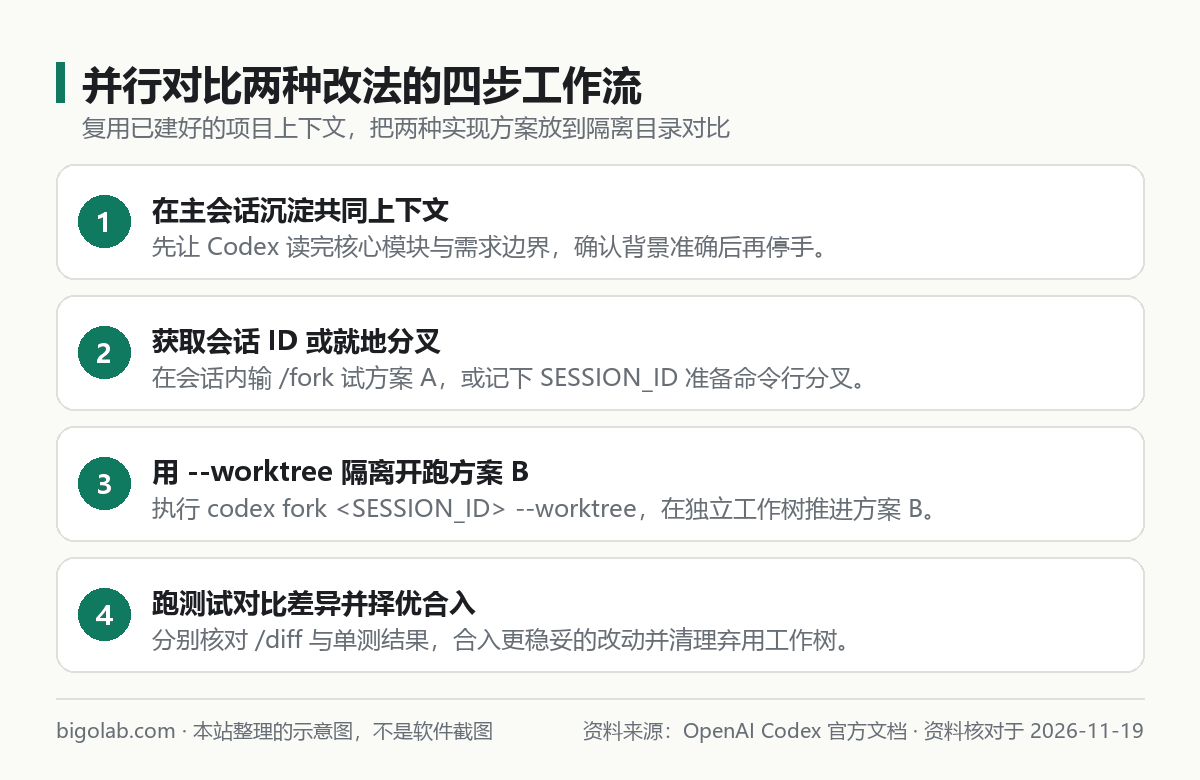
圖:本站根據 OpenAI Codex 官方文檔:Codex CLI 整理的示意圖
第 1 步:在主會話裏只做調研與方案梳理,不急着改文件
啟動主會話,讓 Codex 先讀完緩存接口、調用方和現有單測,輸出一份改動影響面清單,並確認團隊約束。此時不要讓它直接落盤改代碼,讓主會話停在一個「上下文最精準、工作區完全乾淨」的基準點。輸入 /status 記下當前 SESSION_ID。
第 2 步:在當前工作區或第一條工作樹推進方案 A
打開新終端,用基準會話 ID 分叉出方案 A 支線:
bash
codex fork <BASE_SESSION_ID> --worktree
進入後直接下發方案 A 指令:「基於上面梳理的調用點,用進程內 LRU 實現緩存並補充並發單測,跑通測試後彙總改動範圍。」
第 3 步:另開終端並行分叉出方案 B
保持方案 A 繼續跑,另開一個終端標籤頁,從同一個 <BASE_SESSION_ID> 再分叉一次:
bash
codex fork <BASE_SESSION_ID> --worktree
在第二個獨立工作樹裏下發方案 B 指令:「基於上面梳理的調用點,改用 Redis 旁路緩存與降級開關實現,補充失敗回退測試。」
第 4 步:對照 diff、單測與代碼審查擇優合入
兩條支線跑完後,分別在對應會話裏用 /diff 與 /review(審查用法見 /guides/codex-code-review)核對可讀性、邊界異常和測試覆蓋率。挑出更穩妥的一套把改動合入主分支,另一套連同臨時工作樹直接丟棄,整個過程主會話歷史零污染。
訂閱與帳號準備提示:並行分叉相當於在短時間內同時運行多個高上下文代理會話,會顯著加快 5 小時滾動配額的消耗(計算方式見 /guides/codex-usage-limits)。如果經常做多方案對比與並行探索,建議在本站升級 ChatGPT Pro 充值 或選用 ChatGPT Pro 5x iOS 可覆蓋檔;新註冊 OpenAI 帳號若在手機驗證步驟受阻,可查看 Codex 註冊手機驗證服務。
三、3 個使用分叉時的關鍵避坑點
- 千萬不要在未隔離工作區裏同時跑兩個寫代碼的
/fork:如果你在兩個終端裏對同一目錄分別運行不帶--worktree的分叉會話,並讓兩者同時編輯代碼,Git 暫存區和源文件會互相覆蓋,導致單測結果完全失真。不隔離目錄的分叉,只適合「只讀問答、方案推演、對比提示詞效果」。 - 確認倉庫已初始化且工作樹幹淨再用
--worktree:託管 Git 工作樹依賴正常 Git 倉庫狀態;若主工作區還有大量未提交半成品改動,分叉出來的新工作樹是從當前 HEAD 檢出的,不會自動攜帶未提交的髒文件。 - 分叉完及時給實驗支線收尾:實驗失敗後順手清理臨時工作樹和廢棄會話,避免過幾天自己都分不清哪條會話對應哪次改動。
常見問題
問:為什麼執行 codex fork --last --worktree 提示參數不兼容或報錯?
答:部分版本中 --worktree 需要顯式提供 SESSION_ID,不支持與 --last 直接混用。先通過 codex fork 交互列表或上一次會話的 /status 查到具體 SESSION_ID,再執行 codex fork <SESSION_ID> --worktree 即可。
問:分叉出來的新會話,能不能切一個不同的模型或推理強度去試?
答:完全可以。分叉只繼承到分叉點為止的歷史消息,進入新會話後直接用 /model 切到另一檔推理強度,或啟動命令行時追加 -c 參數,就能對比不同模型檔位在相同上下文下的實現質素。
問:國內沒有外幣信用卡,或者公司團隊需要增值稅發票報銷,怎麼開通跑 Codex CLI 的訂閱?
答:可通過本站 AI 會員充值總覽 按需選購 ChatGPT Plus或高配額 ChatGPT Pro,團隊多席位部署可直接查看 ChatGPT Business 團隊定製。支持支付寶、微信支付和 AlipayHK,採用卡密自助兌換無需交出帳號密碼,並可開具增值稅發票;實時價格以商品頁展示為準,售後執行掉訂閱按剩餘天數折退、封號不在質保範圍的政策。
相關教學
參考資料
- OpenAI Codex 官方文檔:Command line options — https://learn.chatgpt.com/docs/developer-commands
- OpenAI Codex 官方文檔:Slash Commands — https://learn.chatgpt.com/docs/cli/slash-commands
- OpenAI Codex 官方文檔:Codex CLI — https://learn.chatgpt.com/docs/codex/cli
- OpenAI Developers 文檔:Codex CLI Reference — https://developers.openai.com/codex/cli/reference
0 條評論
還沒有評論,來搶沙發~