
結論先說
- 多服務商共存靠「逐家啟用 + 模型能力標籤校驗」:在「設定 > 模型服務」分別填好各家官方 API Key 並點「檢測」,注意核對模型右側是否亮起視覺(眼睛)、工具調用(扳手)或嵌入(Embedding)圖標。
- 搭建本地知識庫前必須先配好至少一款嵌入模型:Claude 官方不提供通用文本 Embedding 接口,建庫時推薦啟用 OpenAI
text-embedding-3-small、Gemini Embedding 或本地 Ollama 的bge-m3。 - 掛載本地
stdio類 MCP 優先使用軟件內置的uv與Bun環境:無需自己在系統全局折騰複雜的 Node.js 或 Python 路徑,一鍵初始化內置運行時即可跑通絕大多數uvx和npx命令。 - 對話輸入框底部的工具欄決定本輪是否啟用知識庫與 MCP:建好庫和配好 MCP 後,必須在當前聊天窗口底部手動點亮對應的「知識庫」和「MCP 伺服器」圖標才會生效。
- 谷歌密鑰準備與官方旗艦會員入口:申請 Gemini API Key 需具備個人谷歌帳號,缺號可查看本站 谷歌帳號購買說明(含 谷歌電郵成品號);若高頻長上下文對話想用固定月費代替按量帳單,可自助開通 Claude Pro 或 ChatGPT Plus。
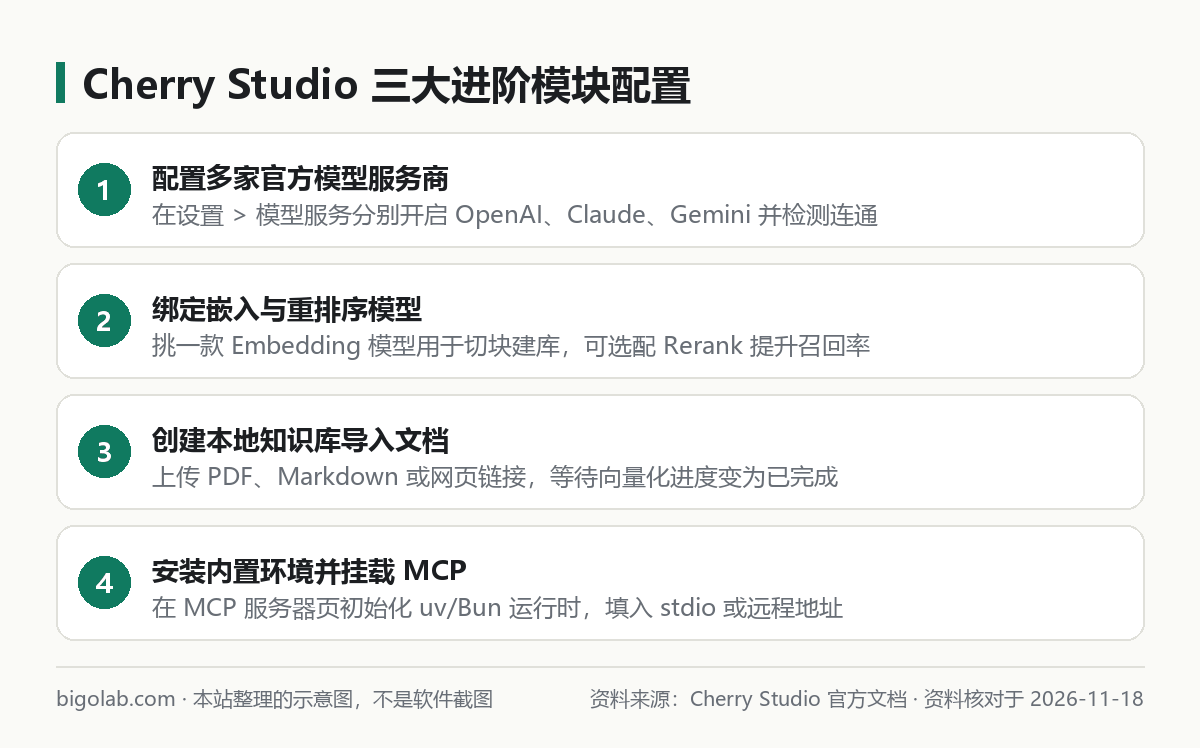
圖:本站根據 Cherry Studio 官方文檔:模型服務與進階功能 整理的示意圖
本文根據 Cherry Studio 官方文檔《模型服務》《知識庫》《MCP 伺服器》整理,資料核對於 2026-11-18。配圖為本站整理的示意圖,不是介面截圖。本站(bigolab.com)不是 Cherry Studio 或各模型廠商官方網站。
適用於誰
- 不想同時開四五個網頁標籤,希望在一個桌面軟件裏隨時切換 OpenAI、Claude、Gemini 與 DeepSeek 模型的人;
- 手頭有一批 PDF 規範手冊、Markdown 筆記或內部接口文檔,想在本地切片建立向量知識庫做精準問答的用戶;
- 想在桌面端給大模型掛載文件系統、網頁抓取或數據庫 MCP 工具,卻卡在
npx/uvx環境報錯的新手。
一、同時接入多家官方 API 與同屏對比回答
基礎的單服務商接入步驟可參考本站 DeepSeek 接入 Cherry Studio 和 Chatbox。當你同時握有多家官方密鑰(申請見 OpenAI API Key 獲取 與 Gemini API Key 獲取)時,按以下規範統一管理最清爽:
- 點擊左下角齒輪「設定(Settings)> 模型服務(Model Provider)」,依次開啟
OpenAI、Anthropic、Gemini、DeepSeek或本地Ollama; - 每填完一家 API Key,先點「管理(Manage)」勾選你真正會用到的 2–3 個主力模型(把幾十個舊快照模型留在列表外,避免切換選單冗長),再點右上角「檢測(Check)」確認返回綠勾;
- 檢查能力圖標:若你打算讓某個模型調 MCP 工具,點開該模型右側設定圖標,確認已勾選「工具調用(Function Calling / Tools)」能力;
- 一問多答橫向比對:回到聊天介面,利用頂部的多模型提及(
@)或分欄對比功能,同一條提示詞可同時發給 Claude 與 GPT,直觀對比兩家的代碼方案或文案潤色質素。
二、搭建本地知識庫:Embedding 選型、切片與 Rerank
Cherry Studio 的本地知識庫會把你的文件解析切片並轉換成向量儲存在本機目錄,提問時只把相似度最高的幾個片段塞給對話模型:
- 標記嵌入模型:先在任一支持向量的服務商下添加嵌入模型(如 OpenAI 的
text-embedding-3-small、Gemini 的gemini-embedding-001或本地 Ollama 的bge-m3),確認模型名旁帶有Embedding標籤; - 新建知識庫:點擊左側邊欄「知識庫(Knowledge Base)」圖標 >「添加」,輸入名稱並在下拉框選中剛才配好的嵌入模型(若你配了重排序模型,可同步選上
Rerank模型提升複雜技術問答的排名前三命中率); - 導入多源資料:支持拖入本地
PDF、DOCX、MD、TXT文件,也支持填入公開文檔網址或整目錄文件夾;右側狀態顯示綠勾即代表向量化完成; - 對話掛載:回到聊天窗口,點擊輸入框下方的「知識庫」圖標勾選目標庫,發問後可在回答底部展開查看具體引用了哪一頁原文片段。
開發帳號與編程訂閱配套提示:若在 Google AI Studio 申請免費或付費層密鑰時缺少合規谷歌帳號,可前往本站選購帶兩步驗證的 谷歌電郵成品號;若你在寫代碼時發現客戶端按 Token 調旗艦模型成本過高,也可直接搭配包月制官方編程工具,在本站免外幣卡開通 Claude Code 或 ChatGPT Plus。
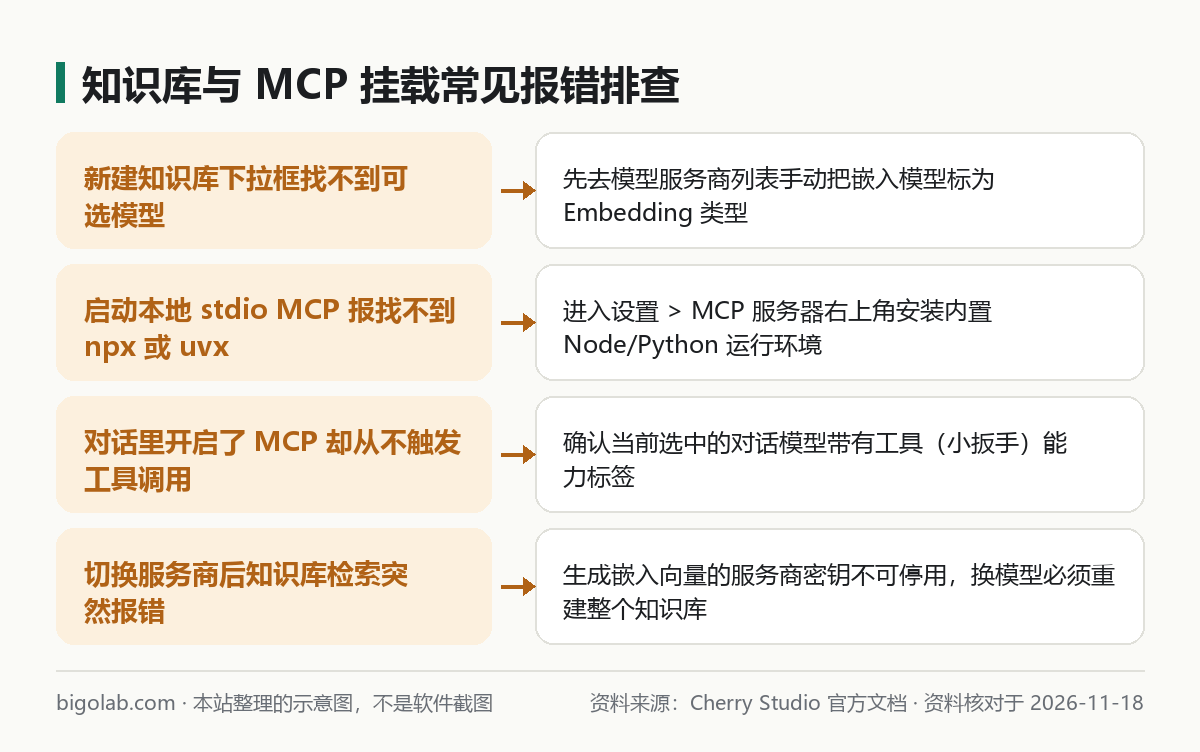
圖:本站根據 Cherry Studio 官方文檔:知識庫與 MCP 伺服器 整理的示意圖
三、掛載本地與遠程 MCP 工具完整步驟
想讓客戶端具備讀寫指定本地文件夾、查數據庫或抓網頁的能力,可接入標準 MCP 服務(協議原理見 MCP 是什麼:Model Context Protocol 入門):
- 一鍵裝好內置運行時:進入「設定 > MCP 伺服器(MCP Servers)」,點擊右上角環境檢查按鈕,讓軟件自動下載內置的
uv(跑 Python 類uvx工具)與Bun(替代 Nodenpx跑前端工具),免去 Windows 環境變量找不到命令的煩惱。 - 添加伺服器配置:點擊「添加伺服器」,支持標準輸入輸出(
stdio)與遠程流式(SSE/Streamable HTTP)兩種類型。例如掛載官方本地目錄讀寫工具(請將末尾路徑替換為你允許訪問的單個工作文件夾,切勿掛載整塊系統盤):
json
{
  "mcpServers": {
    "filesystem": {
      "command": "npx",
      "args": ["-y", "@modelcontextprotocol/server-filesystem", "D:/work/docs"]
    }
  }
}- 開啟開關並在聊天窗掛載:儲存後打開該 MCP 右側開關,看到綠點在線並列出可用
Tools清單即代表握手成功;最後回到聊天輸入框底部點亮「MCP」按鈕勾選該服務即可調用。
常見問題
問:為什麼我新建知識庫時,「嵌入模型」下拉列表是空的?
答:說明你當前啟用的模型列表裏沒有任何被識別為 Embedding 類型的模型。去「設定 > 模型服務」裏添加專門的嵌入模型(不要誤選普通聊天模型),並在該模型的屬性彈窗裏勾選「嵌入(Embedding)」標籤後再回來創建。
問:知識庫建好後,把生成向量用的那家 API Key 刪掉還能繼續檢索嗎?
答:不能。每次你提一個新問題,客戶端都需要調用同一個嵌入模型把你的問題也算成同維度的向量,才能和本地存好的文檔向量算餘弦相似度。一旦更換嵌入模型,必須點擊重建索引。
問:掛太多 MCP 伺服器會不會讓每次普通聊天都變貴?
答:會。只要你在當前會話輸入框勾選啟用了某個 MCP,它底下的所有工具名稱和 JSON 參數說明都會隨每輪對話作為系統上下文發送給大模型,白白消耗輸入 Token。不用的 MCP 隨手在輸入框底部取消勾選即可。
問:國內沒有外幣卡怎麼買谷歌帳號或開通 Claude、ChatGPT 訂閱,能開報銷發票嗎?
答:可在本站 谷歌帳號購買頁、Claude Pro 充值頁 或 AI 會員充值總覽 下單,支持支付寶、微信支付與 AlipayHK,會員升級提供無需交出密碼的卡密自助兌換,企業採購支持開具國內增值稅發票;實時價格與售後邊界(掉訂閱按剩餘天數折退,封號不在質保範圍)以商品頁說明為準。
相關教學
- DeepSeek 接入 Cherry Studio 和 Chatbox:API Key 填寫、模型列表與連通檢測步驟
- MCP 是什麼:Model Context Protocol 入門,以及在 Claude 裏怎麼用
- OpenAI API Key 怎麼獲取:創建密鑰、項目權限與安全保管
- Gemini API Key 怎麼獲取:在 AI Studio 創建密鑰、設定環境變量與安全限制
參考資料
- Cherry Studio 官方文檔:模型服務商配置總覽 — https://docs.cherry-ai.com/pre-basic/providers/providers
- Cherry Studio 官方文檔:本地知識庫創建與檢索 — https://docs.cherry-ai.com/advanced-basic/knowledge-base
- Cherry Studio 官方文檔:MCP 伺服器環境與接入說明 — https://docs.cherry-ai.com/advanced-basic/mcp/overview
0 條評論
還沒有評論,來搶沙發~