
結論先說
- 先分清是「輸入超窗」還是「輸出觸頂」。請求直接報 400
context_length_exceeded,說明輸入消息加歷史超出了模型總上下文窗口;請求返回 200 但文字或 JSON 卡在半截,則是單次生成撞到了max_output_tokens上限。 - Responses API 提供服務端自動裁剪參數
truncation: "auto"。預設值為"disabled"(超限即報錯);設為"auto"後,若總長度超出窗口,服務端會保留頂層系統指令與最新消息,自動從對話中部丟棄最早的歷史輸入項。 - 絕對不能丟失的核心規則必須放進
instructions字段。放在普通早期對話輪次裏的背景說明,在觸發auto裁剪時可能被優先剔除。 - 嚴謹審計與全量抽取任務應保持
"disabled"。合同審查、財報核算等不允許靜默漏讀段落的場景,一旦超長應顯式報錯並改走分塊彙總,切勿讓服務端靜默刪減內容。 - 個人日常處理超長文檔或代碼庫時若需更高上下文額度,國內無外幣卡用戶可在本站自助開通 ChatGPT Plus 或高配額 ChatGPT Pro,企業協作可諮詢 ChatGPT Business 團隊定製。
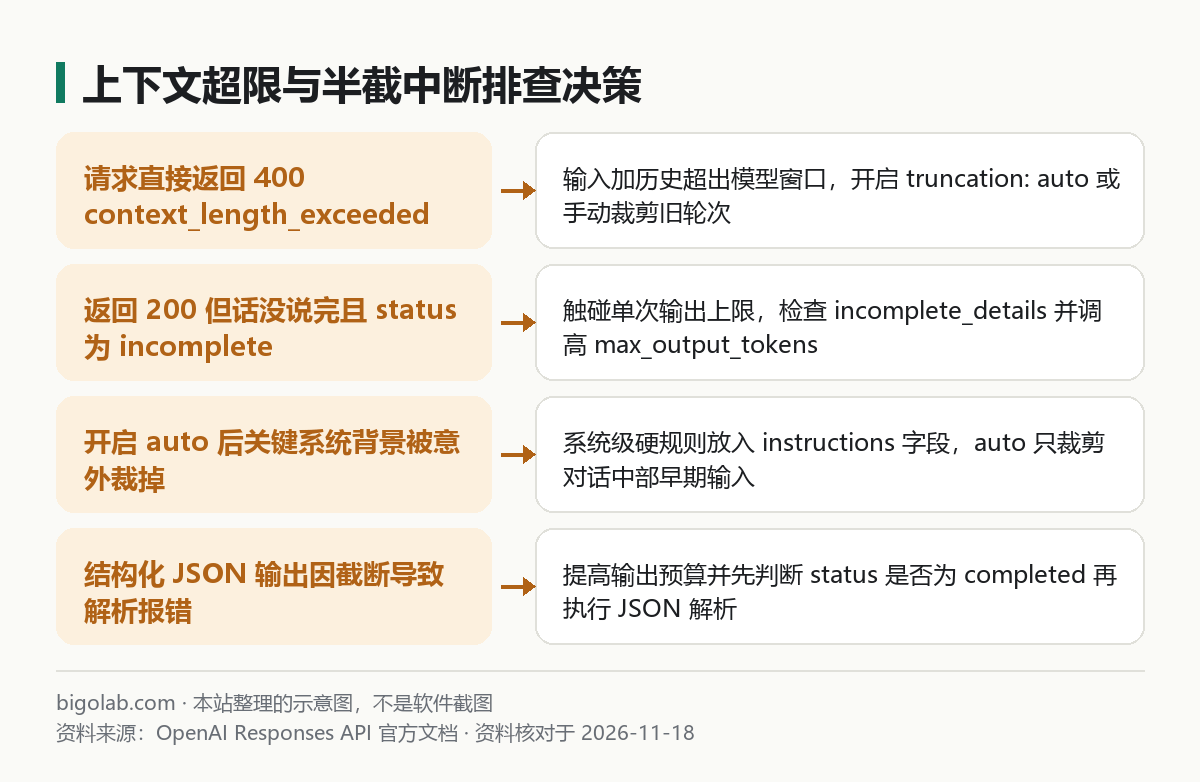
圖:本站根據 OpenAI Responses API 官方參考文檔 整理的示意圖
本文根據 OpenAI API 官方文檔《Create a model response Reference》《Error codes》整理,資料核對於 2026-11-18。配圖為本站整理的示意圖,不是介面截圖。本站(bigolab.com)不是 OpenAI 官方網站。
適用於誰
- 在多輪客服機器人、Agent 工具循環或長文檔問答裏遇到 HTTP 400
context_length_exceeded報錯的後端開發者; - 搞不清「輸入撐爆上下文窗口報錯」與「輸出撞到
max_output_tokens半截中斷」兩種故障邊界的人; - 想用 Responses API 原生
truncation: "auto"省去手寫滑動窗口裁剪邏輯的工程師。
一、truncation 兩種模式與截斷類型對照
在 Responses API 中(接口基礎見 /guides/openai-responses-api,常見錯誤碼總覽見 /guides/openai-api-error-codes),服務端對窗口邊界的處理邏輯如下:
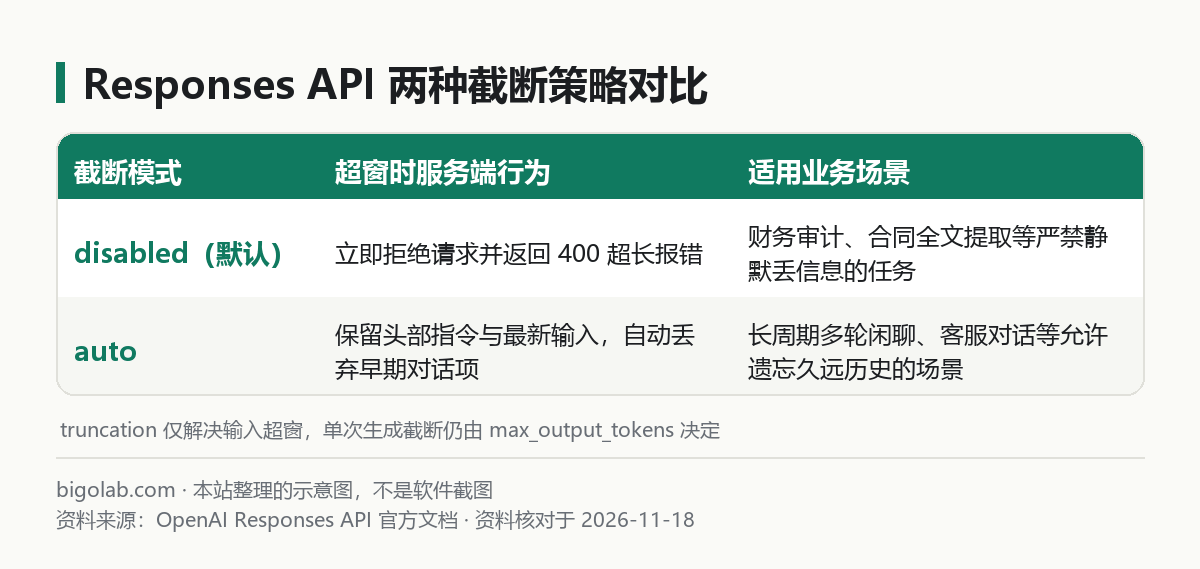
圖:本站根據 OpenAI Responses API 官方參考文檔 整理的示意圖
| 故障現象 | 觸發條件 | 對應控制參數與修復手段 |
|---|---|---|
HTTP 400 context_length_exceeded | 輸入提示詞 + 多輪歷史 + 預留空間超出模型總窗口 | 多輪對話開 truncation="auto",或對舊輪次做摘要壓縮 |
HTTP 200 但 status == "incomplete" | 生成過程耗盡了單次允許的 max_output_tokens | 檢查 incomplete_details.reason,調高 max_output_tokens 或分步生成 |
| 結構化 JSON 解析報語法截斷錯 | 未檢查完成狀態就直接對半截輸出跑 json.loads | 解析前先校驗 resp.status == "completed"(詳見 /guides/openai-api-structured-outputs) |
二、Python 實戰代碼:開啟服務端自動裁剪與截斷兜底檢查
搭配 previous_response_id 做多輪有狀態對話時,加上 truncation="auto" 即可防止聊到幾十輪後突然炸 400 錯誤:
python
from openai import OpenAI

client = OpenAI()

resp = client.responses.create(
    model="gpt-4.1",
    instructions="你是技術支援助手,回答務必控制在 300 字以內,嚴禁編造不存在的命令。",
    input="用戶上載了最新一段報錯棧,請結合前文繼續給出排查命令。",
    previous_response_id="resp_abc123xyz",
    truncation="auto",
    max_output_tokens=4096,
)

if resp.status == "incomplete":
    reason = resp.incomplete_details.reason if resp.incomplete_details else "unknown"
    raise RuntimeError(f"響應未完整結束,觸發限制:{reason}")

print(resp.output_text)
print("本輪輸入 Token:", resp.usage.input_tokens)訂閱與帳號準備提示:長上下文多輪對話在未命中緩存時每輪都會重複計入歷史輸入 Token(價格計算見 /guides/openai-api-price-official-table)。若你日常辦公需要高頻上載長文檔反覆追問,開通包月會員往往比按量燒 API 更可控;國內用戶可在本站選購 ChatGPT Plus 會員 或升級 ChatGPT Pro 充值。
三、控制窗口預算的三條工程實踐
- 限制單次工具返回體積:在 Agent 循環裏,
context_length_exceeded最常見的元兇不是用戶打字太多,而是某一次數據庫查詢或網頁抓取工具一次性塞回了十幾萬字符的原始 HTML。務必在工具層對返回文本做長度截斷(例如上限8000字符並附帶省略提示)。 - 區分靜態前綴與動態變量保住緩存命中:
truncation="auto"發生裁剪時會改變歷史序列前綴,可能導致後續請求暫時失去提示詞緩存摺扣;對於超長對話,每隔 15 至 20 輪主動用小模型把舊歷史濃縮成一段摘要開啟新會話鏈,成本更平穩。 - 仍在用舊版 Chat Completions 接口怎麼辦:舊版
/v1/chat/completions沒有服務端truncation="auto"參數,只能由業務代碼用tiktoken預估各條消息 Token 數並在客戶端自行彈出舊消息,或平滑遷移至 Responses API。
常見問題
問:開了 truncation: "auto" 後,單條輸入本身就超過模型最大上下文窗口還能救回來嗎?
答:不能。auto 是按對話歷史裏的「輸入項(Items)」粒度從中部剔除舊輪次;如果你單次塞進去的一整篇幾百萬字文本本身就大於模型總窗口,依然會返回 400 超長錯誤,這種情況必須先做文檔切片檢索(RAG)或分段摘要。
問:怎麼知道某一輪請求有沒有實際觸發自動裁剪?
答:可以對比預期累計的歷史 Token 數與本次響應 resp.usage.input_tokens 的回落幅度,或在平台後台日誌面板核查實際進入模型上下文的消息條目列表。
問:國內沒有外幣卡,或者公司財務要求開具增值稅發票,怎麼訂閱長窗口官方會員?
答:可通過本站 AI 會員充值總覽 選購 ChatGPT Plus 或 ChatGPT Pro,支持支付寶、微信支付及 AlipayHK,支持卡密自助兌換與企業定製,並可開具增值稅發票。實時價格以頁面顯示為準;售後遵循掉訂閱按剩餘天數折退、封號不在質保範圍的規則。
相關教學
- OpenAI Responses API 是什麼:和 Chat Completions 的區別
- OpenAI API 常見錯誤碼(400/429/500)排查指南
- OpenAI API 結構化輸出與 incomplete 處理
- OpenAI API 價格表與長上下文計費說明
參考資料
- OpenAI API 官方文檔:Create a model response — https://platform.openai.com/docs/api-reference/responses/create
- OpenAI API 官方文檔:Error codes — https://platform.openai.com/docs/guides/error-codes
0 條評論
還沒有評論,來搶沙發~