
跑通了 Vercel AI SDK 入門安裝與 generateText 基礎對話之後,一旦你在 Next.js 後端路由裏用 streamText 給模型掛上工具(Tools),十有八九會撞上同一個新手困惑:“模型明明成功調了查天氣函數、也拿到了返回的溫度 JSON,為什麼前端聊天框就停在那兒不說話了,沒有把溫度組織成自然語言回答出來?”
原因非常簡單:預設情況下,streamText 只執行單步(1 Step)推理——模型吐出工具調用指令並執行完函數後,本輪生成即宣告結束。想要讓它把工具返回結果自動喂回給大模型繼續推理(甚至連調三四個工具再總結),必須顯式配置多步循環條件。下面把多步流式控制與官方 @ai-sdk/mcp 接入一次講透。
AI 全棧開發訂閱配套入口:在本地部署與聯調開源 AI 框架時,搭配固定月費的終端編程智能體與旗艦推理訂閱能大幅縮短排錯時間。國內無境外信用卡可在本站通過支付寶、微信支付或 AlipayHK 免密自助開通 Claude Code 訂閱、ChatGPT Plus / Pro 或查看 AI 會員充值總覽。
一、看清接口升級:stopWhen: stepCountIs(n) 與 @ai-sdk/mcp
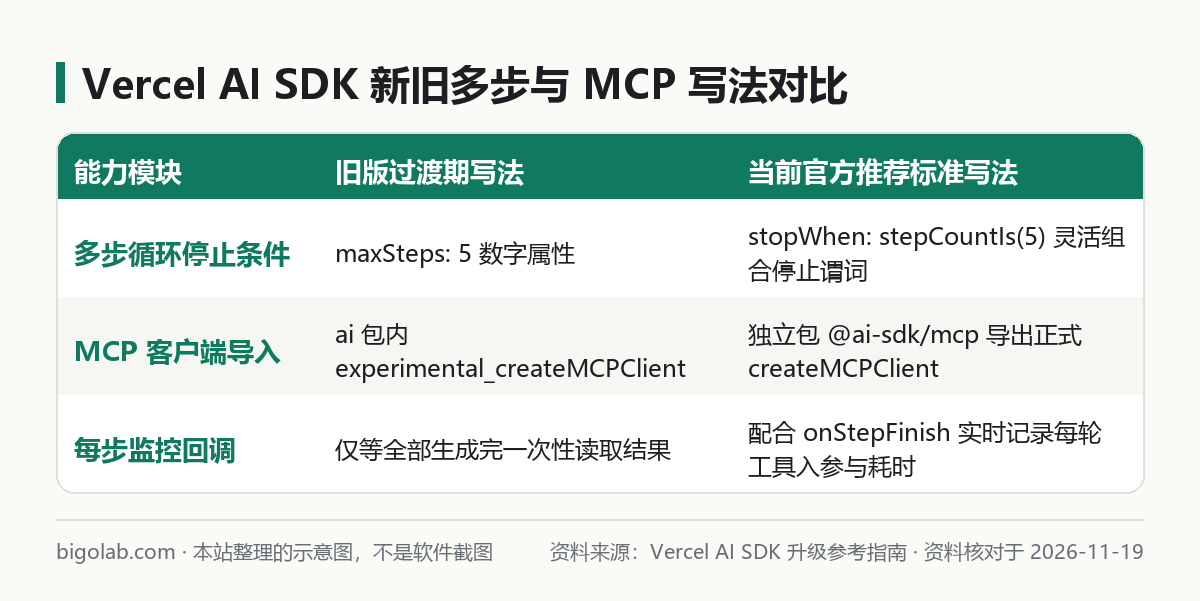
如果你搜到的是半年前的老網誌,很可能會看到 maxSteps: 5 或者從主包裏導入實驗性的 experimental_createMCPClient。在當前官方標準規範中,這兩處都已經演進為更清晰、模組化的正式寫法:
先在你的 TypeScript / Next.js 項目裏裝齊核心包、官方模型提供方包以及獨立的 MCP 客戶端包:
bash
npm install ai @ai-sdk/anthropic @ai-sdk/mcp zod二、完整實戰代碼:streamText 自動多步調 MCP 與本地工具
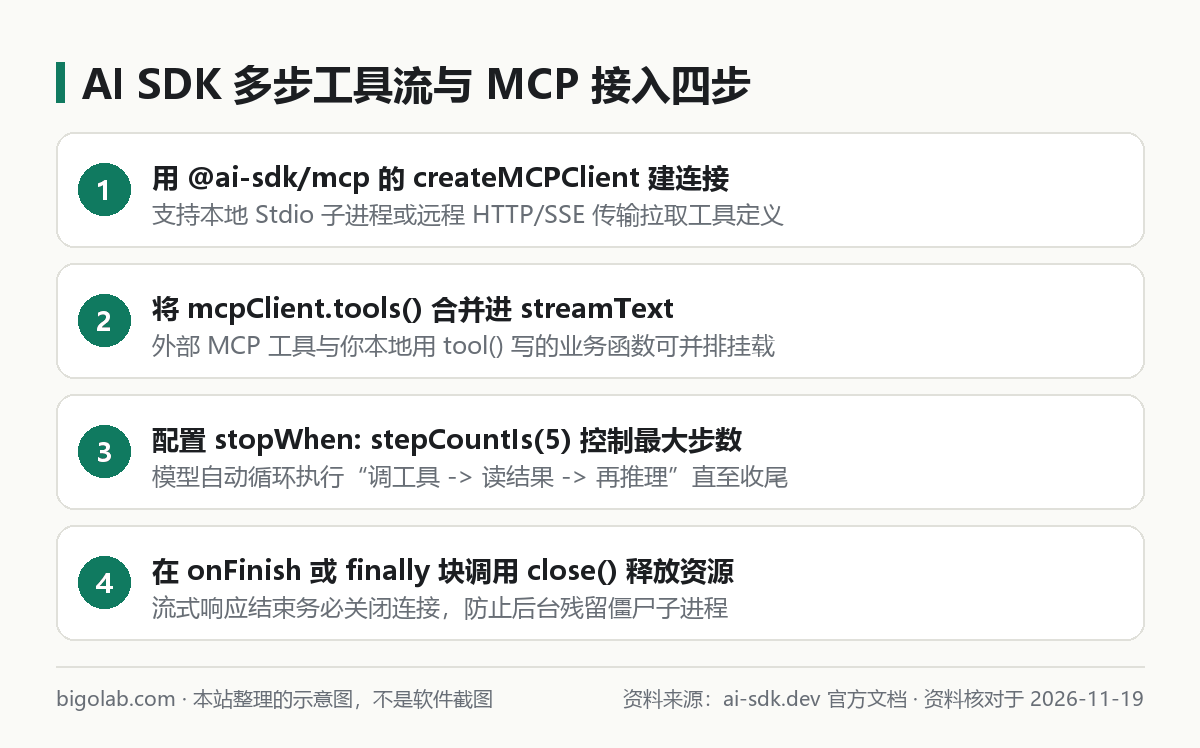
下面是一份可直接放入 Next.js App Router(app/api/chat/route.ts)的生產級路由模板。它同時接入了一個遠程 HTTP MCP 服務與一個本地 Zod 校驗工具,並在流式傳輸徹底收尾時安全關閉連接:
typescript
import { anthropic } from '@ai-sdk/anthropic';
import { createMCPClient } from '@ai-sdk/mcp';
import { streamText, stepCountIs, tool } from 'ai';
import { z } from 'zod';

export async function POST(req: Request) {
  const { messages } = await req.json();

  // 1. 連接團隊內部遠程 HTTP/SSE MCP 服務(亦支持 StdioMCPTransport 拉起本地進程)
  const mcpClient = await createMCPClient({
    transport: {
      type: 'sse',
      url: 'https://mcp.internal.example.com/sse',
      headers: {
        Authorization: `Bearer ${process.env.INTERNAL_MCP_TOKEN}`,
      },
    },
  });

  // 2. 自動發現並拉取遠程 MCP 暴露的全部工具定義
  const mcpTools = await mcpClient.tools();

  // 3. 啟動多步流式智能體循環,將外部 MCP 工具與本地業務工具合併掛載
  const result = streamText({
    model: anthropic('claude-sonnet-4-5'),
    messages,
    tools: {
      ...mcpTools,
      calculateDiscount: tool({
        description: '根據訂單原價與會員等級計算折後應付比例',
        parameters: z.object({
          tier: z.enum(['GOLD', 'SILVER']),
        }),
        execute: async ({ tier }) => ({ ratio: tier === 'GOLD' ? 0.85 : 0.95 }),
      }),
    },
    // 關鍵開關:允許最多連續執行 5 輪“模型決策 -> 調工具 -> 結果喂回模型”循環
    stopWhen: stepCountIs(5),
    onStepFinish({ stepType, toolCalls, usage }) {
      console.log(`[Step ${stepType}] 調用工具數: ${toolCalls.length}, 本步 Token: ${usage.totalTokens}`);
    },
    onFinish: async () => {
      // 關鍵防泄漏動作:等整個流發送完畢後再關閉 MCP 連接
      await mcpClient.close();
    },
  });

  return result.toUIMessageStreamResponse();
}研發團隊訂閱與高配額省心方案:調試複雜多步智能體循環、RAG 切片策略與 CI 評測流水線非常消耗單日 Token。個人主力開發推薦免上號兌換 Claude Pro iOS 自助卡密 或 5 倍額度的 Claude Max 5x,多人研發團隊協同亦可聯絡客服定製 ChatGPT Business 團隊版。
三、全棧開發最容易踩爆的三個線上大坑
把這套流式多步代碼推上生產環境前,請逐項核對下面三個細節:
- 千萬別在
return語句外面的finally裏提前調mcpClient.close()(這是streamText和同步generateText最大的區別):
因為 streamText 是非阻塞立即返回流響應對象的,當你 return 的那一毫秒,真正的第 2、第 3 步工具調用還沒跑完。如果你套了 try ... finally { await mcpClient.close() },流剛發出去第一幀 MCP 通道就被你親手掐斷了,第 2 步調工具必報連接已關閉。在流式場景下,一律把 await mcpClient.close() 放進 onFinish 與 onError 回調裏執行。
- 給 MCP 工具加 Schema 顯式白名單收斂體積:
如果遠程服務一口氣暴露了四十多個工具(就像我們在 LangGraph 接入 MCP 服務 或排查 遠程 HTTP MCP 鑑權問題 時常見的重型服務),全量塞進每次聊天會拖慢首字延遲。mcpClient.tools({ schemas: { ... } }) 支持只挑選當前業務真正用到的那三四個工具並附帶靜態類型推導。
- 合理卡住
stepCountIs上限防死循環:
普通查庫問答設 stepCountIs(3) 到 stepCountIs(5) 綽綽有餘;複雜研究型智能體也盡量不要超過 10 步,並在 onStepFinish 裏打好結構化審計日誌監控單次對話累計消耗。
日常用 TypeScript 全棧打磨前後端流式交互介面時,配合強力的終端編程智能體能省去大量查類型簽名的時間。需要開通海外官方開發訂閱的工程師,可前往查看貝果研究社 Claude Code 訂閱與配置方案或 ChatGPT Plus 自助充值專頁。
常見問題
在 Vercel Serverless 函數或無伺服器環境跑本地 StdioMCPTransport 為什麼會報錯?
無伺服器雲函數(Serverless Functions)是受限的短暫只讀沙盒,既沒有預裝全局 npx 緩存目錄,也不允許常駐後台子進程。在 Serverless 生產部署時,請一律將 MCP 服務獨立部署並改用基於網絡傳輸的 HTTP / SSE 遠程連接模式,本地開發調試階段再用 StdioMCPTransport。
前端 useChat 怎麼把模型中間調用工具的加載過程優雅畫出來?
新版 AI SDK 返回的消息結構採用統一的 parts(消息分片數組) 設計。你在 React 組件遍歷 message.parts 時,遇到 part.type 屬於工具調用分片即可根據狀態渲染“正在查詢內部訂單庫...”骨架卡片,等工具執行完流式吐出最終 text 分片時自然銜接正文,無需手寫複雜的自定義事件解析。
如果某一個危險寫操作工具(比如刪除訂單)不想讓多步循環自動執行,能中途停下來等前端點確認嗎?
完全可以。在定義這個高危 tool 時,故意省略不寫 execute 服務端執行函數(只保留 description 與 parameters)。當 streamText 走到需要調用該工具的那一步時,因為沒有服務端自動執行體,多步循環會自然停在該節點並把工具參數推給前端;前端彈出二次確認框等用戶點擊“同意刪除”後,再調用 addToolResult 把確認結果發回後端接着往下走,兼顧流暢體驗與人工審批門禁。
搭好開源框架後,國內沒有外幣信用卡怎麼開通主力編程與大模型訂閱?
可在 本站 AI 會員充值中心 使用支付寶、微信支付或 AlipayHK 自助選購卡密,支持免交密碼兌換 Claude Code(Pro / Max)、ChatGPT Plus 與 ChatGPT Pro,並支持開具增值稅發票;實時價格與售後邊界(封號不在質保範圍)以對應商品頁說明為準。
小結
- 在
streamText中加上stopWhen: stepCountIs(5),模型才能在拿到工具返回結果後自動繼續推理並流式輸出自然語言總結。 - 統一從正式包
@ai-sdk/mcp導入createMCPClient,即可把外部遠程或本地 MCP 工具與自有 Zod 工具無縫混編。 - 流式接口中務必在
onFinish回調內調用mcpClient.close(),切勿在同步finally塊中過早掐斷尚未跑完的多步流。
0 條評論
還沒有評論,來搶沙發~