
結論先說
- 想直接肉眼看選
chat.html,想按關鍵詞秒搜或二次處理選conversations.json。兩者存的是同一批歷史對話,只是一個排成了靜態網頁,一個是原始結構化數據。 chat.html超過二三十 MB 時瀏覽器很容易卡死,因為它把你幾年來的所有對話一次性渲染在同一張網頁裏;用記事本或 VS Code 直接打開幾百 MB 的單行conversations.json同樣會卡頓。- 重度用戶的壓縮包裏可能沒有單個
conversations.json,而是conversations-000.json、conversations-001.json等多個編號文件——這是官方在數據量大時的自動分片。 - **最穩妥的檢索辦法是用本地 Python 腳本流式讀取
conversations.json*,遍歷裏面的mapping節點樹,把包含關鍵詞的對話單獨存成幾 KB 的.md文件,離線執行、不聯網、不泄露私隱。 - 國內免境外卡開通入口:若沒有境外銀行卡或遇到支付被拒,可在本站通過支付寶、微信支付或 AlipayHK 自助獲取兌換碼開通 ChatGPT Plus 或 ChatGPT Pro,團隊多席位支持聯絡客服定製 ChatGPT Business 團隊版。
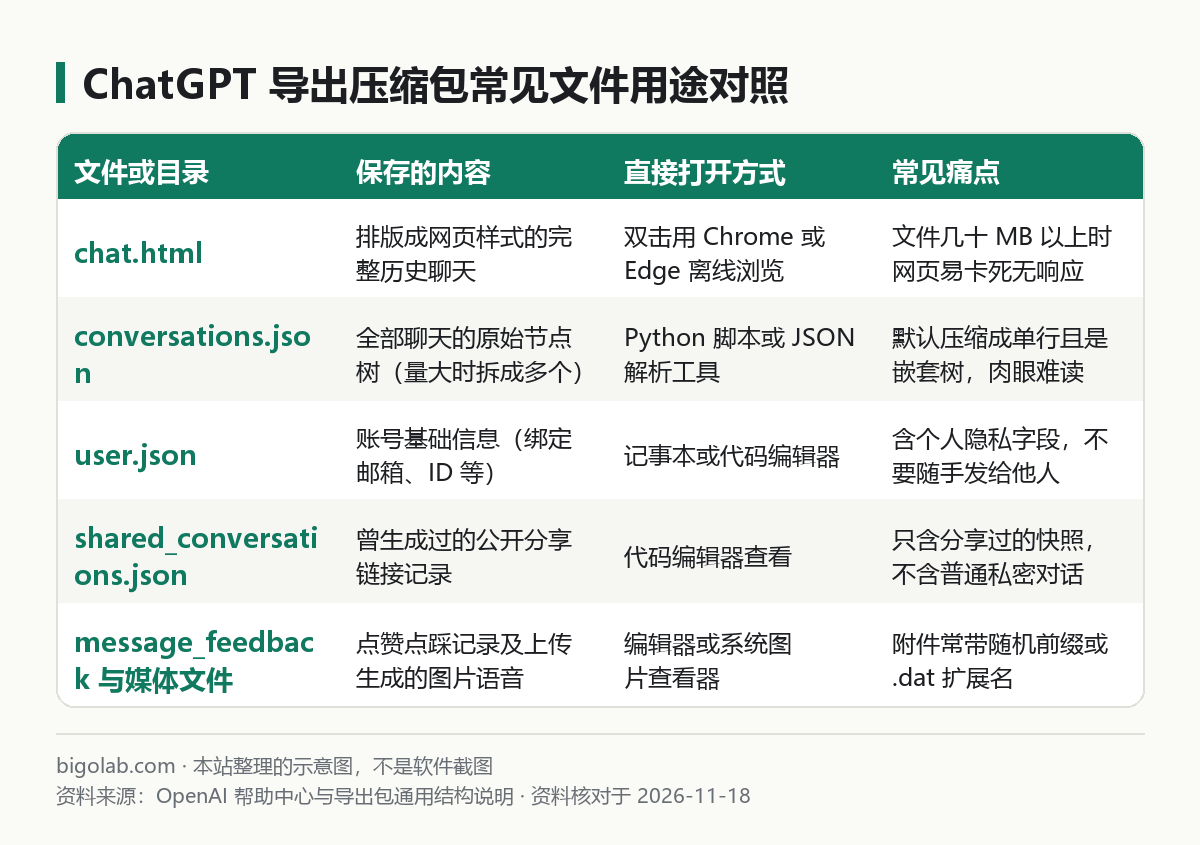
圖:本站根據 OpenAI 幫助中心:Exporting your ChatGPT history and data 整理的示意圖
本文根據 OpenAI 幫助中心《Exporting your ChatGPT history and data》《Transfer exported conversations between ChatGPT accounts》整理,並補充導出包本地解析方法,資料核對於 2026-11-18。配圖為本站整理的示意圖,不是介面截圖。本站(bigolab.com)不是 OpenAI 官方網站。
適用於誰
- 已經從電郵下載並解壓了 ChatGPT 導出的 ZIP 壓縮包,看着一堆
.json和.html文件不知道點哪個的人; - 雙擊
chat.html後瀏覽器一直轉圈、白屏或提示「頁面無響應」,根本沒法按關鍵詞查舊對話的人; - 想從幾百兆的
conversations.json裏挑出某幾段重要歷史記錄,轉成乾淨的 Markdown 儲存或傳給新帳號參考的人。
還沒申請導出、或者沒收到下載電郵的讀者,請先看前置步驟教學:ChatGPT 聊天記錄怎麼導出:申請步驟與下載連結說明。
一、解壓後的目錄裏都有什麼文件
先把下載回來的 .zip 完整解壓到一個普通文件夾(不要直接在壓縮軟件預覽窗口裏雙擊文件,否則大文件容易解壓不全或路徑報錯)。OpenAI 幫助中心說明包內包含聊天記錄及其他相關帳號數據,常見文件如下:
chat.html:把所有對話拼在一起的離線網頁文件,不需要聯網即可在 Chrome、Edge、Safari 中瀏覽。conversations.json(或帶編號的多個 JSON):核心對話數據庫。每條對話包含標題(title)、創建與修改時間戳,以及一個叫mapping的樹形字典——因為 ChatGPT 支持「重新生成回答」和「修改提問產生分支」,所以消息不是簡單數組,而是靠父子節點 ID 串起來的樹。user.json:帳號註冊電郵、用戶 ID 等基礎資料,含個人私隱,備份時注意保管。shared_conversations.json:你在帳號裏點過「分享(Share)」生成的連結快照記錄。message_feedback.json:你給某條回答點過贊或點過踩的反饋記錄。- 圖片、語音或
dalle-generations等子目錄:對話中上載過的附件、生成的圖片或語音片段(部分文件帶file-前綴或.dat擴展名)。
如果你本來只想把當前某一個正在聊的對話存成文檔,不必每次都走長達數天的全量導出,日常單聊儲存方法見 ChatGPT 單個對話怎麼導出。
二、chat.html 怎麼打開、卡死怎麼辦
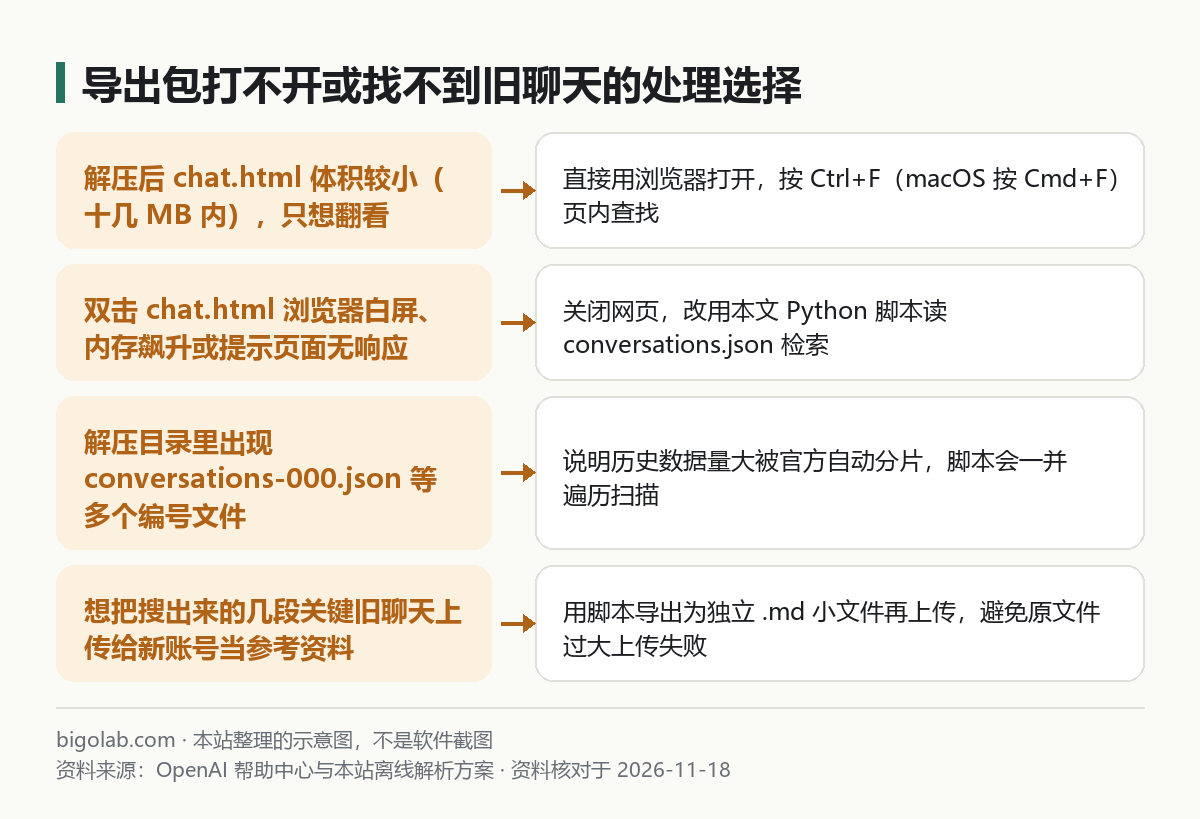
圖:本站根據 OpenAI 幫助中心:Transfer exported conversations between ChatGPT accounts 與本站離線解析方案整理的示意圖
- 輕量記錄(
chat.html在 20 MB 以內):右鍵選 Chrome 或 Edge 打開,等幾秒鐘加載完畢後,按快捷鍵Ctrl + F(macOS 按Cmd + F)輸入關鍵詞即可定位。 - 大體積記錄(幾十 MB 到幾百 MB):瀏覽器需要一次性創建數十萬個網頁節點,內存佔用會瞬間飆到幾個 GB 並彈出「頁面無響應(Page Unresponsive)」。這時不要硬等,直接關掉標籤頁,改用下一節的 Python 腳本解析
conversations.json。
三、用 Python 腳本檢索 conversations.json 並導出 Markdown
下面這段腳本只用到 Python 自帶標準庫(無需 pip install 任何第三方包),會自動掃描同目錄下的 conversations.json 或所有分片 conversations-*.json,順着每段對話當前激活的 current_node 還原完整上下文,按關鍵詞篩出匹配的對話並導出為乾淨的 Markdown 文件。
操作步驟
- 確認電腦已安裝 Python 3(終端輸入
python --version或python3 --version能看到版本號); - 在解壓出來的文件夾裏新建一個
search_chats.py,粘貼以下代碼並儲存:
python
import glob, json, os, re
from datetime import datetime

KEYWORD = "裝修預算"  # 改成你要搜的關鍵詞;留空字符串 "" 則導出全部對話
OUT_DIR = "matched_markdown"

def extract_messages(conv):
    mapping = conv.get("mapping") or {}
    node_id = conv.get("current_node")
    chain = []
    while node_id and node_id in mapping:
        node = mapping[node_id]
        msg = node.get("message")
        if msg and msg.get("author", {}).get("role") in ("user", "assistant"):
            parts = (msg.get("content") or {}).get("parts") or []
            text = "\n".join(p for p in parts if isinstance(p, str)).strip()
            if text:
                chain.append((msg["author"]["role"], text))
        node_id = node.get("parent")
    chain.reverse()
    return chain

os.makedirs(OUT_DIR, exist_ok=True)
files = sorted(glob.glob("conversations*.json"))
if not files:
    raise SystemExit("當前目錄下沒找到 conversations*.json,請把腳本放進解壓目錄運行")

kw = KEYWORD.lower()
count = 0
for fp in files:
    with open(fp, "r", encoding="utf-8") as f:
        data = json.load(f)
    for conv in data:
        title = (conv.get("title") or "未命名對話").strip()
        msgs = extract_messages(conv)
        full_blob = title + "\n" + "\n".join(t for _, t in msgs)
        if kw and kw not in full_blob.lower():
            continue
        count += 1
        ts = conv.get("create_time")
        date_str = datetime.fromtimestamp(ts).strftime("%Y-%m-%d") if ts else "unknown-date"
        safe_title = re.sub(r'[\\/:*?"<>|]+', "_", title)[:50]
        out_path = os.path.join(OUT_DIR, f"{date_str}_{count:04d}_{safe_title}.md")
        with open(out_path, "w", encoding="utf-8") as out:
            out.write(f"# {title}\n\n- 創建日期:{date_str}\n\n---\n\n")
            for role, text in msgs:
                speaker = "提問" if role == "user" else "ChatGPT"
                out.write(f"### {speaker}\n\n{text}\n\n")

print(f"掃描完成,共導出 {count} 段匹配對話到 ./{OUT_DIR}/ 目錄")- 在該文件夾下打開終端(Windows 可在資源管理器地址列輸入
powershell回車),運行:
powershell
python search_chats.py
幾秒鐘後,文件夾下會生成 matched_markdown 目錄,裏面每一篇都是按「創建日期 + 標題」命名的 .md 文件,用任意筆記軟件(如 Obsidian、Typora 或記事本)都能秒開。
四、搜出來的舊對話怎麼傳給新帳號接着用
按 OpenAI 官方《Transfer exported conversations between ChatGPT accounts》文檔說明,ChatGPT 不支持把導出包導回側邊欄恢復成歷史列表,但支持把導出的文件作為附件上載到新帳號的對話或項目裏當背景資料。
相比直接把幾百 MB 的原始 conversations.json 硬傳上去(很容易觸發單文件大小或上下文截斷限制),用上面的腳本先把相關主題的幾段對話篩出來存成幾個小 .md 文件,再傳進新帳號的「項目(Projects)」裏提問,準確率高得多。如果新帳號需要更高的文件上載限額、更長的上下文窗口或多人共享項目空間,可以在本站開通 ChatGPT Plus,團隊協同場景也可以了解 ChatGPT Business 團隊版定製。
常見問題
問:在 conversations.json 裏搜不到某段記得很清楚的對話,是怎麼回事?
分兩種情況:一是你在申請導出前已經手動刪掉了那段對話,官方明確說明已刪除的記錄無法通過導出恢復;二是對話還在帳號裏,但用的是臨時聊天(不會留存),或者你搜的詞恰好在圖片附件裏而非純文字中。若懷疑只是在網頁側邊欄被隱藏了,可按 ChatGPT 歸檔聊天查找與恢復教學 檢查。
問:腳本里的 current_node 是什麼意思,會不會漏掉我點過「重新生成」的舊版回答?
current_node 指向你在那段對話最後停留在的那個分支末端,順着它往回找 parent 得到的正是你在網頁上看到的那條完整主線。如果你連廢棄分支裏的舊回答也想找出來,可以把腳本改為直接遍歷 mapping.values() 裏的所有節點。
問:帳號裏的「記憶(Memory)」和自定義指令在哪看?
自定義指令包含在導出數據包的相關配置字段中;如果你只是想整理或遷移日常積累的個人記憶條目,直接在網頁設定裏複製更直觀,操作方法見 ChatGPT 記憶已滿:導出、清理與遷移教學。
問:國內沒有境外信用卡,怎麼開通或續費 ChatGPT Plus / Pro?
答:可在本站使用支付寶、微信支付或 AlipayHK 下單獲取卡密自助兌換(支持 ChatGPT Plus、Pro 5x 可覆蓋檔 與 Pro 5x 空白號檔),實時價格、兌換前提與售後規則(掉訂閱按剩餘天數折退,封號不在質保範圍)以對應頁面說明為準。
相關教學
- ChatGPT 聊天記錄怎麼導出:導出數據步驟、下載連結與遷移到新帳號
- ChatGPT 單個對話怎麼導出:導出 PDF、Markdown、Word 有哪些辦法
- ChatGPT 聊天記錄不見了怎麼辦:歸檔的聊天在哪、怎麼搜尋和恢復
- ChatGPT 記憶已滿怎麼辦:導出、清理、遷移與關閉記憶
參考資料
- OpenAI 幫助中心:Exporting your ChatGPT history and data — https://help.openai.com/en/articles/7260999-exporting-your-chatgpt-history-and-data
- OpenAI 幫助中心:Transfer exported conversations between ChatGPT accounts — https://help.openai.com/en/articles/9106926-transfer-exported-conversations-between-chatgpt-accounts
0 條評論
還沒有評論,來搶沙發~