
結論先說
llms.txt是給 AI 智能體看的「站點精簡目錄」:按llmstxt.org(v2 規範)定義,放在網站根目錄/llms.txt或子路徑(如/docs/llms.txt),用結構化 Markdown 給出項目簡介與乾淨文檔頁連結,省去解析複雜 HTML 導航和腳本的開銷。llms-full.txt是社區與文檔平台通行的「整站正文合集」:llms.txt只放輕量索引供智能體按需跟進連結;llms-full.txt則把整站核心文檔拼成單個大文本文件,適合本地建索引或離線檢索,但直接整份塞進對話容易撐滿上下文窗口。- v2 規範只有一級標題
# 項目名是必填項,但各段落順序固定:依次為# 標題、>一句話摘要、無標題補充說明、## 分類名下的名稱: 說明列表,以及約定的## Optional次要連結分組。 - 配套頁面建議提供同名
.md純文本版:規範建議在原網頁 URL 後加.md(如page.html.md或目錄頁加index.md),並用<link rel="alternate" type="text/markdown">或 HTTPLink:頭聲明關聯。 - 它不替代
robots.txt和sitemap.xml:robots.txt管爬蟲准入邊界,sitemap.xml羅列全量人類頁面給搜尋引擎,而llms.txt專供推理階段的智能體按需查資料。 - 主力模型訂閱與帳號配套入口:跑通 MCP 工具鏈與多文件智能體編碼依賴穩定的底層大模型配額,國內免境外卡自助開通可見本站 Claude Code 訂閱頁、ChatGPT Plus 充值頁 與 AI 會員充值總覽。
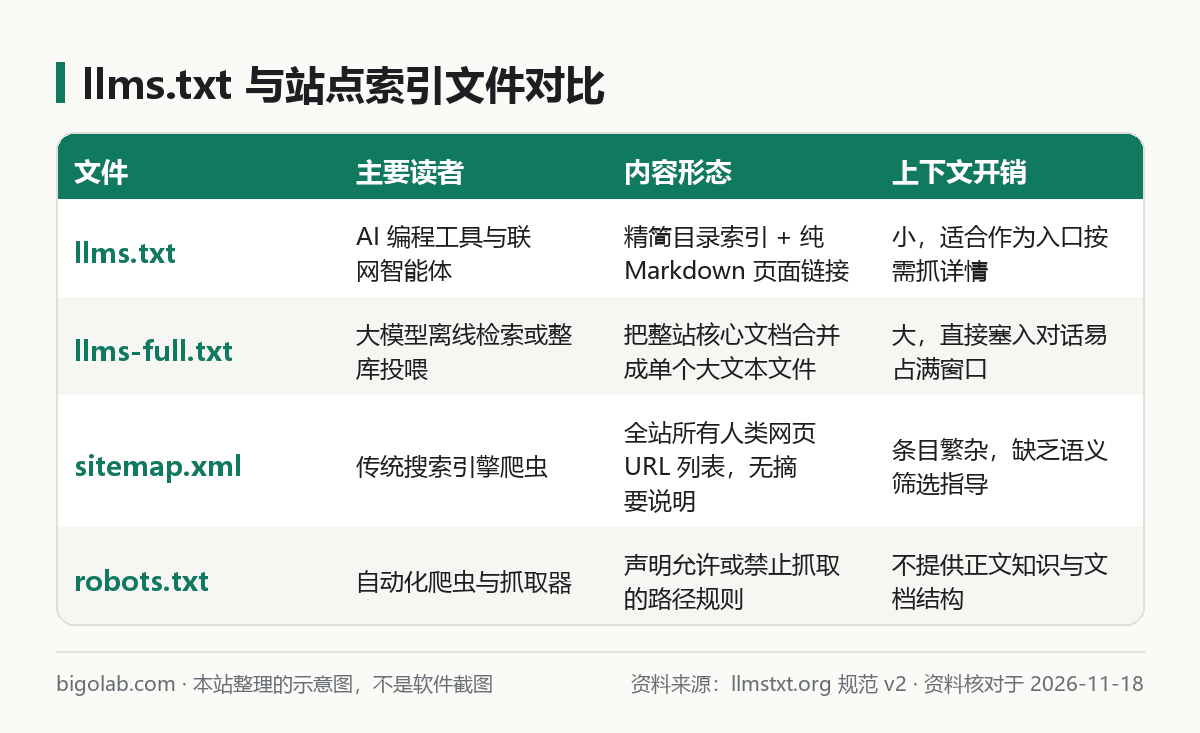
圖:本站根據 llmstxt.org:The /llms.txt file, v2 整理的示意圖
本文根據開放規範《The /llms.txt file, v2》(llmstxt.org)及主流大模型官方文檔站實踐整理,資料核對於 2026-11-18。配圖為本站整理的示意圖,不是介面截圖。本站(bigolab.com)不是 llmstxt.org 官方網站。
適用於誰
- 在開源庫或大模型文檔站看到
/llms.txt和/llms-full.txt,想知道兩者有什麼區別、該喂哪個給 AI 的開發者; - 維護內部或公開技術文檔,想按標準格式寫一份讓編程智能體少出幻覺的文檔負責人;
- 想弄清它和
robots.txt、sitemap.xml以及項目內AGENTS.md各管什麼的讀者。
一、為什麼需要 llms.txt,它和 llms-full.txt 差在哪
人類逛文檔站需要側邊欄、樣式表和交互腳本,但編程智能體抓 HTML 時,這些標籤只會浪費大量 token 並干擾提取精度。為此,OpenAI、Anthropic、Google Gemini 開發者文檔以及 Chrome Lighthouse 的智能體瀏覽檢查(Agentic browsing checks)都已引入 /llms.txt。
日常使用時,你會同時遇到兩個文件名:
llms.txt(官方規範定義):體積很小,裝得進一次普通對話上下文。模型先讀這份總覽判斷該看哪一章,再去拉取對應章節的.md連結;llms-full.txt(文檔平台擴展約定):例如 Mintlify 託管站點和 OpenAI Codex 文檔(learn.chatgpt.com/docs/llms-full.txt)會把所有文檔正文直接拼進這一個文件。小項目直接複製很省事,大型框架動輒幾百萬字符,更適合拆塊檢索而不是整篇粘貼。長文本提問排布技巧見 長文檔怎麼問 AI。
二、怎麼給文檔站寫一份標準的 llms.txt
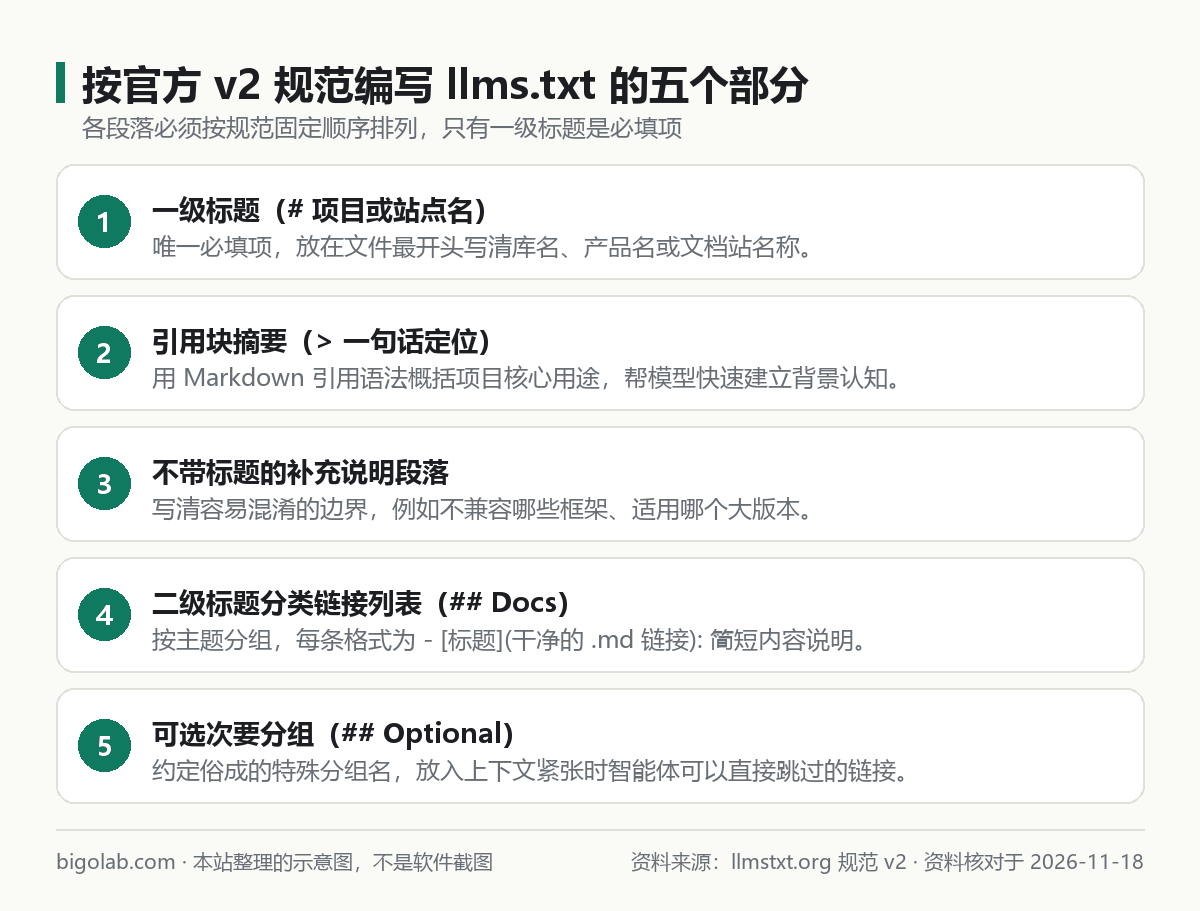
圖:本站根據 llmstxt.org:The /llms.txt file, v2 整理的示意圖
v2 規範要求各部分嚴格按順序書寫,這樣既方便大模型閱讀,也方便普通程序用正則或解析器固定提取。可直接套用下面這份模板:
markdown
# Acme SDK

> Acme SDK 是一個基於 TypeScript 的服務端支付與對帳客戶端庫,要求 Node.js 20 及以上版本。

重要邊界說明:
- v3 版本接口與舊版 v2 不兼容,所有異步方法均返回 Result 對象而非直接拋出異常;
- 僅用於服務端環境,不支持在瀏覽器前端直接打包調用以防泄露密鑰。

## 快速開始與核心接口

- [安裝與初始化](https://docs.example.com/quickstart.html.md): 環境變量配置、客戶端實例化與最小支付請求示例
- [Webhook 驗籤指南](https://docs.example.com/webhooks.html.md): 請求頭簽名核驗步驟與冪等處理寫法

## Optional

- [v2 升級 v3 遷移對照表](https://docs.example.com/migration-v3.html.md): 舊項目升級時的破壞性變更清單
編寫和發佈時的四個關鍵細節:
- 子路徑就近覆蓋原則:放在
/docs/llms.txt就代表只覆蓋/docs/下的內容;若同一頁面同時命中根目錄和子目錄兩份文件,智能體優先採用路徑更具體的那一份; - 中間補充段不能出現標題:在
>引用塊之後、第一個##二級標題之前,只能寫普通段落或無序列表(常用來強調「不兼容某某語法」),不要穿插三級標題; ## Optional的特殊含義:這是規範約定的保留分組名,告訴智能體「如果上下文預算緊張,這一節裏的連結可以直接跳過」;- 提供
.md鏡像頁與Link響應頭:把正文頁同步生成一份原路徑.md或index.html.md,並在 CDN 或服務端加上Link: </docs/quickstart.html.md>; rel="alternate"; type="text/markdown", </docs/llms.txt>; rel="describedby",無需改動原 HTML 就能讓客戶端自動發現。
如果你的文檔站用的是現成框架,不必純手寫:Mintlify、GitBook、WordPress(Yoast SEO / AIOSEO)已支持自動輸出,靜態站可直接裝 vitepress-plugin-llms 或 docusaurus-plugin-llms。寫完初稿後,建議結合 用 ChatGPT 寫 README 和技術文檔 的核驗思路,只把 llms.txt 發給一個新會話的智能體提問,測試它能否準確挑出目標連結。
三、在 AI 編程工具裏怎麼讀取和利用 llms.txt
作為調用第三方新庫的開發者,拿到對方官網的 llms.txt 後有三種高頻用法:
- 在 Cursor 裏掛進文檔索引:把目標庫的
/llms.txt或/llms-full.txt地址添加到@Docs自定義文檔源,讓補全和 Agent 引用最新接口; - 在 Claude Code 或 Codex 裏按需拉取:在提示詞裏直接給出庫文檔的
/llms.txt連結,讓智能體先讀目錄再抓取對應章節的.md頁面,或者搭配 Claude Code 配 Context7 MCP 查最新文檔 自動注入版本化文檔; - 與倉庫內
AGENTS.md分工:llms.txt放在外部文檔站給訪問者讀,而自己代碼倉庫裏的構建命令和目錄規範則寫在AGENTS.md或CLAUDE.md裏(見 AGENTS.md 怎麼寫)。
日常用 Claude Code、Codex 或 ChatGPT 處理新框架升級和長文檔檢索時,若免費額度不夠用,可在本站查看 Claude Code 訂閱充值 或 ChatGPT Plus 充值。
常見問題
問:放了 llms.txt 會禁止未列出的頁面被爬蟲抓取嗎?
答:不會。llms.txt 只做主動推薦和上下文導航,沒有任何訪問攔截作用;控制爬蟲准入依然靠 robots.txt。
問:為什麼不按 RFC 8615 放在 /.well-known/ 目錄下?
答:v2 規範專門解釋過:/.well-known/ 只能由域名根目錄控制,像託管在子路徑下的 GitHub Pages 項目站根本沒權限寫根目錄;允許在任意子路徑放 llms.txt 才能像 index.html 一樣誰發佈誰維護。
問:列表項冒號後面的說明文字是必填的嗎?
答:不是必填,單寫 - 標題 也符合語法,但官方強烈建議加上英文冒號和簡短說明,否則智能體光看標題很難判斷是否值得花 token 點進去讀。
問:配置好開發環境後,國內沒有外幣卡怎麼開通 Claude 或 ChatGPT 編程訂閱?
答:可在 本站充值中心 自助選購卡密開通 Claude Code(Pro / Max) 或 ChatGPT Plus / Pro,全程無需交出帳號密碼,支持開具增值稅發票;實時價格與售後邊界(封號不在質保範圍)以對應商品頁為準。
相關教學
- Claude Code 配 Context7 MCP 查最新文檔:兩種安裝方式、use context7 怎麼寫、指定庫和版本
- AGENTS.md 怎麼寫:規範、模板,以及 Cursor、Copilot、Trae、Kiro、Cline 各自怎麼讀
- 用 ChatGPT 寫 README 和技術文檔:貼代碼和目錄生成初稿,安裝步驟必須親自跑一遍
- 長文檔怎麼問 AI:資料放前面、問題放最後、先引用再回答(官方長文本提示詞技巧)
參考資料
- The /llms.txt file, v2(官方規範站)— https://llmstxt.org/
- OpenAI Codex 官方文檔全量索引 — https://learn.chatgpt.com/docs/llms-full.txt
- Google Gemini API 官方文檔索引 — https://ai.google.dev/gemini-api/docs/llms.txt
0 條評論
還沒有評論,來搶沙發~