
結論先說
- 分清四個概念只要問一句話:「到底是誰拍板觸發它?」——Tools 由大模型自主調用,Resources 由宿主應用或用戶按需掛載,Prompts 由用戶顯式點選,Sampling 則由伺服器反向向客戶端借模型算力。
- 前三個是服務端原語(客戶端去調伺服器),第四個 Sampling 是客戶端原語(伺服器反過來調客戶端),方向正好相反。
- 論跨客戶端兼容性,Tools 是絕對主力:幾乎所有支持 MCP 的軟件都完整支持 Tools,而 Resources、Prompts 和 Sampling 在部分編輯器裏支持不全或入口較深。
- 實戰開發經驗是「Tools 保底,其餘增強」:核心讀寫邏輯優先做成 Tools,再把高頻背景文檔補成 Resources、把固定提問流程補成 Prompts。
- 主力模型訂閱與帳號配套入口:跑通 MCP 工具鏈與多文件智能體編碼依賴穩定的底層大模型配額,國內免境外卡自助開通可見本站 Claude Code 訂閱頁、ChatGPT Plus 充值頁 與 AI 會員充值總覽。
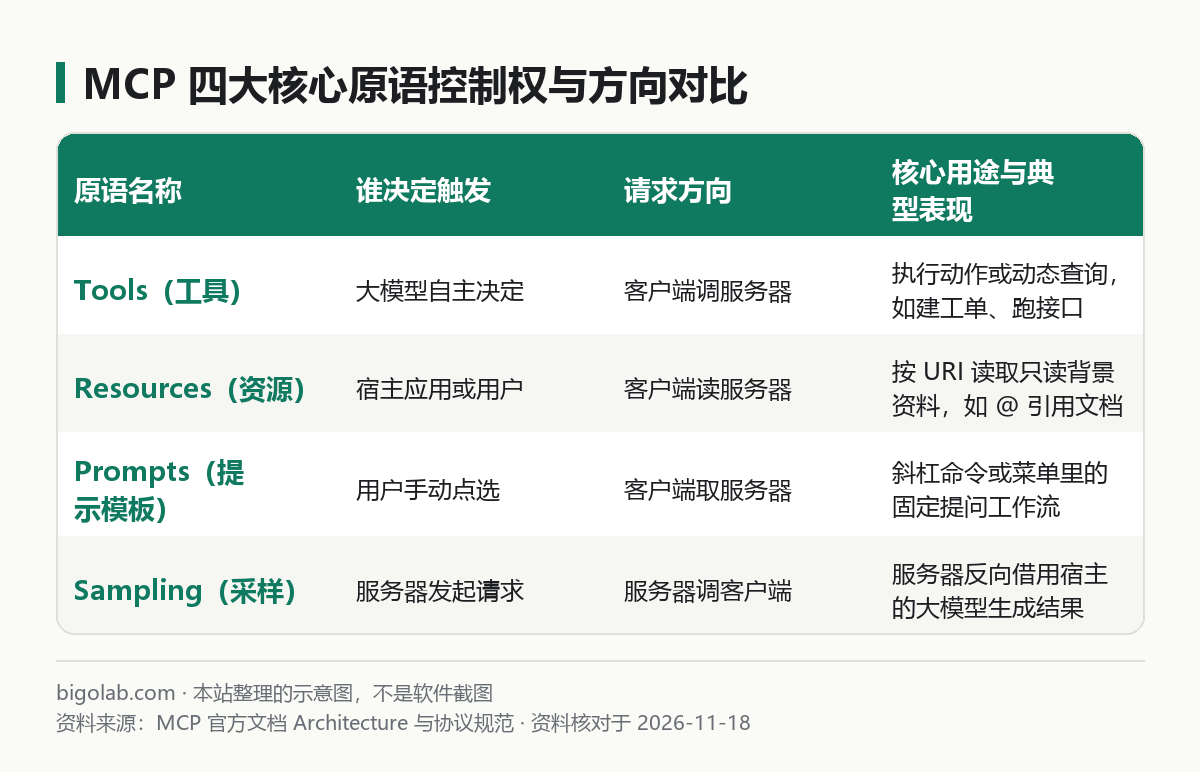
圖:本站根據 MCP 官方文檔:Architecture overview 整理的對比示意圖
本文根據 MCP 官方文檔《Architecture overview》及協議規範《Tools》《Resources》《Prompts》《Sampling》整理,資料核對於 2026-11-18。配圖為本站整理的示意圖,不是介面截圖。本站(bigolab.com)不是 Anthropic 或 MCP 官方網站。
適用於誰
- 看文檔時被各種概念繞暈,搜「mcp resources prompts tools 區別」想快速理清關係的開發者;
- 準備動手寫自己的 MCP 伺服器,拿不準「查數據庫表結構」該做成 Resource 還是 Tool 的人;
- 聽說過 Sampling(採樣),不確定為什麼伺服器還能反過來調用客戶端大模型的人。
如果還不了解協議的整體角色劃分,可以先讀 MCP 是什麼:Model Context Protocol 入門。
一、服務端暴露的三大原語:按控制權一眼分清
MCP 官方規範在每個原語章節的第一段都明確標出了它的控制模型(Control Model),這是理解設計初衷最準確的鑰匙:
1. Tools(工具):模型主導(Model-controlled)
- 協議方法:
tools/list(發現工具列表)、tools/call(執行指定工具)。 - 工作方式:客戶端在對話開始時把工具的名稱、描述和參數 JSON Schema 交給大模型。聊到一半模型覺得需要查訂單、改配置或發通知時,自己決定發起調用並填好參數。
- 類比後端接口:近似於帶動作或動態參數的
POST請求,允許產生外部副作用(因此客戶端通常會彈出人工確認框)。
2. Resources(資源):應用與用戶主導(Application-driven)
- 協議方法:
resources/list、resources/read、resources/subscribe(訂閱變更)。 - 工作方式:伺服器用類似網址的自定義 URI(例如
file:///logs/app.log或postgres://db/users/schema)暴露只讀文本或二進制數據。注意模型自己並不能主動去拉取 Resource,必須由用戶在輸入框裏用@引用、在附件選單裏勾選,或者由宿主程序自動拼進上下文。 - 類比後端接口:近似於純粹只讀、無副作用的靜態或模板化
GET數據源。
3. Prompts(提示模板):用戶主導(User-controlled)
- 協議方法:
prompts/list、prompts/get。 - 工作方式:伺服器預先寫好帶變量槽位的標準提問模板(例如「按團隊規範審查指定提交」)。用戶在客戶端輸入框敲斜槓命令(如 Claude Code 裏的
/mcp__伺服器名__模板名)或點選單選中它、填入參數後,伺服器把組裝好的消息列表返回給客戶端開啟對話。 - 和本地規則的區別:如果你想對比它和本地技能文件的邊界,見 Skill 和 MCP 的區別是什麼。
二、反向流動的客戶端原語:Sampling 是幹什麼的
前三個原語都是「客戶端向伺服器要東西」,而 Sampling(採樣) 屬於客戶端向伺服器開放的能力,協議方法是 sampling/createMessage。
設想你在寫一個複雜的代碼靜態分析 MCP 伺服器,工具跑完規則掃描後,需要一段自然語言歸納修復建議:
- 沒有 Sampling 時:你的 MCP 伺服器內部必須自己申請並配置一份 OpenAI 或 Claude 的 API Key,自己付帳單去調大模型接口,別人裝你的開源伺服器也得跟着配一遍密鑰。
- 有了 Sampling 後:MCP 伺服器直接順着現有的連接,給宿主客戶端發一條
sampling/createMessage請求,說「請用你當前已登入的大模型幫我總結這段掃描結果」。按官方規範建議,客戶端會在介面提示用戶審核這條採樣請求和返回結果,既省掉了服務端配密鑰的麻煩,又讓安全控制權留在用戶手裏。
順帶一提,客戶端原語裏還有兩個常和 Sampling 一起出現的配角:Roots(客戶端告訴伺服器允許訪問哪些本地目錄邊界)和 Elicitation(伺服器執行到中途發現缺關鍵資訊,反向彈窗請用戶補填表單)。
三、自己開發 MCP Server 時怎麼選型不返工
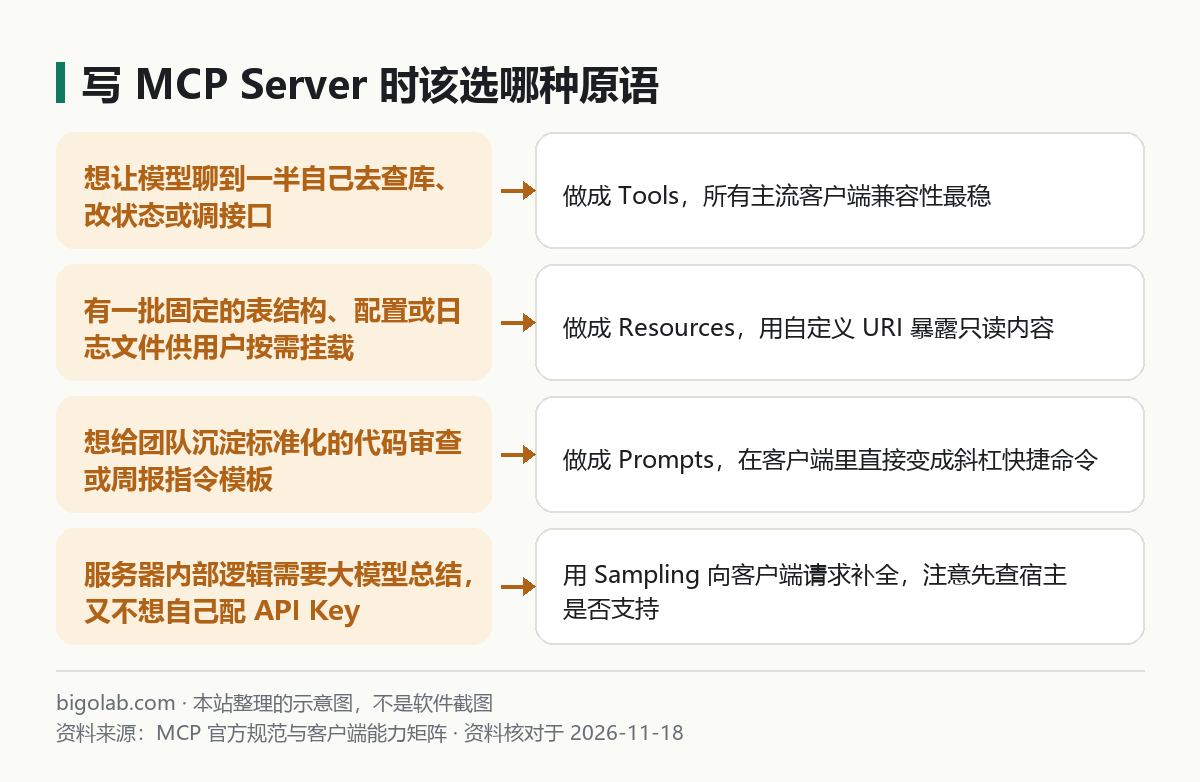
圖:本站根據 MCP 官方協議規範 整理的開發選型示意圖
如果只看理論很容易把只讀查詢全寫成 Resources,結果接進某些編輯器後發現模型根本讀不到。結合目前主流客戶端的實際支持度,按下面三條原則選型最穩妥:
- 需要模型自動按需查閱的數據,依然要提供對應的 Tool:比如「按表名查字段結構」,哪怕它是純只讀操作,也建議提供一個
get_table_schema的 Tool(標上readOnlyHint: true),同時再額外掛一份 Resource 供習慣手動@引用的用戶直接塞上下文。Python 代碼裏的具體裝飾器寫法見 MCP Server 開發入門(Python)。 - 用 Claude Code 體驗完整的三原語聯動:在終端工具裏,Claude Code 對 Tools 自動調用、
@引用 MCP Resources 以及/mcp__斜槓觸發 Prompts 都做了原生適配(配置細節見 Claude Code MCP 配置教學);如果你在網頁或桌面端搭配多連接器高頻使用,也可以開通 Claude Pro 解鎖完整連接器配額。 - 寫 Sampling 前必須做降級兼容:在初始化握手階段檢查客戶端
capabilities裏是否聲明瞭sampling。很多輕量客戶端暫未實現採樣接口,服務端代碼裏應當在不支持時優雅退回返回原始結構化數據,並先用 MCP Inspector 怎麼用 模擬測試請求。
常見問題
問:Resources 和直接讓模型調 read_file 工具有什麼本質差別?
答:調 read_file 工具是模型自己猜路徑、多花一輪工具調用去讀;而掛 Resource 是你在發消息那一刻就明確把指定資料釘進當前提問上下文裏,零猜測、少一次往返,適合你很清楚模型必須看哪份文檔的場景。
問:MCP 裏的 Prompts 和我平時存的提示詞片段有什麼不同?
答:普通提示詞只是純文本粘貼;MCP 的 Prompts 運行在服務端,接收你填入的參數後,可以在服務端動態拉取最新代碼 diff 或數據庫日誌,現場拼裝成圖文並茂的多條上下文消息再發給模型。
問:開啟 Sampling 後,惡意的 MCP 伺服器會不會在後台偷偷刷光我的模型額度?
答:MCP 官方《Sampling》規範明確要求客戶端實現「人在迴路(Human-in-the-loop)」控制:發起採樣前應當讓用戶看到提示詞內容並手動批准,同時允許用戶限制最大輸出 Token 數。遇到來路不明的伺服器,拒絕採樣請求即可。
問:配置好開發環境後,國內沒有外幣卡怎麼開通 Claude 或 ChatGPT 編程訂閱?
答:可在 本站充值中心 自助選購卡密開通 Claude Code(Pro / Max) 或 ChatGPT Plus / Pro,全程無需交出帳號密碼,支持開具增值稅發票;實時價格與售後邊界(封號不在質保範圍)以對應商品頁為準。
相關教學
- MCP 是什麼:Model Context Protocol 入門,以及在 Claude 裏怎麼用
- Skill 和 MCP 的區別是什麼:再加上子代理、Hook、CLAUDE.md,到底該選哪個
- MCP Server 開發入門(Python):用官方 SDK 寫第一個 MCP 伺服器並調試
- Claude Code MCP 配置教學:claude mcp add、配置文件位置與常用 MCP
- MCP Inspector 怎麼用:安裝、啟動命令、調試 MCP 伺服器與 v2 的變化
參考資料
- MCP 官方文檔:Architecture overview — https://modelcontextprotocol.io/docs/learn/architecture
- MCP 協議規範:Tools — https://modelcontextprotocol.io/specification/2025-11-25/server/tools
- MCP 協議規範:Resources — https://modelcontextprotocol.io/specification/2025-11-25/server/resources
- MCP 協議規範:Prompts — https://modelcontextprotocol.io/specification/2025-11-25/server/prompts
- MCP 協議規範:Sampling — https://modelcontextprotocol.io/specification/2025-11-25/client/sampling
0 條評論
還沒有評論,來搶沙發~