
結論先說
- Sequential Thinking MCP 本身沒有任何推理算力,它是官方
modelcontextprotocol/servers裏的一個參考伺服器,本質是給模型提供一個「記步草稿本」工具。 - 它的原理是靠多輪工具調用逼模型分步想:模型每想一步就調一次
sequentialthinking工具,伺服器把步數和分支記在內存裏返回狀態,直到模型把nextThoughtNeeded設為false才輸出最終答案。 - 如果你主力用支持原生思考的模型,日常沒有必要再裝它:Claude Sonnet / Opus、GPT Thinking、Gemini 3 等模型已在單次請求內自帶深度推理,疊加該工具反而會增加多輪上下文重發開銷與等待時間。
- 只有兩類場景還用得上:一是調用不具備原生思考能力的本地小模型或早期接口;二是需要把修訂(Revision)和分支(Branching)過程強制留在客戶端工具日誌裏備查。
- 主力模型訂閱與帳號配套入口:跑通 MCP 工具鏈與多文件智能體編碼依賴穩定的底層大模型配額,國內免境外卡自助開通可見本站 Claude Code 訂閱頁、ChatGPT Plus 充值頁 與 AI 會員充值總覽。
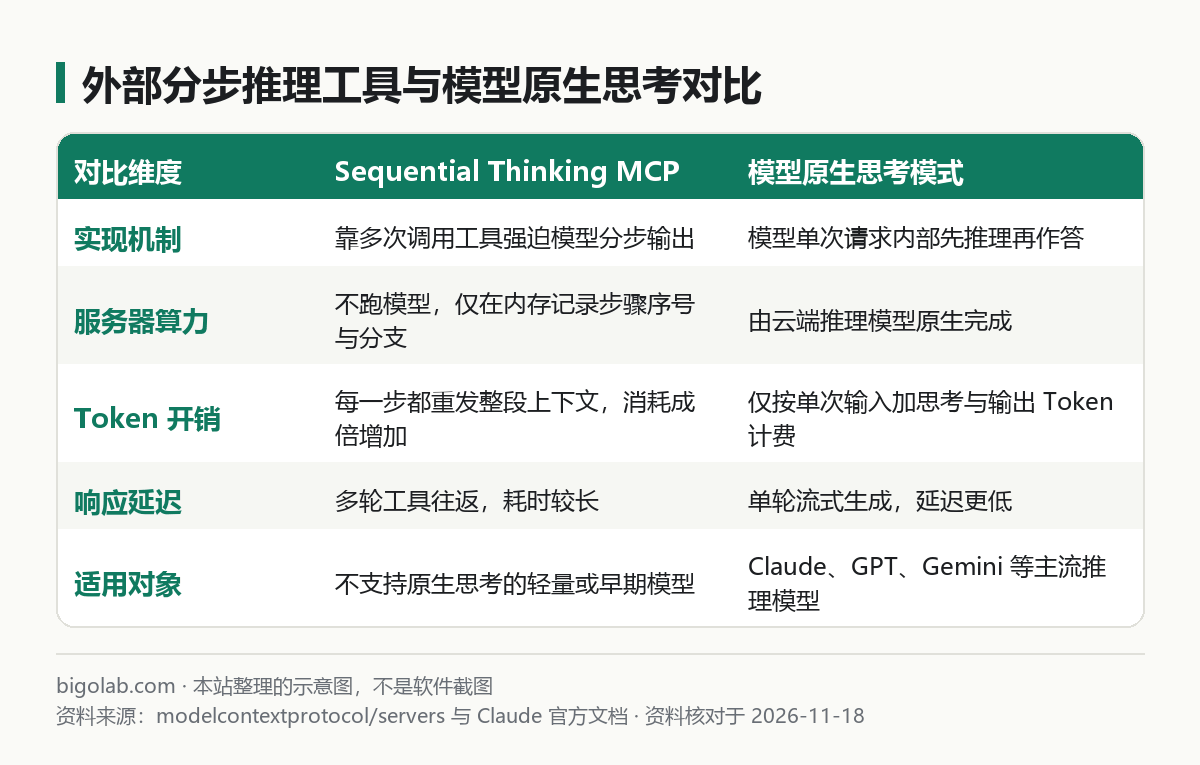
圖:本站根據 Sequential Thinking MCP Server 官方說明 與 Anthropic 官方文檔整理的示意圖
本文根據 MCP 官方參考倉庫《Sequential Thinking MCP Server》《modelcontextprotocol/servers》與 Anthropic 官方文檔《Extended thinking》整理,資料核對於 2026-11-18。配圖為本站整理的示意圖,不是介面截圖。本站(bigolab.com)不是 Anthropic 或 MCP 官方網站。
適用於誰
- 在各種「必裝 MCP 清單」裏看到 Sequential Thinking,搜「sequential thinking mcp」想弄清它到底幹什麼的人;
- 裝上之後發現每次提問都要連調五六次工具、回覆變慢且額度掉得很快的人;
- 分不清這類外部推理工具和 Claude 擴展思考、GPT Thinking 等模型原生思考有什麼區別的開發者。
一、Sequential Thinking MCP 到底是怎麼工作的
打開官方倉庫 src/sequentialthinking 的說明可以看到,這個伺服器只向客戶端暴露一個名為 sequentialthinking 的工具。很多新手誤以為裝了它等於外掛了一個推理引擎,其實伺服器端既不聯網也不調用其他大模型,只負責接收並校驗一組結構化字段:
| 參數名 | 是否必填 | 官方定義作用 |
|---|---|---|
thought | 必填 | 當前這一步的思考文本,可以是分析、驗證或對前一步的修正 |
thoughtNumber | 必填 | 當前是第幾步(正整數,如 1、2、3) |
totalThoughts | 必填 | 當前預估一共需要多少步(後續可隨時動態調大或調小) |
nextThoughtNeeded | 必填 | 布爾值,設為 true 則繼續調下一步,設為 false 則結束思考 |
isRevision / revisesThought | 可選 | 標記當前步驟是在推翻並修正前面的第幾步思考 |
branchFromThought / branchId | 可選 | 從前面某一步分叉出另一條備選方案繼續推演 |
它的完整運行閉環是:模型收到複雜問題後,先發起第一次工具調用填入第 1 步想法;本地進程把這個步驟存進內存列表,並把當前總步數、分支數拼成一段簡短 JSON 返回給客戶端;客戶端再把整段歷史連同返回值發回給模型,觸發第 2 步工具調用。如此循環數次,模型才真正開口回答用戶。
二、和模型原生思考模式有什麼區別
在 MCP 剛發佈時,不少主力對話模型還沒有開放原生的推理塊,靠工具調用來強制拆解步驟確實能減少漏想。但到了 2026 年,主流模型幾乎都內置了經過強化學習訓練的原生思考能力(例如 Claude 的 Extended Thinking、ChatGPT 的 Thinking 檔位、Gemini 3 的 thinking_level)。兩者的核心差異集中在三點:
- Token 計費與額度消耗不同:原生思考在一次 API 請求或一次對話回合內完成,輸入提示詞只算一次;而 Sequential Thinking MCP 每走一步就是一次新的模型請求,前面累積的對話歷史、系統指令和所有工具定義都要重新作為輸入發一遍。如果連走 6 步,輸入側的上下文消耗就會翻好幾倍。
- 推理連續性不同:按 Anthropic 官方《Extended thinking》說明,原生思考塊在模型內部連續生成,並帶有加密簽名保持多輪推理一致性;外部工具則是把自然思維硬切成 JSON 字符串參數,模型還要分神兼顧參數格式校驗。關於提示詞思維鏈與原生思考模式的取捨,可延伸看 思維鏈提示詞還有用嗎 與 Claude API 擴展思考參數怎麼設。
- 上下文污染不同:Sequential Thinking 每一步傳出的長串 JSON 參數都會留在當前會話歷史裏,對話聊不了幾輪就容易把窗口塞滿。
三、現在還有沒有必要安裝(選型判斷)
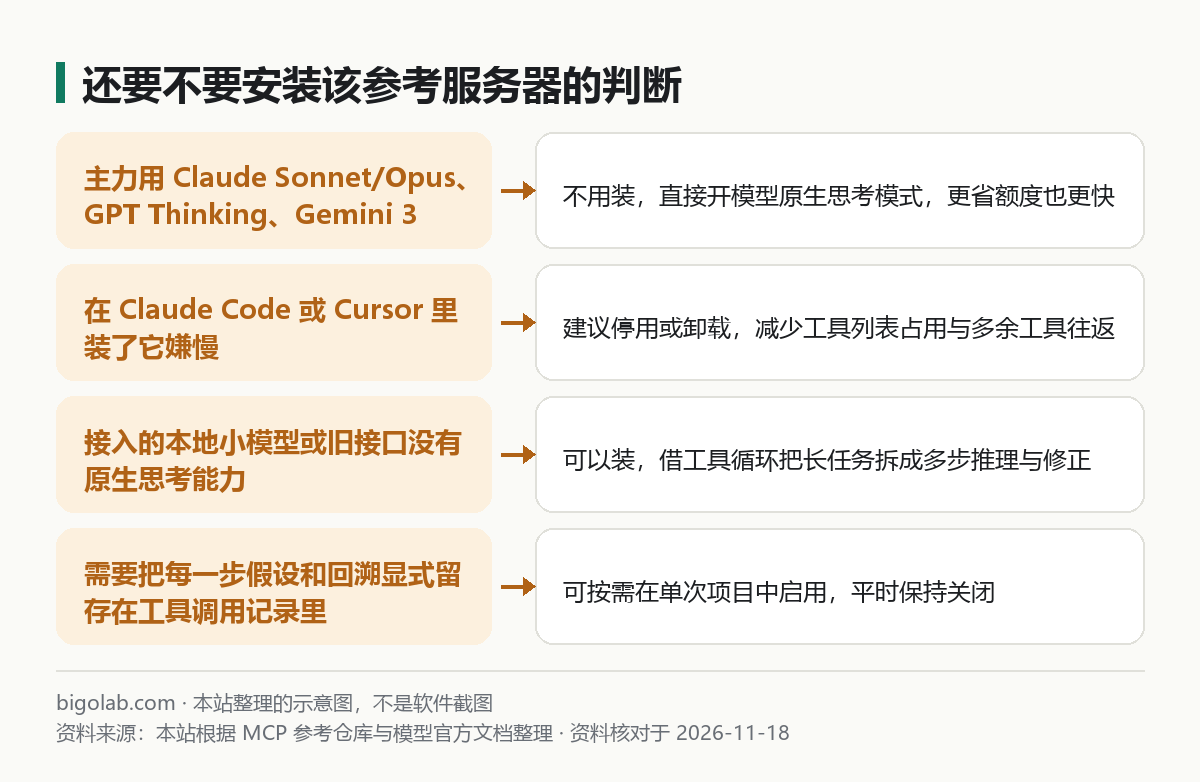
圖:本站根據 modelcontextprotocol/servers 官方倉庫 整理的選型示意圖
本站根據上述機制給出的實用建議很明確:
- 直接不裝或停用的情況:你在用 Claude Desktop、Claude Code、Cursor 或 Codex,且底層選的是自帶思考模式的現代模型。若你的免費帳號因為頻繁跑多步工具很快觸頂,與其掛着這個工具耗額度,不如把它關掉,需要重度推理與寫代碼時直接升級支持 Opus 與更高用量的 Claude Pro 或使用 Claude Code。
- 值得保留的情況:你在本地用客戶端連接沒有思考模式的輕量開源模型、舊版兼容接口,或者你在調試智能體工作流,希望把模型每次推翻重來的「修訂步號」明明白白打印在終端標準錯誤日誌裏用於覆盤。
四、如果確實要用,官方標準配置怎麼寫
包名是 @modelcontextprotocol/server-sequential-thinking,需要本機裝有 Node.js(支持 npx)或 Docker。
1. Claude Desktop(claude_desktop_config.json)寫法
json
{
  "mcpServers": {
    "sequential-thinking": {
      "command": "npx",
      "args": [
        "-y",
        "@modelcontextprotocol/server-sequential-thinking"
      ],
      "env": {
        "DISABLE_THOUGHT_LOGGING": "false"
      }
    }
  }
}
官方說明預設會在標準錯誤流打印帶顏色排版的每步思考內容;如果你不希望日誌文件塞滿思考文本,把環境變量 DISABLE_THOUGHT_LOGGING 設為 "true" 即可關閉日誌輸出。配置文件路徑與重啟方法見 Claude Desktop MCP 配置教學。
2. Claude Code 一行命令添加與移除
在終端添加:
bash
claude mcp add sequential-thinking -- npx -y @modelcontextprotocol/server-sequential-thinking
如果你以前跟風裝過、現在想刪掉省上下文,直接運行移除命令即可:
bash
claude mcp remove sequential-thinking
更多作用域和排錯方式見 Claude Code MCP 配置教學。
常見問題
問:卸載 Sequential Thinking MCP 後,Claude 就不會一步步推理了嗎?
答:不會。只要你在介面打開擴展思考(Extended thinking)或使用預設帶推理能力的模型,它依然會在回答前先做完整的內部推理,而且速度更快、更省額度。
問:為什麼裝了以後有時候模型根本不調用它?
答:MCP 工具由模型自主決定何時調用(具體機制見 MCP 是什麼)。遇到簡單問題模型會直接作答;若你在測試環境下想強制觸發,需要在提問末尾明確寫出「請使用 sequentialthinking 工具分步分析」。
問:Windows 上用 npx 啟動報找不到命令怎麼辦?
答:部分客戶端子進程找不到 npx.cmd,在 Windows 配置裏可以把 "command" 改成 "cmd","args" 寫成 ["/c", "npx", "-y", "@modelcontextprotocol/server-sequential-thinking"]。
問:配置好開發環境後,國內沒有外幣卡怎麼開通 Claude 或 ChatGPT 編程訂閱?
答:可在 本站充值中心 自助選購卡密開通 Claude Code(Pro / Max) 或 ChatGPT Plus / Pro,全程無需交出帳號密碼,支持開具增值稅發票;實時價格與售後邊界(封號不在質保範圍)以對應商品頁為準。
相關教學
- Claude API 擴展思考(extended thinking)參數怎麼設:adaptive、budget_tokens、effort 和 display
- 思維鏈提示詞還有用嗎:「一步一步思考」什麼時候寫、思考模式什麼時候開
- Claude Desktop MCP 配置教學:claude_desktop_config.json 在哪、怎麼寫、不生效怎麼查
- Claude Code MCP 配置教學:claude mcp add、配置文件位置與常用 MCP
- MCP 是什麼:Model Context Protocol 入門,以及在 Claude 裏怎麼用
參考資料
- Sequential Thinking MCP Server 官方說明:https://github.com/modelcontextprotocol/servers/tree/main/src/sequentialthinking
- MCP 官方參考伺服器倉庫:https://github.com/modelcontextprotocol/servers
- Anthropic 官方文檔:Extended thinking — https://platform.claude.com/docs/en/build-with-claude/extended-thinking
0 條評論
還沒有評論,來搶沙發~