
结论先说
- 选型很简单:偏前端 / Node / Go 栈、希望单机跑高并发且直接嵌进 CI 门禁优先用 k6;偏 Python 栈、需要复用复杂鉴权或自定义协议逻辑优先用 Locust。两款工具都能让 Codex 基于项目路由定义或 OpenAPI 规范快速生成规范脚本。
- 合格的压测脚本必须包含四要素:梯度加压(Ramp-up)、多用户数据参数化、合理思考时间(Think Time)与显式失败阈值(Thresholds)。如果几百个虚拟用户循环打同一个商品 ID,打中的全是内存热缓存,测出来的吞吐严重失真。
- 解读报告别只盯平均值(Avg),重点看「吞吐(RPS)拐点 + P50 与 P99 剪刀差 + 错误率」。平均值很容易掩盖 1% 的长尾超时;当 P50 很低而 P99 骤升时,根因往往在锁竞争、GC 停顿、慢查询或下游限流排队。
- 把压测汇总 JSON 与服务端监控(CPU、连接池、慢 SQL)一起喂给 Codex 只读归因,先锁定真实瓶颈再单点优化(完整调优闭环可搭配 /guides/codex-optimize-slow-api-frontend-profiling-baseline);所有写接口压测务必在隔离预发环境进行,严禁直打生产主库。
- 在压测调优期需要反复生成场景脚本、分析多轮压测汇总与追踪慢调用链,上下文配额消耗较快。国内没有外币卡的开发者可在本站自助开通 ChatGPT Plus 充值 或无 5 小时限额的 ChatGPT Pro 充值,团队多人研发协同可咨询 ChatGPT Business 团队定制。
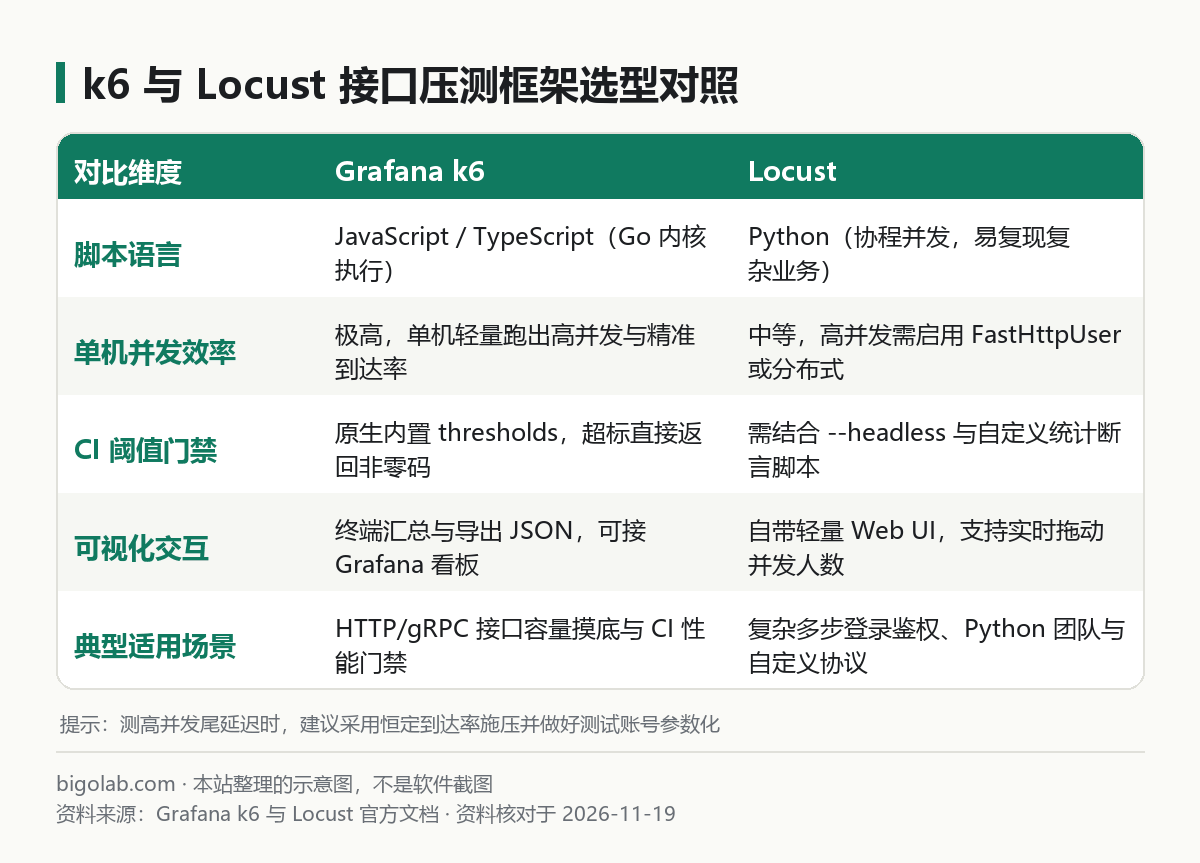
图:本站根据 Grafana k6 官方文档 与 Locust 官方文档 整理的对照示意图
本文根据 OpenAI Codex 官方文档《Codex CLI》《Non-interactive mode》、Grafana k6 官方文档及 Locust 官方文档整理,资料核对于 2026-11-19。配图为本站整理的示意图,不是界面截图。本站(bigolab.com)不是 OpenAI 官方网站。
适用于谁
- 准备迎接促销大促、新品发布或接入高并发外部调用,需要提前摸清登录、下单、查询等核心接口容量上限的后端与测试开发工程师;
- 平时只拿单个固定参数敲
ab或curl测吞吐,结果上线后真实流量一打就出现 P99 飙升与数据库连接池告警的研发人员; - 希望把 k6 或 Locust 压测脚本、阈值门禁与性能瓶颈归因固化为日常发版前标准流程的团队。
一、让 Codex 基于接口定义生成规范压测脚本
先让 Codex 只读查看你的路由文件或 openapi.yaml,再明确给出流量配比、参数化来源与目标 SLA,一次性产出可执行的 k6 或 Locust 脚本:
text
请先只读检查 src/routes/orders.ts 与 docs/openapi.yaml 中核心下单与查询接口的请求契约,在 loadtests/ 下生成 k6 压测脚本 orders-load.js(如果团队是 Python 栈,请改为生成 locustfile.py):
1. 流量场景与梯度加压:使用 stages 配置 30s 预热到 20 VU -> 2m 爬坡到 100 VU -> 3m 稳态保持 -> 30s 降压;读接口与写接口按 8:2 比例混合;
2. 参数化与防缓存失真:通过 SharedArray 从 loadtests/test-users.csv 读取多组测试账号 Token 与商品 ID,禁止所有请求写死同一条记录;
3. 业务校验与硬性阈值:校验 HTTP 200 与返回体业务码成功;设置 thresholds 要求 `http_req_failed < 0.01`、`http_req_duration['p(95)'] < 300`、`http_req_duration['p(99)'] < 800`;
4. 安全防护:目标域名与测试密钥仅从环境变量 `TARGET_BASE_URL` 读取,并在脚本开头拦截误填生产域名的情况。
完成后补充 loadtests/README.md,给出本地执行命令与汇总 JSON 导出参数。
标准执行与结果导出命令
bash
# k6:运行梯度压测并将完整汇总导出为 JSON 供 Codex 诊断
TARGET_BASE_URL="https://staging-api.example.com" \
  k6 run --summary-export=loadtests/summary.json loadtests/orders-load.js

# Locust:无头模式运行 5 分钟并导出 CSV 统计文件
locust -f loadtests/locustfile.py --headless \
  -u 100 -r 10 -t 5m \
  --host https://staging-api.example.com \
  --csv=loadtests/run_report
二、把压测汇总喂给 Codex:读懂吞吐拐点与 P99 尾延迟
跑完压测拿到 summary.json 或 CSV 统计后,不要孤立地只看一张压测表。把同期采集的服务端 CPU 使用率、数据库连接池活跃数与前 10 条慢日志摘要拼在一起,通过管道喂给只读沙箱下的 Codex(管道技巧详见 /guides/codex-cli-pipe-stdin-exec-recipes):
bash
cat loadtests/summary.json loadtests/server-metrics.txt | codex exec \
  --ephemeral \
  --sandbox read-only \
  "这是隔离预发环境 100 并发下的 k6 汇总报告与同期服务端资源摘要。
   请结合 src/services/order.ts 与数据库配置给出诊断:
   1. 评估当前吞吐上限是否已经到达饱和拐点,指出 P50/P95/P99 分布是否出现明显尾延迟分裂;
   2. 交叉比对连接池、CPU、错误码分布与源码逻辑,排出前 3 个最可能的瓶颈根因(区分锁等待、N+1 慢查、连接池枯竭、同步阻塞或下游限流);
   3. 给出验证每个假设所需的下一轮最小定向实验,暂不修改业务代码。"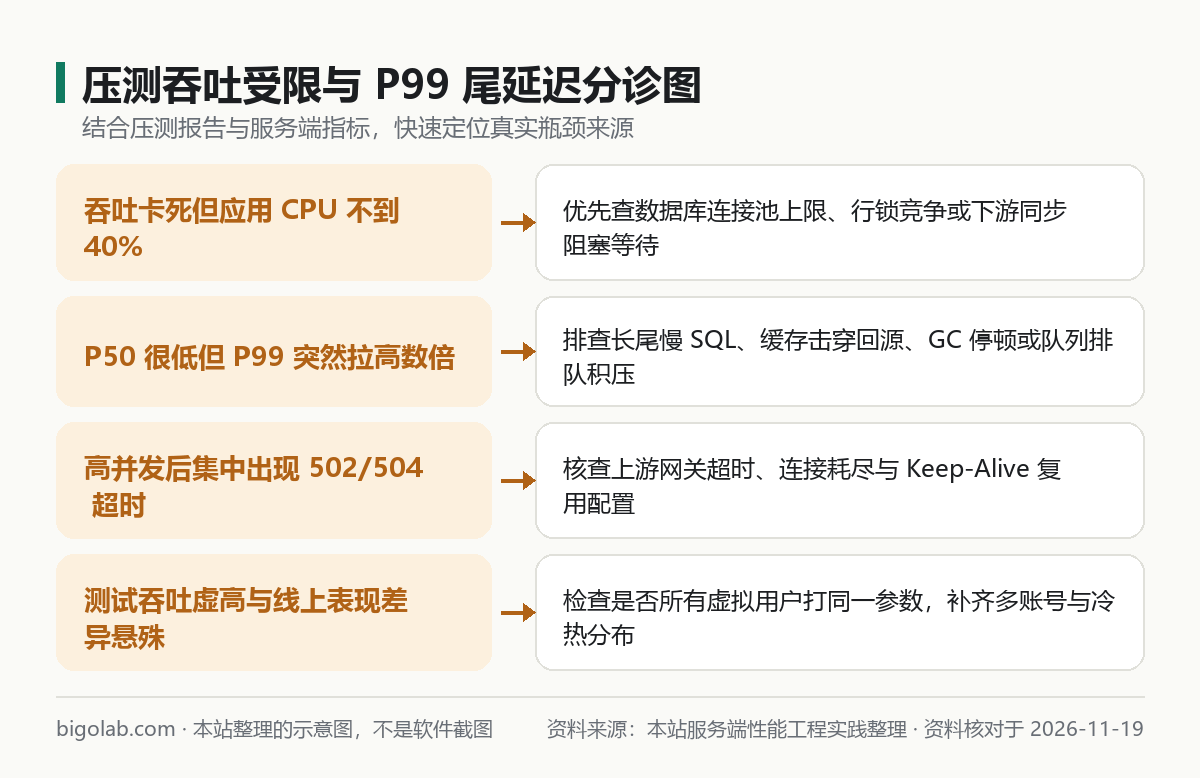
图:本站结合服务端容量评估与性能排障实践整理的瓶颈分诊示意图
订阅与账号准备提示:压测归因常常需要同时读取接口源码、ORM 查询层、连接池配置与多轮压测对比数据,单日高频迭代容易触达 Plus 的 5 小时限额(限额规则见 /guides/codex-usage-limits)。大促前性能攻坚期建议在站内升级 ChatGPT Pro 5x iOS 可覆盖档 或 ChatGPT Pro 5x 信用卡不可覆盖档;新账号首次开通 Codex 如卡在手机验证环节,可查看 Codex 注册手机验证服务。
三、把轻量冒烟压测放进 CI,防止性能静默退化
全量高并发压测通常在独立压测机按需触发,而把一套 30 秒低并发(如 10–20 VU)的冒烟基准压测 接入预发流水线非常划算:
- 在 k6 脚本中通过
thresholds定义基线预算,一旦某次改动意外引入全表扫描或循环串行外部调用,CI 会直接返回非零退出码拦下发版; - 如需在流水线里让 Codex 自动汇总本次与上次发版的 P95/P99 变化并生成评审意见,务必使用
codex exec --ephemeral --sandbox read-only保持构建机无状态与零写权限(配置规范见 /guides/codex-exec-full-auto-ephemeral-ci-pipeline-guide)。
常见问题
问:为什么把并发从 50 VU 提到 200 VU,服务器 CPU 才 30%,吞吐却卡死不再上涨、P99 暴增?
答:这是典型的「非 CPU 阻塞型瓶颈」。优先检查四处:数据库连接池或 HTTP 客户端连接池最大数过小导致大量请求排队、数据库行锁/表锁竞争、Node.js 事件循环被大 JSON 序列化或同步加密卡住,以及压测机自身端口/带宽已打满。
问:k6 里固定虚拟用户(VUs)模式和固定到达率(Constant Arrival Rate)模式有什么区别?
答:固定 VU 模式下如果服务端变慢,每个虚拟用户发下一轮请求的频率会跟着变慢,容易掩盖真实排队雪崩(即协调遗漏问题);测核心接口抗压能力时,建议让 Codex 用 k6 的 constant-arrival-rate 或 ramping-arrival-rate 执行器按恒定每秒请求数施压,更能暴露真实尾延迟。
问:国内没有外币信用卡,或者公司研发团队需要统一采购开具增值税发票,怎么开通 ChatGPT / Codex 订阅?
答:可通过本站 AI 会员充值总览 按需选购 ChatGPT Plus 充值、ChatGPT Plus 自助卡密 或配额更高的 ChatGPT Pro 充值,支持支付宝、微信支付及 AlipayHK,提供卡密自助兑换(无需交出账号密码)与客服协助,并支持开具增值税发票;多人团队也可咨询 Business 团队定制方案。实时价格以商品页展示为准,售后执行掉订阅按剩余天数折退、封号不在质保范围规则。
相关教程
- 用 Codex 优化慢接口与前端首屏性能:先测 Profiling 基线再验证收益
- Codex CLI 管道与标准输入实战:6 个实用命令配方
- Codex codex exec --full-auto 迁移与 --ephemeral 无痕 CI 流水线指南
- Codex 额度与使用限制:Plus / Pro 能用多少与怎么查
参考资料
- OpenAI Codex 官方文档:Codex CLI — https://learn.chatgpt.com/docs/codex/cli
- OpenAI Codex 官方文档:Non-interactive mode — https://learn.chatgpt.com/docs/non-interactive-mode
- Grafana k6 官方文档 — https://grafana.com/docs/k6/
- Locust 官方文档 — https://docs.locust.io/
0 条评论
还没有评论,来抢沙发~