
结论先说
- 没有 Profiling 基线,不要让 Codex 动手改一行优化代码。凭静态阅读代码做「猜测式优化」往往改在只占 2% 耗时的微循环上,真正占 80% 耗时的 N+1 查询、全表扫描或主包阻塞脚本反而被漏掉。
- 先在固定数据集和环境下采集可复现证据。后端准备 p50/p95 耗时、SQL
EXPLAIN (ANALYZE, BUFFERS)与 CPU 采样摘要;前端准备 Lighthouse 指标(TTFB、FCP、LCP、TBT)与打包产物模块体积清单。 - 用只读模式让 Codex 做瓶颈归因与收益估算。将采样输出通过
codex exec --sandbox read-only结合仓库源码分析(管道方式见 /guides/codex-cli-pipe-stdin-exec-recipes),先排出耗时占比前 3 的真瓶颈。 - 坚持单变量改动,并同步验证业务语义等价。每次只实施一项优化(如消除 N+1、拆分子包或补复合索引),复测相同压测或 Lighthouse 场景记录前后对照表,并跑通全部功能测试防缓存脏读或分页错乱。
- 跨前后端检索、分析火焰图摘要与多轮压测回归消耗较多额度。国内缺少外币卡或原套餐限额偏紧时,可在本站自助开通 ChatGPT Plus 充值 或配额更高的 ChatGPT Pro 充值,多人团队可了解 ChatGPT Business 团队定制。
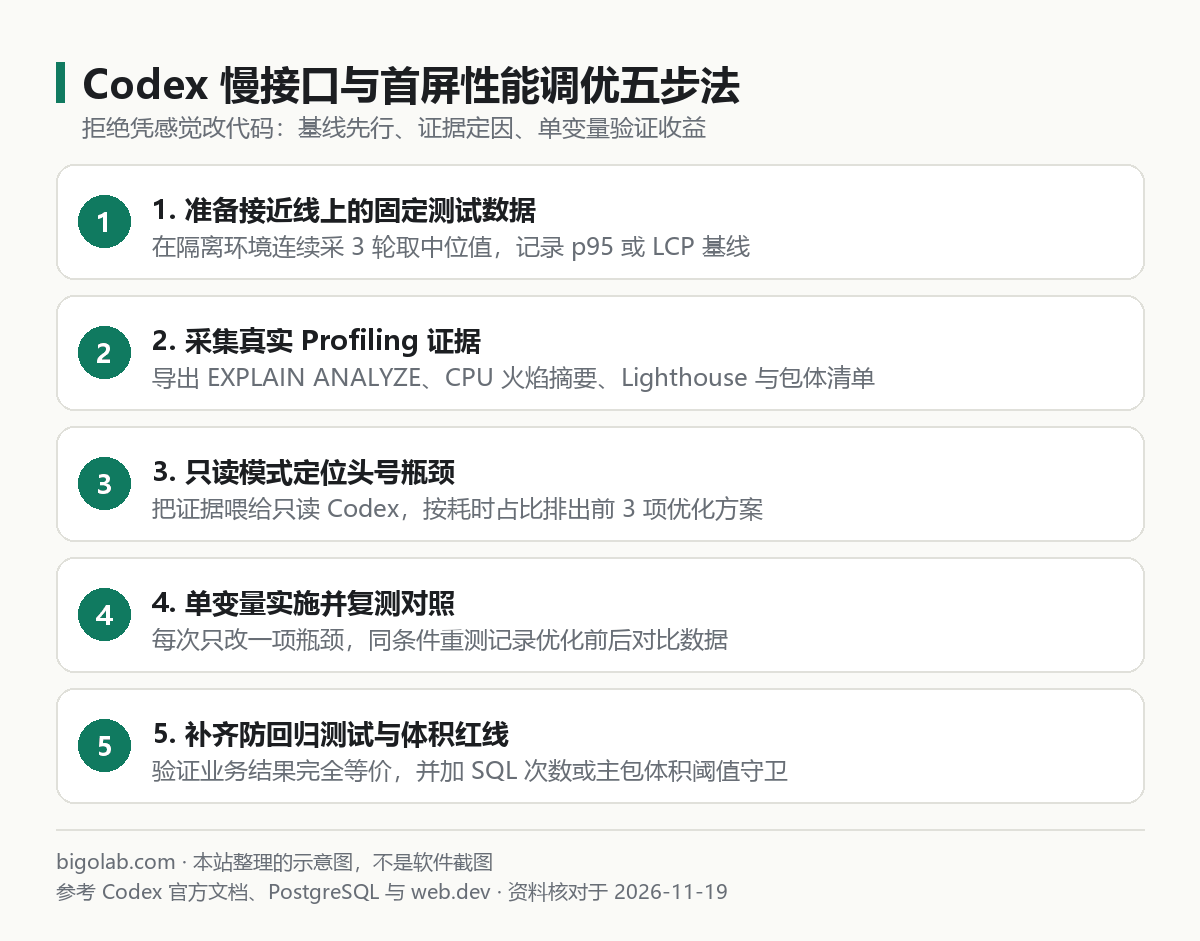
图:本站结合 Codex 官方文档、PostgreSQL 与 Web Vitals 实践整理的示意图
本文根据 OpenAI Codex 官方文档《Non-interactive mode》《Codex CLI》、PostgreSQL 官方文档《Using EXPLAIN》及 web.dev 核心网页指标(Core Web Vitals)指南整理,资料核对于 2026-11-19。配图为本站整理的示意图,不是界面截图。本站(bigolab.com)不是 OpenAI 官方网站。
适用于谁
- 面临核心列表接口响应超 2 秒、数据库连接池打满,或前端首屏白屏偏久、LCP 指标不达标的全栈与前后端工程师;
- 曾让 Codex 凭直觉优化性能,结果把代码改得晦涩难懂、实际耗时却几乎没降的开发者;
- 希望在团队内建立「先量化基线 → 证据定瓶颈 → 单点改写 → 复测对比」科学调优闭环的研发人员。
一、第一步:建立可重复的基线数据与 Profiling 证据
开始优化前,务必准备一套数据量接近线上量级的本地或隔离测试环境(千万不要拿只有 20 行测试数据的空表调优,全表扫描在 20 行时永远看起来很快),至少连续采集 3 轮取中位值作为基线。
后端慢接口基线采集
- 耗时基线:用
hey、wrk或脚本固定并发与参数跑通接口,记下 p50、p95 与吞吐量。 - SQL 瓶颈证据:对慢查询执行
EXPLAIN (ANALYZE, BUFFERS) SELECT ...(切勿带敏感业务数据,并在测试环境执行,避免线上锁表或写操作副作用),保存完整执行计划文本。 - 应用层 CPU / 内存采样:Python 可用
cProfile输出耗时前 20 的函数栈;Node.js 可用--cpu-prof或日志打点拆出「DB 等待 / 外部 HTTP / JSON 序列化」各段耗时。
前端首屏慢基线采集
- Core Web Vitals 指标:在无痕模式运行 Lighthouse 或 Chrome DevTools Performance,记录 TTFB、FCP、LCP、CLS、TBT 及最大 LCP 元素对应资源。
- 请求瀑布流与包体清单:导出首屏加载的串行请求链(Waterfall)以及构建产物最大的 15 个 Chunk 体积(如 Vite / Webpack 构建报告)。
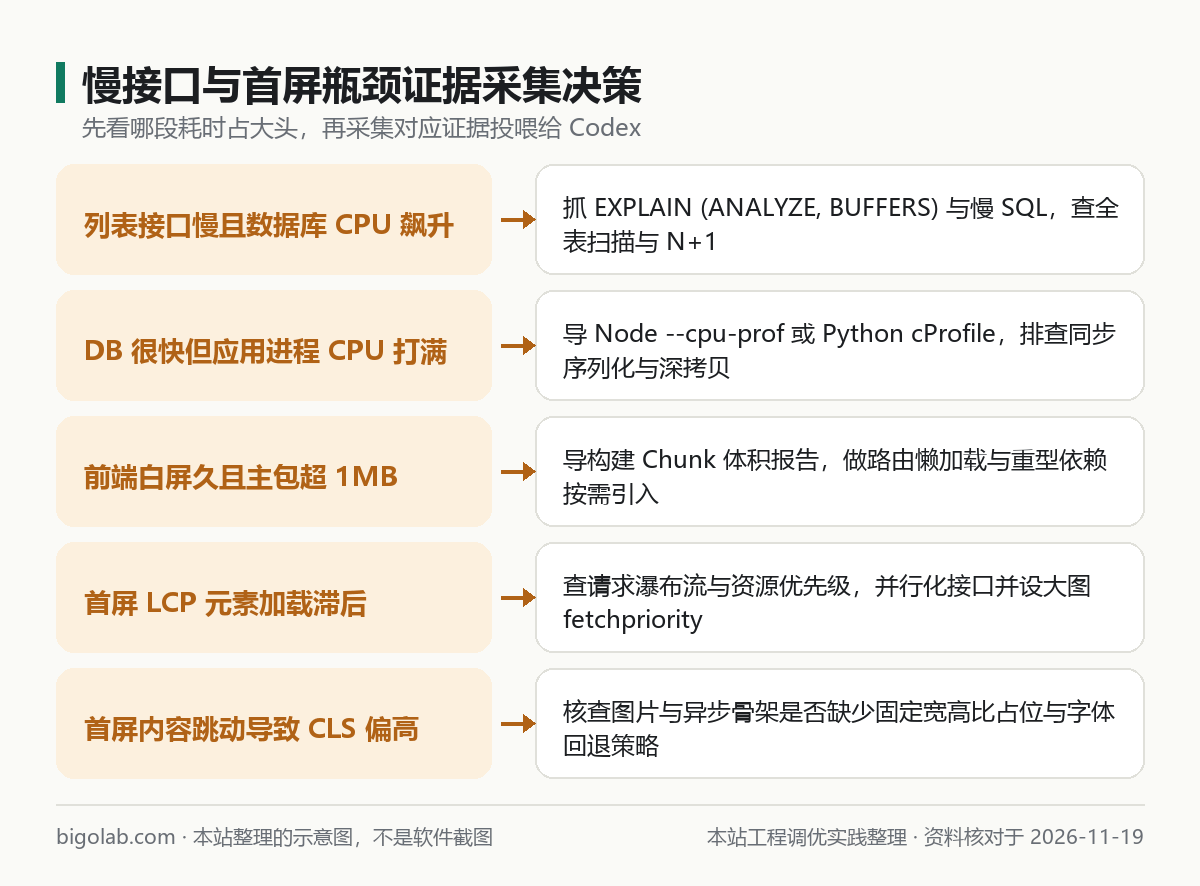
图:本站根据前后端性能工程实践整理的瓶颈定位示意图
二、第二步:只读投喂证据,让 Codex 定位头号瓶颈并出方案
拿到真实 Profiling 文本后,先不要急着让模型改代码,使用只读沙箱(安全设置参考 /guides/codex-permissions-sandbox)把基线数据喂给 Codex,要求它基于源码给出带量化预期的改动方案:
后端慢接口诊断命令示例
bash
cat ./explain-order-list.txt | codex exec --sandbox read-only \
  "这是隔离库(100 万行订单)下 GET /api/orders 接口的 EXPLAIN (ANALYZE, BUFFERS) 输出,当前 p95 为 1850ms。
   请结合 src/modules/order/repository.ts 与对应 ORM 模型:
   1. 指出真实耗时大头(如 Seq Scan、回表次数、循环内 N+1 查询或无索引排序);
   2. 给出最多 2 个投入产出比最高的改动方案(含索引定义或批量预加载写法);
   3. 评估改动对写性能、分页排序一致性及内存占用的副作用。暂不修改代码。"
前端首屏优化诊断提示词示例
text
这是首页桌面与移动模拟下的 Lighthouse 摘要与 Vite 构建最大 Chunk 清单:
- LCP: 4.6s(触发元素为首屏 Banner 图,下载晚于主包执行)
- 主入口 bundle: 1.4MB(内含 echarts 全量包与首屏未用到的 Markdown 编辑器)
- 首屏出现 3 次串行接口瀑布(先查用户信息,再查配置,再拉推荐列表)
请先只读检查 src/pages/Home.tsx、src/router.tsx 与 vite.config.ts,按对 LCP 和 TBT 的改善幅度排序,列出 3 项最小侵入式优化步骤,并说明如何避免产生新的布局偏移(CLS)。订阅与账号准备提示:性能调优常涉及跨 ORM、SQL、构建配置与多轮压测对比,上下文较长且消耗额度较快(配额计算规则见 /guides/codex-usage-limits)。重度性能专项治理建议在站内升级 ChatGPT Pro 5x iOS 可覆盖档 或 ChatGPT Pro 5x 信用卡不可覆盖档;新账号首次开通 Codex 如卡在手机验证步骤,可查看 Codex 注册手机验证服务。
三、第三步:单变量实施改动、复测对比与防回归验证
切忌把「加索引 + 上 Redis 缓存 + 改前端代码分割 + 换图片格式」混在一次改动里,否则一旦出现缓存穿透或指标未降反升,你根本不知道哪一项起了反作用。
- 每次只落一项改动并单独自建提交:例如第一步只让 Codex 把 ORM 循环查询改成单次
IN批量预加载或JOIN;前端第一步只做路由级懒加载与首屏核心大图fetchpriority="high"+ 显式宽高占位。 - 用完全一致的环境和脚本复测对比:跑完同样 3 轮压测或 Lighthouse,把「优化前 / 优化后 / 改善幅度」写进 PR 描述。
- 补回归保护防后续退化:用 Codex 补齐关键逻辑测试(参考 /guides/codex-write-tests-and-run),例如断言列表查询执行的 SQL 条数不超过常量阈值(防 N+1 卷土重来),或在前端构建脚本里设置主包体积上限阈值。
常见问题
问:加上缓存后接口确实快了十倍,让 Codex 顺手写 Redis 缓存逻辑有什么常见坑?
答:缓存是最容易引入隐蔽 Bug 的优化手段。如果确需引入缓存,必须明确要求 Codex 同时写清「缓存键命名规范、合理过期时间与随机抖动、写入/更新时的失效策略、以及缓存异常时的降级兜底」,千万不要在未清理底层慢 SQL 前直接靠加一层长时缓存掩盖问题。
问:本地机器性能比线上服务器好,跑出来的绝对耗时和线上不一致,基线还有参考价值吗?
答:有参考价值,前提是保持本地测试的数据量级(例如造出与线上接近的索引基数)和对比条件一致,重点看优化前后的相对降幅、扫描行数(Rows Removed / Buffers Hit)以及请求瀑布流结构变化,而不是死盯本地单机绝对毫秒数。
问:国内没有外币信用卡,或研发团队需要统一采购开具增值税发票,怎么开通 ChatGPT / Codex 订阅?
答:可通过本站 AI 会员充值总览 按需选购 ChatGPT Plus、ChatGPT Plus 自助卡密 或更高配额的 ChatGPT Pro,支持支付宝、微信支付和 AlipayHK,提供卡密自助兑换(无需交出账号密码)与客服协助,并支持开具增值税发票;多人研发团队也可咨询 Business 团队定制方案。实时价格以商品页展示为准,售后执行掉订阅按剩余天数折退、封号不在质保范围规则。
相关教程
- Codex CLI 管道与标准输入实战:喂报错日志自动定位根因的 6 个命令配方
- Codex 权限与沙箱设置:审批模式与只读模式怎么选
- 用 Codex 写测试并跑通:覆盖正常与边界并报告结果
- Codex 额度与使用限制:Plus / Pro 能用多少与怎么查
参考资料
- OpenAI Codex 官方文档:Non-interactive mode — https://learn.chatgpt.com/docs/non-interactive-mode
- OpenAI Codex 官方文档:Codex CLI — https://learn.chatgpt.com/docs/codex/cli
- PostgreSQL 官方文档:Using EXPLAIN — https://www.postgresql.org/docs/current/using-explain.html
- Google web.dev:Web Vitals 核心网页指标 — https://web.dev/articles/vitals
0 条评论
还没有评论,来抢沙发~