
结论先说
- 多服务商共存靠「逐家启用 + 模型能力标签校验」:在「设置 > 模型服务」分别填好各家官方 API Key 并点「检测」,注意核对模型右侧是否亮起视觉(眼睛)、工具调用(扳手)或嵌入(Embedding)图标。
- 搭建本地知识库前必须先配好至少一款嵌入模型:Claude 官方不提供通用文本 Embedding 接口,建库时推荐启用 OpenAI
text-embedding-3-small、Gemini Embedding 或本地 Ollama 的bge-m3。 - 挂载本地
stdio类 MCP 优先使用软件内置的uv与Bun环境:无需自己在系统全局折腾复杂的 Node.js 或 Python 路径,一键初始化内置运行时即可跑通绝大多数uvx和npx命令。 - 对话输入框底部的工具栏决定本轮是否启用知识库与 MCP:建好库和配好 MCP 后,必须在当前聊天窗口底部手动点亮对应的「知识库」和「MCP 服务器」图标才会生效。
- 谷歌密钥准备与官方旗舰会员入口:申请 Gemini API Key 需具备个人谷歌账号,缺号可查看本站 谷歌账号购买说明(含 谷歌邮箱成品号);若高频长上下文对话想用固定月费代替按量账单,可自助开通 Claude Pro 或 ChatGPT Plus。
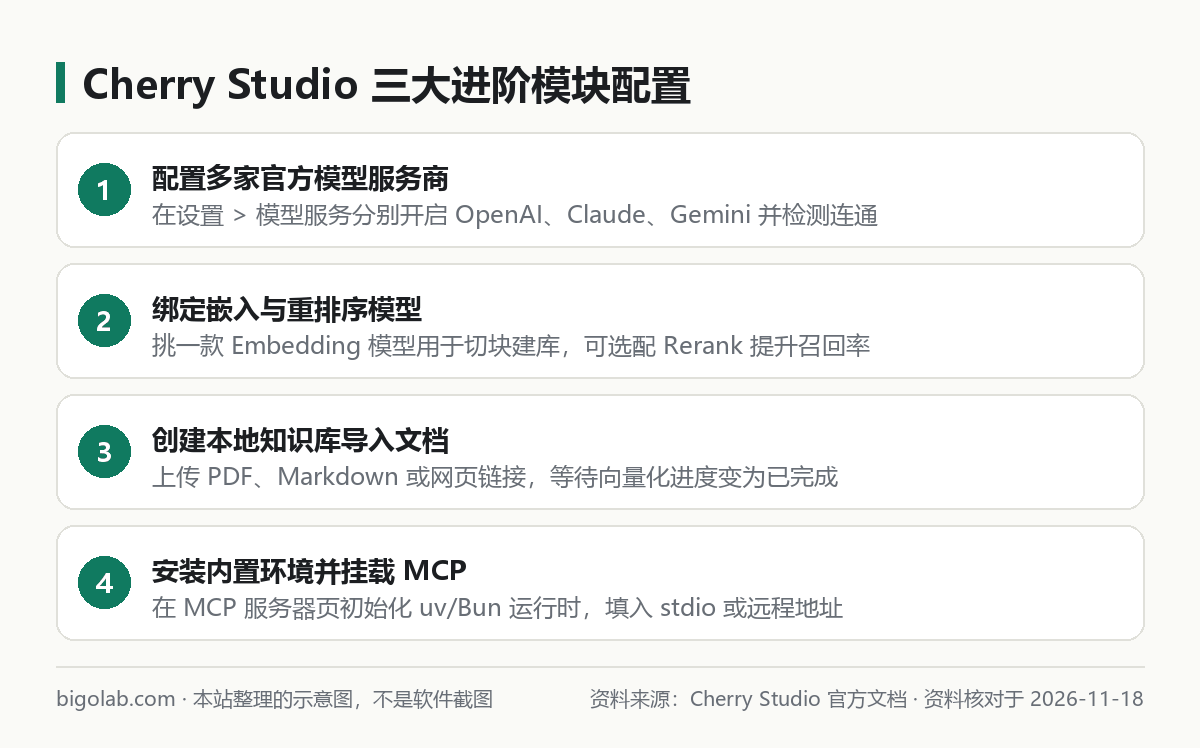
图:本站根据 Cherry Studio 官方文档:模型服务与进阶功能 整理的示意图
本文根据 Cherry Studio 官方文档《模型服务》《知识库》《MCP 服务器》整理,资料核对于 2026-11-18。配图为本站整理的示意图,不是界面截图。本站(bigolab.com)不是 Cherry Studio 或各模型厂商官方网站。
适用于谁
- 不想同时开四五个网页标签,希望在一个桌面软件里随时切换 OpenAI、Claude、Gemini 与 DeepSeek 模型的人;
- 手头有一批 PDF 规范手册、Markdown 笔记或内部接口文档,想在本地切片建立向量知识库做精准问答的用户;
- 想在桌面端给大模型挂载文件系统、网页抓取或数据库 MCP 工具,却卡在
npx/uvx环境报错的新手。
一、同时接入多家官方 API 与同屏对比回答
基础的单服务商接入步骤可参考本站 DeepSeek 接入 Cherry Studio 和 Chatbox。当你同时握有多家官方密钥(申请见 OpenAI API Key 获取 与 Gemini API Key 获取)时,按以下规范统一管理最清爽:
- 点击左下角齿轮「设置(Settings)> 模型服务(Model Provider)」,依次开启
OpenAI、Anthropic、Gemini、DeepSeek或本地Ollama; - 每填完一家 API Key,先点「管理(Manage)」勾选你真正会用到的 2–3 个主力模型(把几十个旧快照模型留在列表外,避免切换菜单冗长),再点右上角「检测(Check)」确认返回绿勾;
- 检查能力图标:若你打算让某个模型调 MCP 工具,点开该模型右侧设置图标,确认已勾选「工具调用(Function Calling / Tools)」能力;
- 一问多答横向比对:回到聊天界面,利用顶部的多模型提及(
@)或分栏对比功能,同一条提示词可同时发给 Claude 与 GPT,直观对比两家的代码方案或文案润色质量。
二、搭建本地知识库:Embedding 选型、切片与 Rerank
Cherry Studio 的本地知识库会把你的文件解析切片并转换成向量保存在本机目录,提问时只把相似度最高的几个片段塞给对话模型:
- 标记嵌入模型:先在任一支持向量的服务商下添加嵌入模型(如 OpenAI 的
text-embedding-3-small、Gemini 的gemini-embedding-001或本地 Ollama 的bge-m3),确认模型名旁带有Embedding标签; - 新建知识库:点击左侧边栏「知识库(Knowledge Base)」图标 >「添加」,输入名称并在下拉框选中刚才配好的嵌入模型(若你配了重排序模型,可同步选上
Rerank模型提升复杂技术问答的排名前三命中率); - 导入多源资料:支持拖入本地
PDF、DOCX、MD、TXT文件,也支持填入公开文档网址或整目录文件夹;右侧状态显示绿勾即代表向量化完成; - 对话挂载:回到聊天窗口,点击输入框下方的「知识库」图标勾选目标库,发问后可在回答底部展开查看具体引用了哪一页原文片段。
开发账号与编程订阅配套提示:若在 Google AI Studio 申请免费或付费层密钥时缺少合规谷歌账号,可前往本站选购带两步验证的 谷歌邮箱成品号;若你在写代码时发现客户端按 Token 调旗舰模型成本过高,也可直接搭配包月制官方编程工具,在本站免外币卡开通 Claude Code 或 ChatGPT Plus。
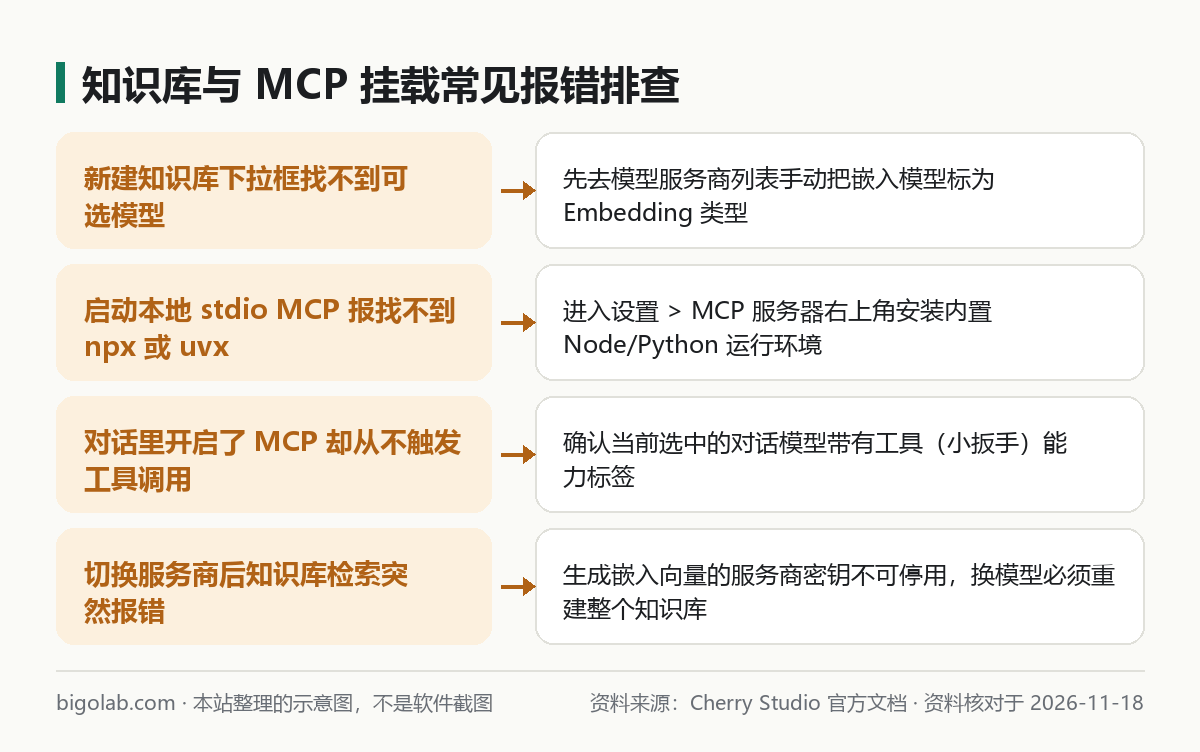
图:本站根据 Cherry Studio 官方文档:知识库与 MCP 服务器 整理的示意图
三、挂载本地与远程 MCP 工具完整步骤
想让客户端具备读写指定本地文件夹、查数据库或抓网页的能力,可接入标准 MCP 服务(协议原理见 MCP 是什么:Model Context Protocol 入门):
- 一键装好内置运行时:进入「设置 > MCP 服务器(MCP Servers)」,点击右上角环境检查按钮,让软件自动下载内置的
uv(跑 Python 类uvx工具)与Bun(替代 Nodenpx跑前端工具),免去 Windows 环境变量找不到命令的烦恼。 - 添加服务器配置:点击「添加服务器」,支持标准输入输出(
stdio)与远程流式(SSE/Streamable HTTP)两种类型。例如挂载官方本地目录读写工具(请将末尾路径替换为你允许访问的单个工作文件夹,切勿挂载整块系统盘):
json
{
  "mcpServers": {
    "filesystem": {
      "command": "npx",
      "args": ["-y", "@modelcontextprotocol/server-filesystem", "D:/work/docs"]
    }
  }
}- 开启开关并在聊天窗挂载:保存后打开该 MCP 右侧开关,看到绿点在线并列出可用
Tools清单即代表握手成功;最后回到聊天输入框底部点亮「MCP」按钮勾选该服务即可调用。
常见问题
问:为什么我新建知识库时,「嵌入模型」下拉列表是空的?
答:说明你当前启用的模型列表里没有任何被识别为 Embedding 类型的模型。去「设置 > 模型服务」里添加专门的嵌入模型(不要误选普通聊天模型),并在该模型的属性弹窗里勾选「嵌入(Embedding)」标签后再回来创建。
问:知识库建好后,把生成向量用的那家 API Key 删掉还能继续检索吗?
答:不能。每次你提一个新问题,客户端都需要调用同一个嵌入模型把你的问题也算成同维度的向量,才能和本地存好的文档向量算余弦相似度。一旦更换嵌入模型,必须点击重建索引。
问:挂太多 MCP 服务器会不会让每次普通聊天都变贵?
答:会。只要你在当前会话输入框勾选启用了某个 MCP,它底下的所有工具名称和 JSON 参数说明都会随每轮对话作为系统上下文发送给大模型,白白消耗输入 Token。不用的 MCP 随手在输入框底部取消勾选即可。
问:国内没有外币卡怎么买谷歌账号或开通 Claude、ChatGPT 订阅,能开报销发票吗?
答:可在本站 谷歌账号购买页、Claude Pro 充值页 或 AI 会员充值总览 下单,支持支付宝、微信支付与 AlipayHK,会员升级提供无需交出密码的卡密自助兑换,企业采购支持开具国内增值税发票;实时价格与售后边界(掉订阅按剩余天数折退,封号不在质保范围)以商品页说明为准。
相关教程
- DeepSeek 接入 Cherry Studio 和 Chatbox:API Key 填写、模型列表与连通检测步骤
- MCP 是什么:Model Context Protocol 入门,以及在 Claude 里怎么用
- OpenAI API Key 怎么获取:创建密钥、项目权限与安全保管
- Gemini API Key 怎么获取:在 AI Studio 创建密钥、设置环境变量与安全限制
参考资料
- Cherry Studio 官方文档:模型服务商配置总览 — https://docs.cherry-ai.com/pre-basic/providers/providers
- Cherry Studio 官方文档:本地知识库创建与检索 — https://docs.cherry-ai.com/advanced-basic/knowledge-base
- Cherry Studio 官方文档:MCP 服务器环境与接入说明 — https://docs.cherry-ai.com/advanced-basic/mcp/overview
0 条评论
还没有评论,来抢沙发~