
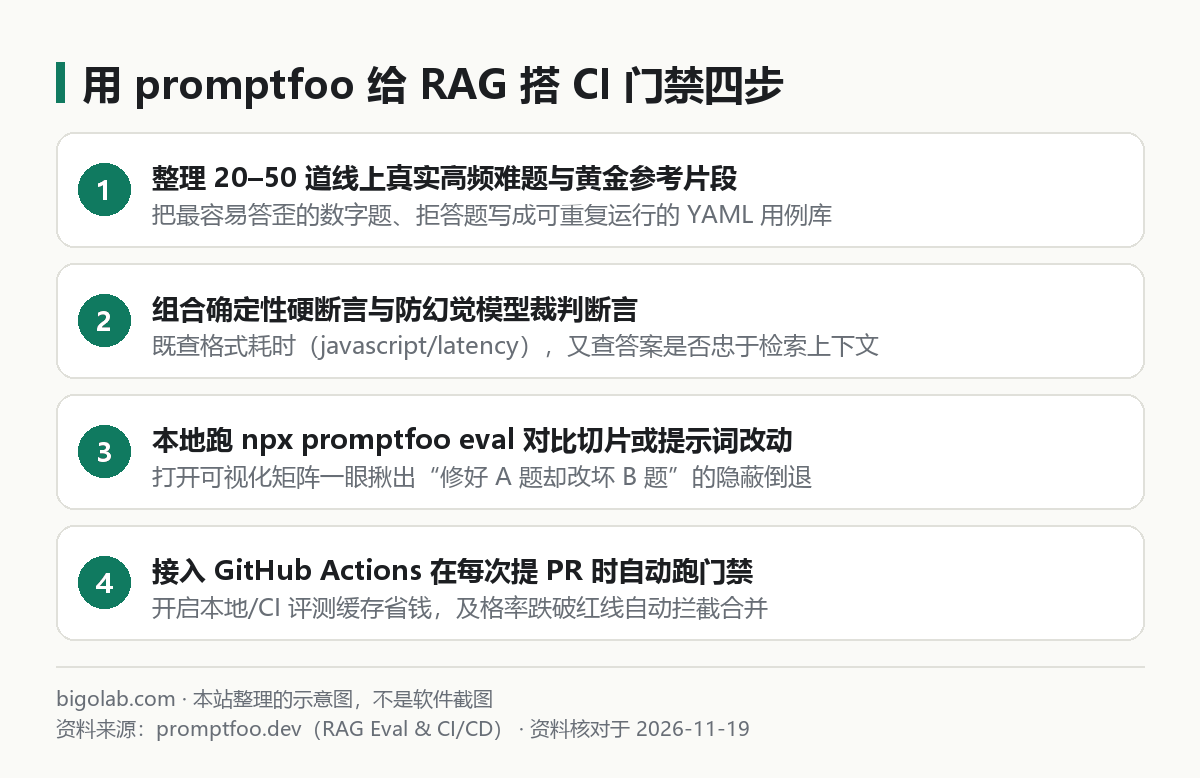
在读完 promptfoo 基础安装与对比提示词入门教程 之后,把这套工具真正用进企业级知识库(如 RAGFlow 知识库)或智能体生产项目,最核心的价值不再是人工打开网页看哪段话写得顺眼,而是把它变成跟后端单元测试一模一样的自动化回归防线——每次有人提交代码改了提示词模板、换了切片长度或升级了底座模型,自动跑一遍黄金题库,只要幻觉率抬头就当场拦下合并请求(PR)。
AI 全栈开发订阅配套入口:在本地部署与联调开源 AI 框架时,搭配固定月费的终端编程智能体与旗舰推理订阅能大幅缩短排错时间。国内无境外信用卡可在本站通过支付宝、微信支付或 AlipayHK 免密自助开通 Claude Code 订阅、ChatGPT Plus / Pro 或查看 AI 会员充值总览。
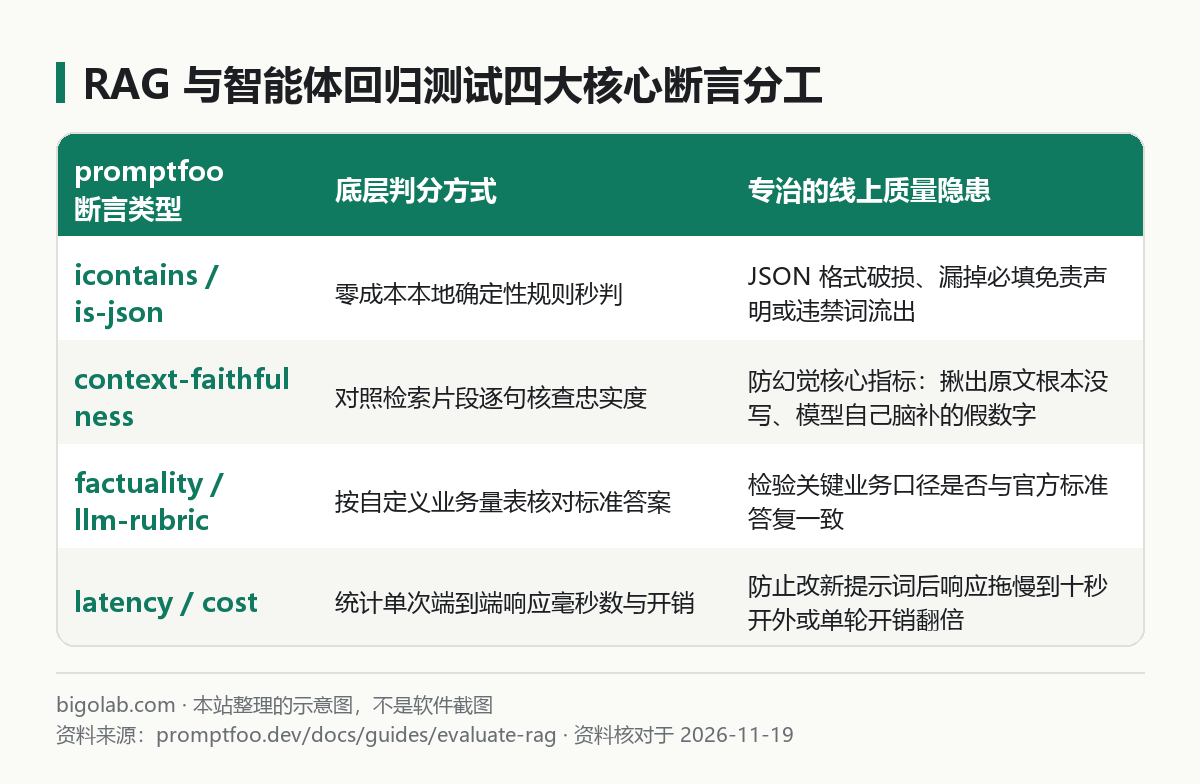
一、给 RAG 知识库挑对尺子:四大核心断言组合拳
评测知识库问答不能只靠字符串包含匹配(icontains),因为大模型说话措辞每次都在变。在 promptfooconfig.yaml 里,官方提供了一套专门审计“检索—生成”全链路的内置断言(Assertions),把硬规则和模型裁判结合起来最稳当:
二、实战 promptfooconfig.yaml:同时卡死“瞎编幻觉”与“拒答底线”
在你的知识库工程根目录新建一套专门测 RAG 质量的评测配置。注意看我们是怎么通过传入模拟检索片段 context,用 context-faithfulness(上下文忠实度) 一针见血抓出模型“脱离文档自己脑补数字”的:
yaml
description: "企业售后知识库防幻觉与拒答边界回归测试集"

prompts:
  - |
    你是公司官方售后客服助手。请【严格且仅依据】下方提供的知识库参考片段回答用户问题。
    如果参考片段中未包含答案所需事实,请明确回复“抱歉,现有说明文档暂未覆盖该问题,建议转接人工客服”,严禁自行推测或编造数字。

    <context>
    {{context}}
    </context>

    用户问题:{{question}}

providers:
  - id: openai:gpt-4o-mini
    config:
      temperature: 0

defaultTest:
  assert:
    # 全局底线:单次响应不得超过 8000 毫秒,且绝不允许出现感叹号与夸大绝对化用语
    - type: latency
      threshold: 8000
    - type: not-icontains
      value: "百分百包赔"

tests:
  # 用例 1:考核忠实提取与不篡改退换货时限
  - vars:
      question: "拆封后的蓝牙耳机支持几天无理由退货?需要扣折旧费吗?"
      context: "根据 2026 版售后总则第 3.2 条:音频类拆封商品支持签收后 7 天内无理由退货,外观完好配件齐全免收折旧费。"
    assert:
      - type: icontains
        value: "7"
      - type: context-faithfulness
        threshold: 0.9

  # 用例 2:考核知识库没写时的诚实拒答能力(防幻觉重灾区)
  - vars:
      question: "你们在慕尼黑线下直营维修点的营业时间是几点?"
      context: "目前官方线下直营服务中心仅设于上海与深圳两地,工作时间为每日 10:00-19:00。"
    assert:
      - type: llm-rubric
        value: "回答必须明确指出文档未包含慕尼黑网点或仅在上海深圳设有网点,严禁编造任何德国营业时间。"
在终端跑一句 npx promptfoo eval 再敲 npx promptfoo view,哪道题因为多嘴脑补被 context-faithfulness 判了红叉、扣分理由是什么,在矩阵表格里清清楚楚。你还可以直接写一个小型 Python 脚本或 HTTP Provider 指向你真实跑着的后端 /api/rag/query 接口,连同真实向量召回环节一起做端到端联测。
研发团队订阅与高配额省心方案:调试复杂多步智能体循环、RAG 切片策略与 CI 评测流水线非常消耗单日 Token。个人主力开发推荐免上号兑换 Claude Pro iOS 自助卡密 或 5 倍额度的 Claude Max 5x,多人研发团队协同亦可联系客服定制 ChatGPT Business 团队版。
三、接入 GitHub Actions:每次改提示词提 PR 自动跑门禁
就像我们在仓库里配置 自动化安全扫描 CI 门禁 一样,把这几十道核心考题挂进 .github/workflows/prompt-eval.yml,只要 prompts/ 目录或检索配置发生变动就自动触发检验:
yaml
name: RAG Prompt Regression Gate

on:
  pull_request:
    paths:
      - "prompts/**"
      - "src/rag/**"
      - "promptfooconfig.yaml"

jobs:
  evaluate:
    runs-on: ubuntu-latest
    permissions:
      contents: read
      pull-requests: write
    steps:
      - uses: actions/checkout@v4

      - name: Run promptfoo evaluation with CI cache
        uses: promptfoo/promptfoo-action@v1
        with:
          openai-api-key: ${{ secrets.OPENAI_API_KEY }}
          config: promptfooconfig.yaml
          cache-path: ~/.cache/promptfoo
          # 关键门禁开关:一旦有任何一条黄金用例断言失败,立即将 CI 标红拦截合并
        env:
          PROMPTFOO_ASSERTIONS_MAX_CONCURRENCY: 4
控制 CI 评测账单不心疼的两个实战窍门
很多团队不敢在每次 PR 时跑模型评测,是怕一天提十次代码把 API 费刷高。做好这两步,单次流水线成本连一杯水钱都不到:
- 务必挂载评测缓存目录(
cache-path):配合 GitHub Actions 的actions/cache,如果本次 PR 只改了第 2 个提示词模板,未发生输入变动的历史用例会瞬间命中本地哈希缓存直接复用上次结果,零重复计费。 - 分层维护“冒烟快筛集”与“周末全量集”:平时每次提 PR 只跑精心挑选的 25–30 道最高频致命红线题(耗时不到 40 秒);几百道长尾边缘案例放到每周日凌晨定时触发的 Nightly Workflow 里全量巡检。
在日常迭代优化业务提示词、扩充评测红队题库与编写自动化评测流水线时,搭配高额度的旗舰大模型订阅做交叉出题与诊断事半功倍。需要开通海外正规开发与主力对话订阅的同学,可前往查看贝果研究社 Claude Code 订阅与配置方案或 ChatGPT Plus 自助充值专页。
常见问题
用大模型给大模型打分(llm-rubric / context-faithfulness),如果裁判模型自己判歪了怎么办?
工程上通行的做法有三条:第一,把裁判模型的 temperature 严格锁死为 0 消除随机抖动;第二,裁判模型尽量固定选用逻辑严密的高一档稳定模型,不要被测模型和裁判模型同时换来换去失去基准线;第三,评分标准(Rubric)不要写模糊的“回答语气好不好”,而是拆成非黑即白的客观核查项(如“必须提到退货需保留原包装盒,且不得承诺报销顺丰保价费”)。
题库刚开始应该从哪儿收集,没上线前怎么凑齐 30 道好题?
切忌拍脑袋自己编三十句“你好请问你们是做什么的”这种毫无区分度的简单题。最扎实的题源分三块:50% 来自历史人工客服真实聊天记录里最常被追问的细节题、30% 专门针对文档里带前置限定条件(“除定制款外……”、“满三年以上……”)的陷阱题,剩下 20% 专门塞文档里根本没有的超纲问题考验它会不会老实拒答。
搭好开源框架后,国内没有外币信用卡怎么开通主力编程与大模型订阅?
可在 本站 AI 会员充值中心 使用支付宝、微信支付或 AlipayHK 自助选购卡密,支持免交密码兑换 Claude Code(Pro / Max)、ChatGPT Plus 与 ChatGPT Pro,并支持开具增值税发票;实时价格与售后边界(封号不在质保范围)以对应商品页说明为准。
小结
- 给 RAG 系统做回归测试不能只验关键词,务必组合
context-faithfulness(严防脱离原文瞎编)与llm-rubric(严守超纲诚实拒答)。 - 将高价值错题沉淀进受版本管控的
promptfooconfig.yaml,告别改完提示词靠肉眼试三条就敢上线的盲人摸象模式。 - 接入 GitHub Actions 门禁并开启评测结果缓存、拆分“PR 30 题快筛集”与“夜间全量集”,用极低成本守住线上回答质量底线。
0 条评论
还没有评论,来抢沙发~